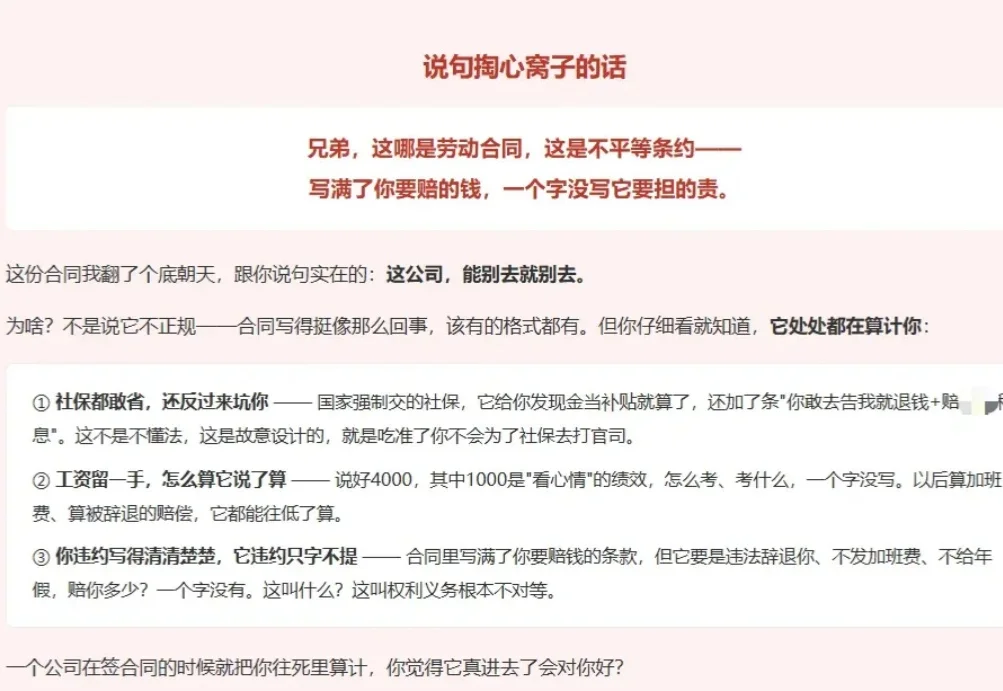
第一批重金找FDE的县城老板,被坑惨
第一批重金找FDE的县城老板,被坑惨AI改造的风,从大厂一路吹到县城,吹进那些急于转型的小公司。
来自主题: AI资讯
6327 点击 2026-11-02 16:19

 搜索
AI改造的风,从大厂一路吹到县城,吹进那些急于转型的小公司。
AI江湖的名头换了一茬又一茬:AI四小龙、大模型六小虎……
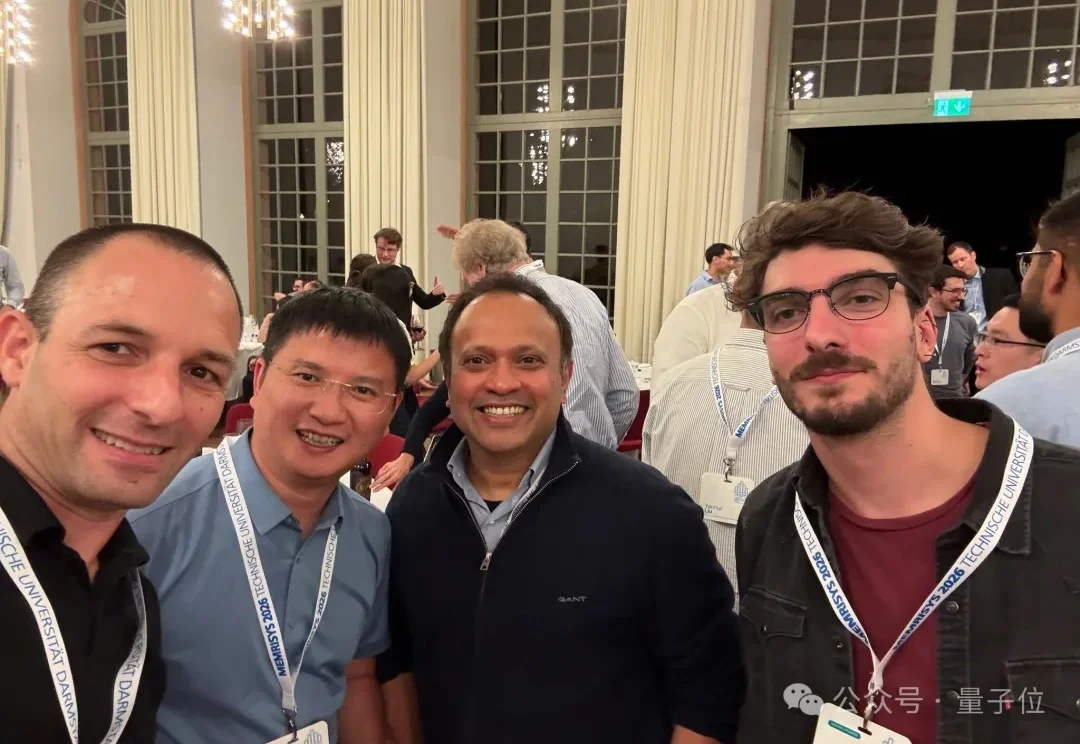
人类用了两千年的模拟计算,开始被重新定义了。
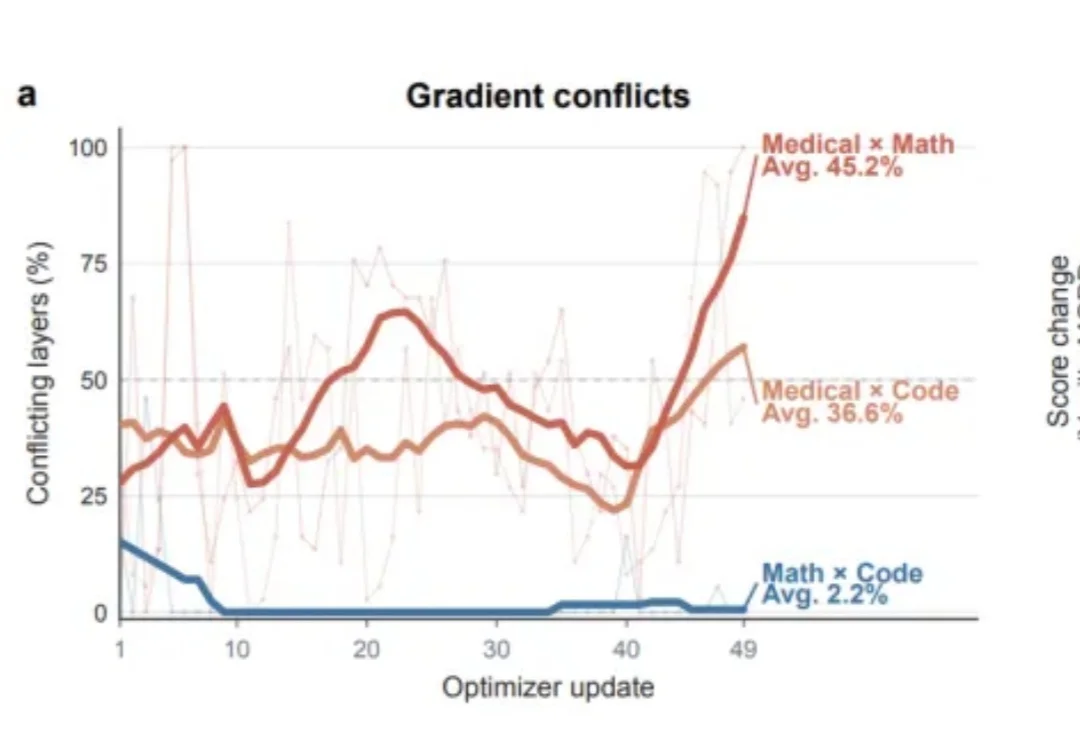
数学题交给数学老师,代码题交给代码老师,医学题交给医学老师。把各有所长的专家请到一起,就能让同一个小模型学会多种能力吗?
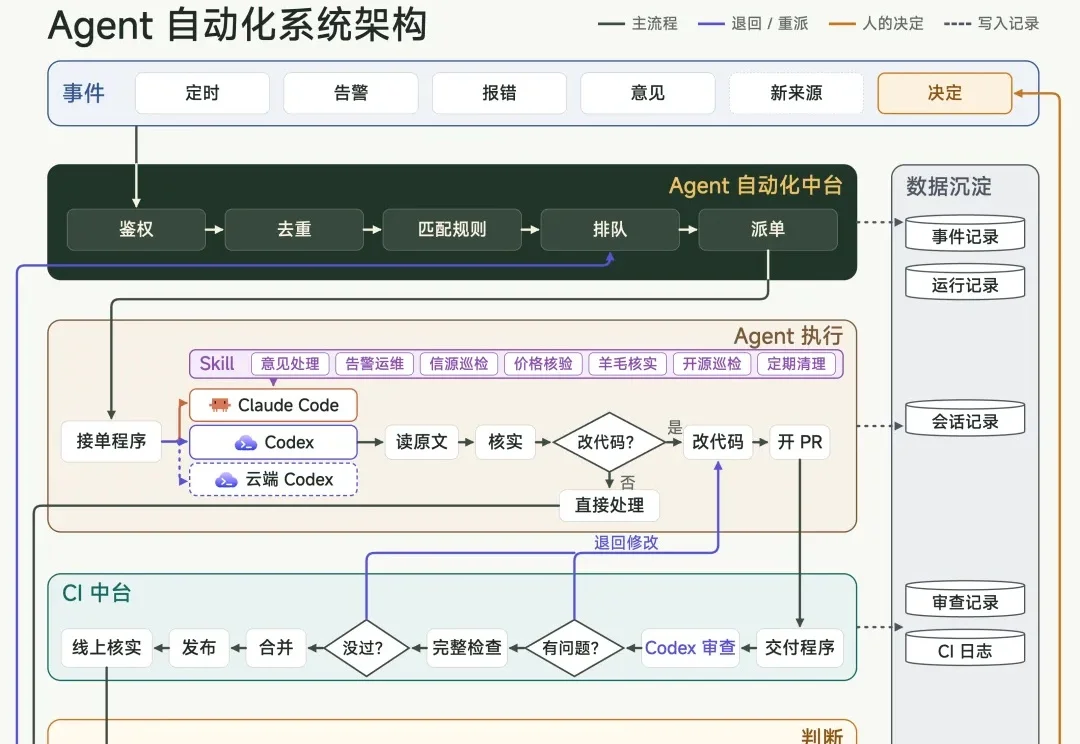
上周六的时候,DeepSeek发了他们一篇很长的技术文章,叫《Super-agent设计探索:迈向更自主的Agent系统》,细细读完了,非常棒的架构,对很多开发者来说,都非常非常值得学习。
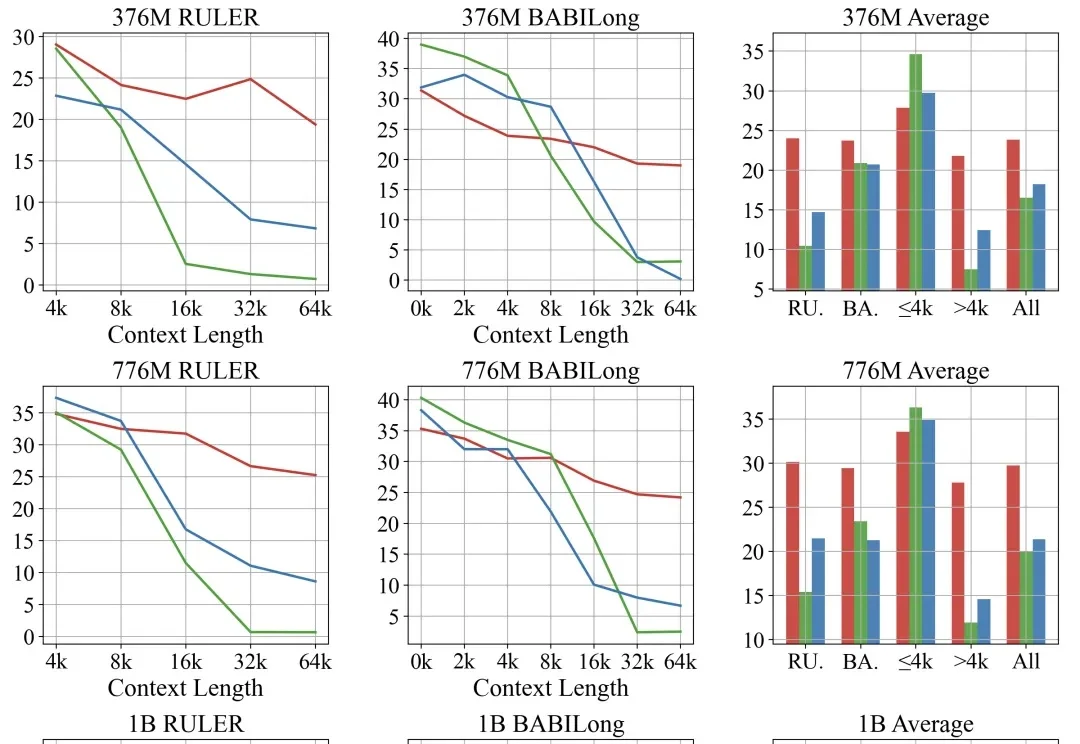
长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。
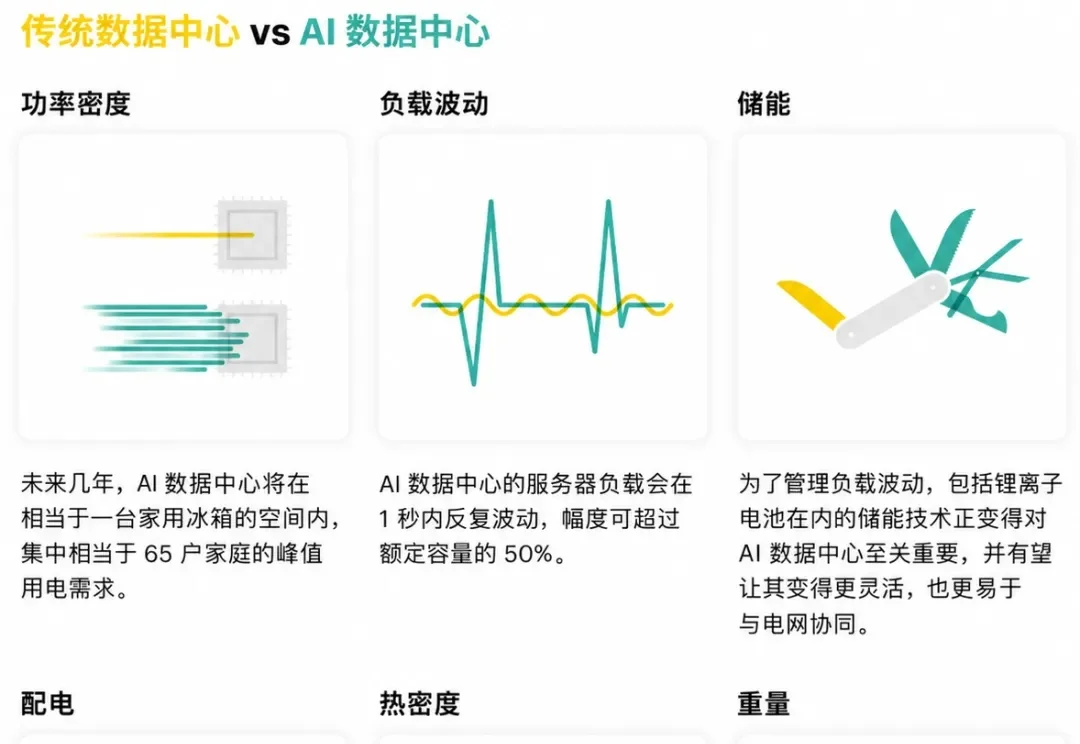
一个冰箱大小的服务器机柜,重量超过一辆皮卡;到 2027 年,它的峰值功率将相当于 65 户家庭同时用电;为了不让它烧掉,每个机柜需要排出的热量相当于 30 台燃气锅炉。
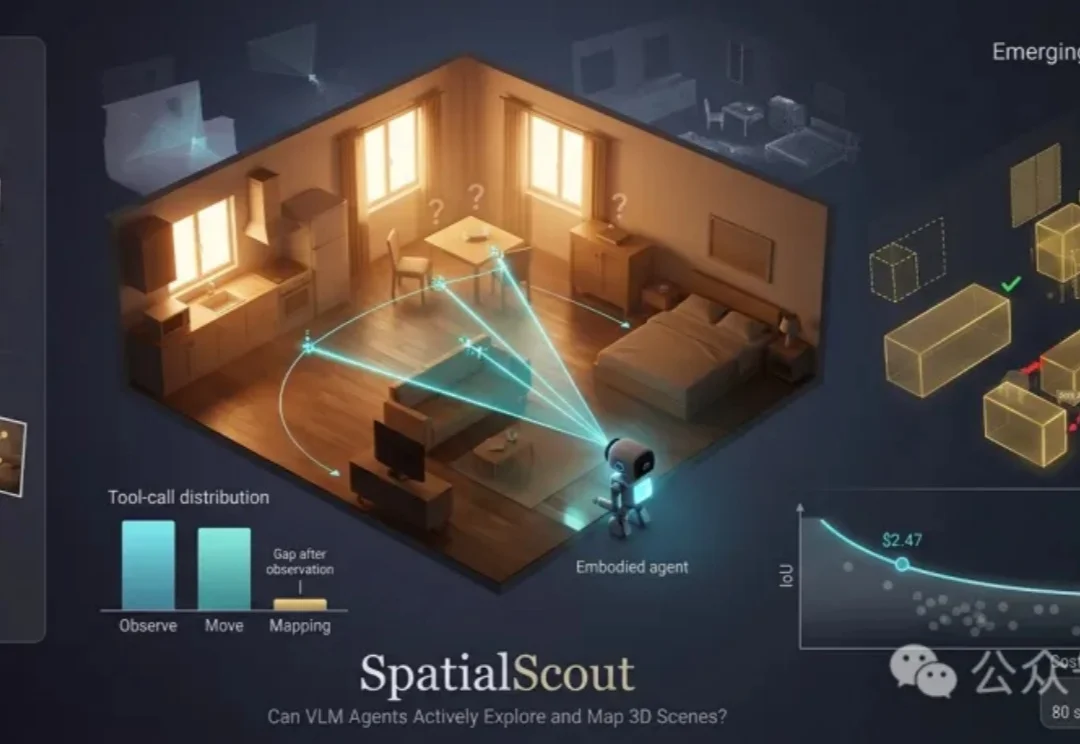
想象一项任务:把相机交给AI,让它进入一间从未见过的虚拟房间。没有预先给定的物体坐标,也没有替它安排好的参观路线。它需要决定朝哪里转、向哪里移动、何时再拍一张图,并最终说清楚各个目标物体在三维空间中的位置。
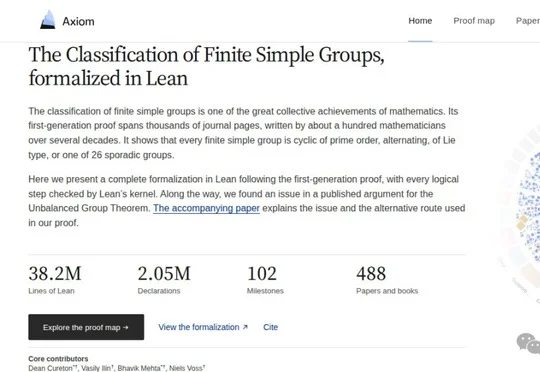
Axiom的AxiomProver用24天将有限单群分类定理(CFSG)形式化,生成4310万行Lean代码,并发现34处重大逻辑偏差、修补不平衡群定理漏洞及证明新定理。
a16z在《State of Markets》报告及官方播客中指出,AI相关公司已占美国VC交易活动的86%,超大规模厂商资本开支激增,而模型与应用采用率仍低,AI投资周期尚处早期。