把记忆交给CPU,大模型会变快
把记忆交给CPU,大模型会变快拿Agent做Coding,想必大家都已经很熟悉了。
来自主题: AI资讯
9908 点击 2026-09-16 14:40

 搜索
拿Agent做Coding,想必大家都已经很熟悉了。
高通提前剧透下一代骁龙旗舰移动平台的核心升级:Oryon CPU首次实现5GHz主频并引入动态缓存架构FlexCache,Hexagon NPU推出Element Accelerator与更大共享内存,Adreno GPU首次加入Matrix Cores并集成AI图形渲染技术Adreno Neural Fusion,全面强化端侧智能体AI性能与体验。
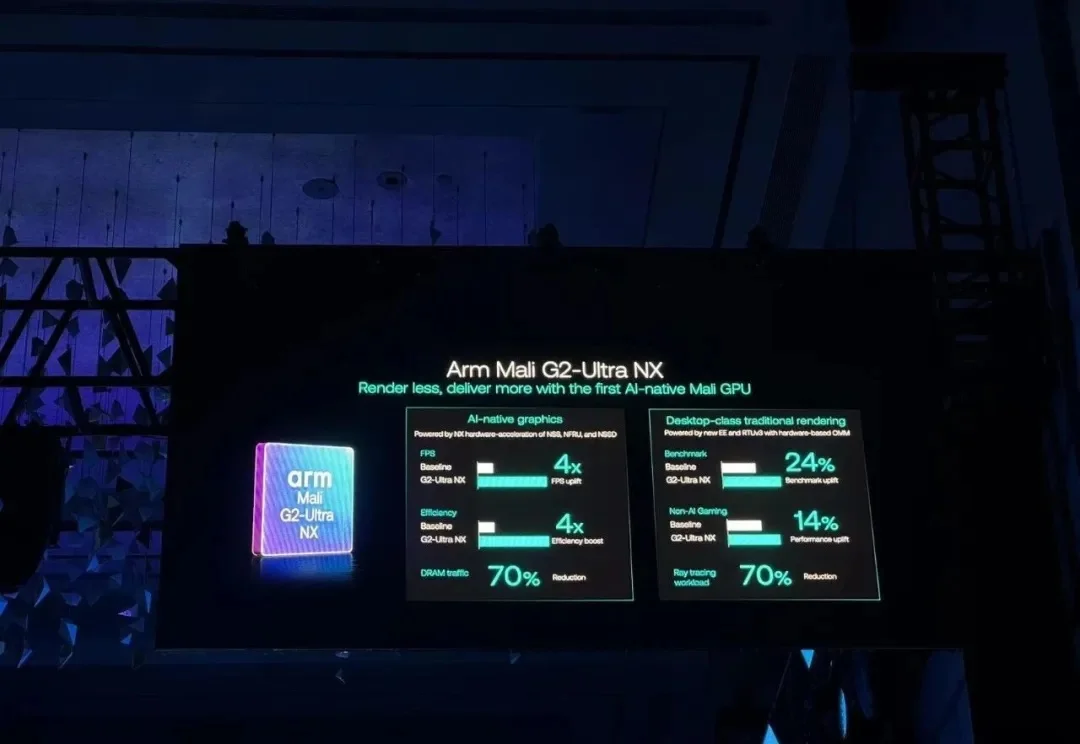
以后手机GPU渲染游戏画面,不用再吭哧吭哧把每个像素都算出来了。
谷歌Antigravity团队公布Teamwork多智能体编排框架成果,轻量级Gemini 3.7 Flash复现了Gemini 3.1 Pro解出的3道博士级数学难题,并从零构建RISC-V CPU模拟器、改进Eigen和ParlayHash开源库代码,证明小模型通过制度化博弈编排也能完成顶尖科研与工程任务。
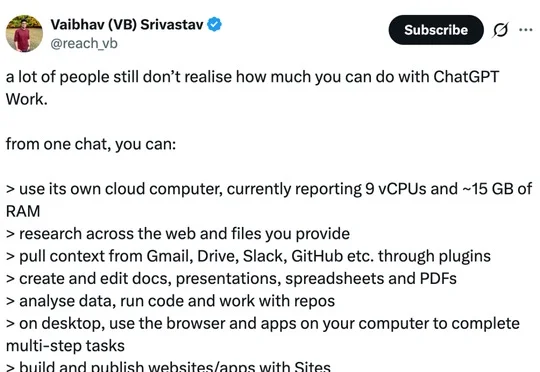
ChatGPT Work于8月25日上线云浏览器登录功能,背后的云电脑配有约9个虚拟CPU和15GB内存,可在网页和手机端自动登录网站处理订狗粮、保险报销等任务,而密码对AI不可见,标志着该智能体首次跨越登录墙真正替用户办完事。

2026 年 5 月 31 日,英伟达(Nvidia)宣布一颗拥有 88 个定制核心的 CPU 已经进入全面量产。它叫 Vera,采用 Arm 指令集和英伟达自研的 Olympus 核心,既会进入 Vera Rubin 超级计算平台,也会被单独装进 CPU 服务器。戴尔、惠普、联想、超微以及多家服务器厂商,已经开始制造搭载 Vera 的系统。

Cloudflare 用 12 周从零写了一个浏览器。Rust 编写,跑在自家的 Workers 边缘网络上,内存占用最多比 Chromium 省 7 倍,专给 AI agent 用,beta 期免费。名字叫 Kitesurf。官博和推文里反复念叨同一句话,Chromium 太沉了,没法给每个 agent 都发一个。

在“灵晟”国产超算登顶最新一期全球超级计算机TOP500榜单后,清程极智与“灵晟”联合完成纯CPU MoE模型分布式推理方案:16节点即可流畅运行DeepSeek-V3/R1-671B模型,在batch_size=2048时,输出吞吐量与80张主流GPU集群相当。

一块 8.24GB 内存的 CPU,一个 2.78 万亿参数的大模型,甚至不需要显卡,Kimi K3 就这么水灵灵地跑起来了。

刚刚,SpaceX 宣布正与英伟达达成合作,共同设计 Starmind AI1 卫星计算载荷。每颗 Starmind 卫星都将搭载 NVIDIA Rubin GPU 和 Vera CPU,把接近数据中心级别的算力部署到太空。