千万token下,比DeepSeek式稀疏注意力再快22倍
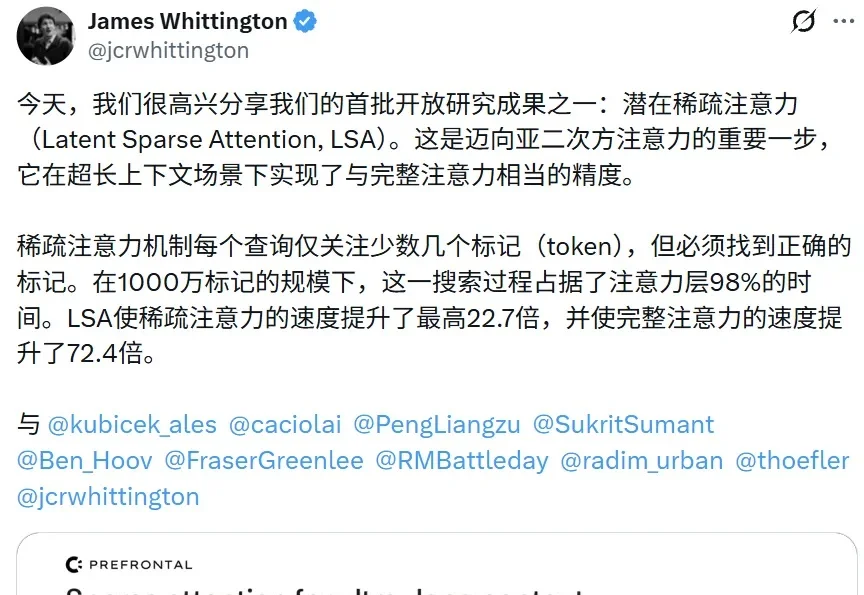
千万token下,比DeepSeek式稀疏注意力再快22倍如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。
搜索
如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。
给“机器人战场”建立新坐标。
DeepSeek手机App因算力不足暂停超过72小时的长对话,官方尚未说明;同期其开放全家桶应用API并开源chat-demo,文章认为梁文锋正推动DSH转向Agent操作系统与插件生态,但仍受算力、审核和变现机制制约。
成本暴降95%。
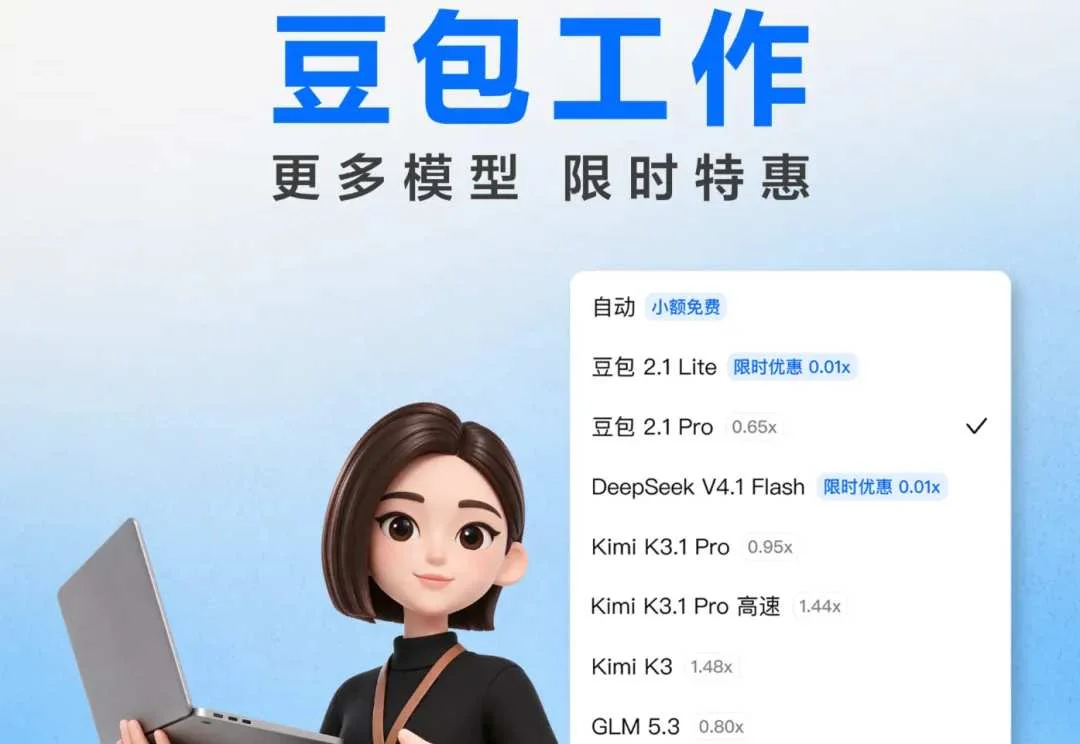
Claude 账号被封后,作者实测豆包工作和腾讯 WorkBuddy 处理人物稿、日历、销售报表及 PPT,认为豆包工作更省额度,并可先用 DeepSeek V4.1 Flash 找资料、再用 Kimi K3.1 Pro 写稿以降低成本。
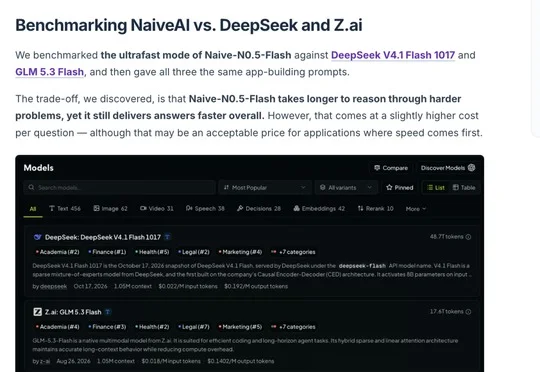
Latent Space实测显示,NaiveAI开源模型Naive-N0.5-Flash综合能力介于DeepSeek V4.1 Flash 1017与GLM 5.3 Flash之间,编程单项评测反超,峰值速度约2100 Token/s,3D太阳系任务表现最佳。
阿里云 AgentCore 支持以配置化托管、自定义镜像或纳管方式接入 DeepSeek Harness(DSH),统一提供身份、凭证、网络、观测与治理能力,加速企业生产化验证。
DeepSeek 正式开放全家桶 API,V4.1-Flash(deepseek-flash)支持联网搜索、文件解析、链接阅读、语音交互及 Search、Fetch、OCR、ASR、TTS 独立调用,并开源聊天应用 Demo,降低开发者打造个性化超级 App 的门槛。
继向企业客户开放第三方模型后,豆包工作进一步扩大了用户的模型选择范围。
深度对话DSH-Go作者。