硅谷今日最热具身模型!不用后训练,看一遍就学会
硅谷今日最热具身模型!不用后训练,看一遍就学会刚刚,北美具身初创Skild AI又发布了全新机器人基础模型S1,直接把机器人上下文学习的任务长度拉到了10分钟往上。这次的S1主打上下文学习(in-context learning,ICL):无需在后训练阶段专门学习新的操作数据,只需看一段人类示范视频,就能“照猫画虎”,直接完成一整套从未见过的复杂操作流程。
来自主题: AI资讯
9883 点击 2026-08-27 10:14

 搜索
刚刚,北美具身初创Skild AI又发布了全新机器人基础模型S1,直接把机器人上下文学习的任务长度拉到了10分钟往上。这次的S1主打上下文学习(in-context learning,ICL):无需在后训练阶段专门学习新的操作数据,只需看一段人类示范视频,就能“照猫画虎”,直接完成一整套从未见过的复杂操作流程。
阿里AI办公领域,再落一子。
现在的 Agent 将所有的工程线索和垃圾噪音都一股脑扔进 Chat Context 里,缺乏一层独立、结构化的 Engineering State 来做隔离与控制。为了打破这个瓶颈,Valkor 联合浙江大学智能计算与软件研究中心、伦敦大学学院(UCL)软件工程团队正式推出并开源了 loom。
在计算历史的绝大部分时间里,编程的本质是一项翻译工作:开发者需要在人类理解的维度上剖析问题,设计抽象方案,随后将其转译为机器能够执行的语法。当前的软件工程领域正在经历自高级编程语言问世以来最为显著的变化。
本篇文章根据我在本月 43 Talks 线下活动中的分享整理而成。主理人李继刚邀请我时,给的主题词只有一个:Context。我想从 Agent 的视角出发,讨论一个判断:随着模型和 Harness 逐步趋同,真正决定 Agent 能力边界的,会越来越是 Context。
近日,穗升科技首款产品Memoket在海外正式开启预售。这是一款AI Memory可穿戴硬件,仅11克,分表带款和手环款两种形态,待机超过30天,连续录音续航20小时。它可以将物理世界中所听到的信息结构化,需要时调给Agent,实现跨时间聚合和Context(上下文)串联。
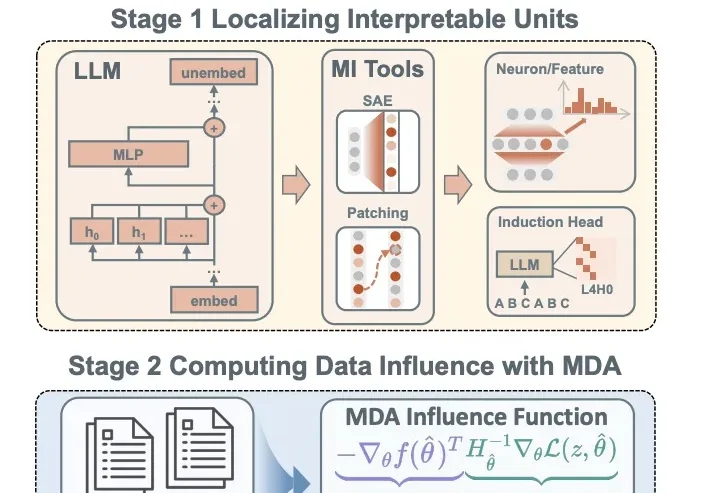
近年来,大语言模型展现出了越来越强的能力,从上下文学习(In-Context Learning, ICL)到复杂推理、代码生成,这些能力不断刷新人们对模型能力边界的认知。
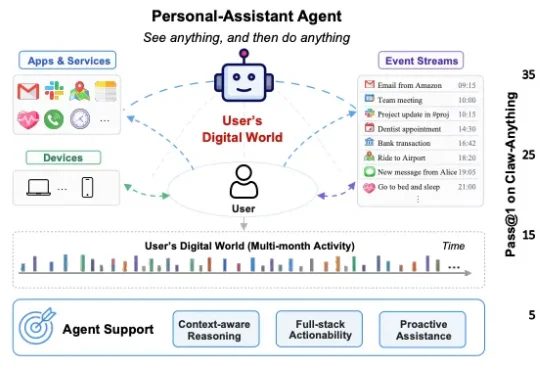
我们相信,常驻型 (always-on) AI 助理的下一次飞跃,不在于把某一个模型单点调得更聪明,而在于扩展智能体的上下文 (Scaling Agent Context)—— 不断拓宽助理能够持续 "感知 — 推理 — 执行" 的范围,作为生活连接器连接用户的信息孤岛,直到它能接管用户的整个数字世界。
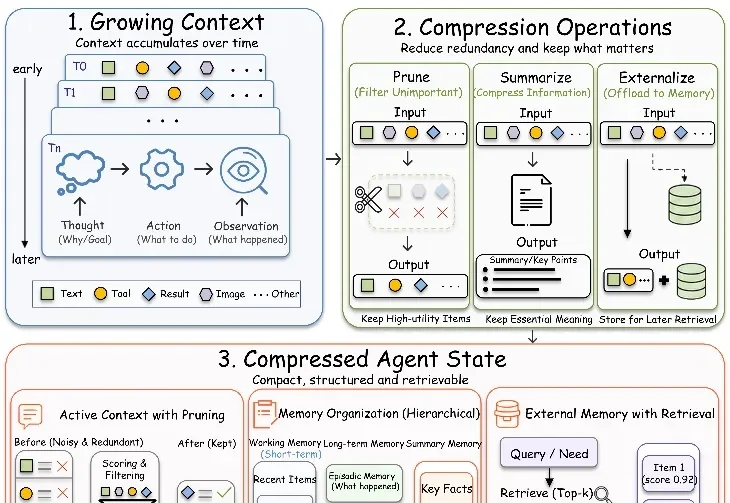
LLM Agent 做长任务时,真正让人头疼的往往不是模型不会推理,而是上下文开始失控:前几步还很清楚,后面就忘约束、丢状态、重复试错,最后把任务跑成事故现场。
除此之外,context-mode 将大模型的记忆力从30分钟提升至 3 小时。