开源个 Skill|彻底解决小红、小绿书配图难题
开源个 Skill|彻底解决小红、小绿书配图难题前段时间开源了 guizang-ppt-skill,之后我自己用它做内容的时候发现一件事。
来自主题: AI技术研报
7684 点击 2026-05-28 11:25

 搜索
前段时间开源了 guizang-ppt-skill,之后我自己用它做内容的时候发现一件事。

省心即价值。
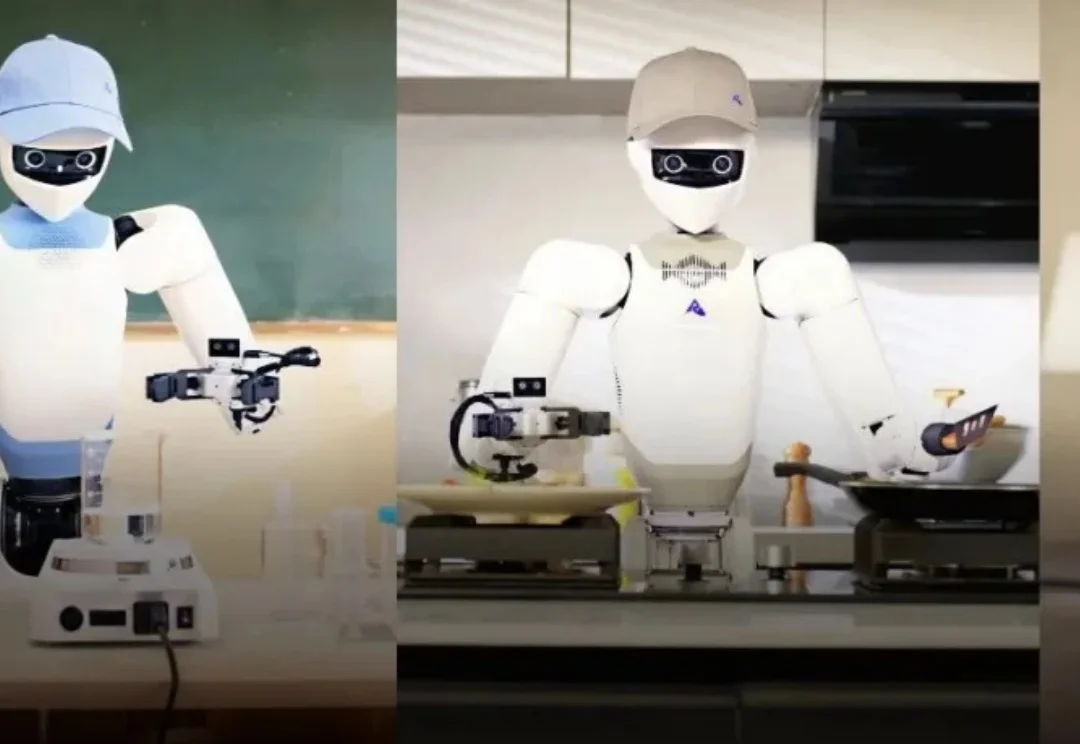
8.99万元操作天花板,6月发货,具身智能的「苹果时刻」!中国版Figure,星尘智能自研「AI模型-具身OS-绳驱本体」三位一体架构,用击穿底线的定价,推动Physical AI落地。一句话:今年必Buy!
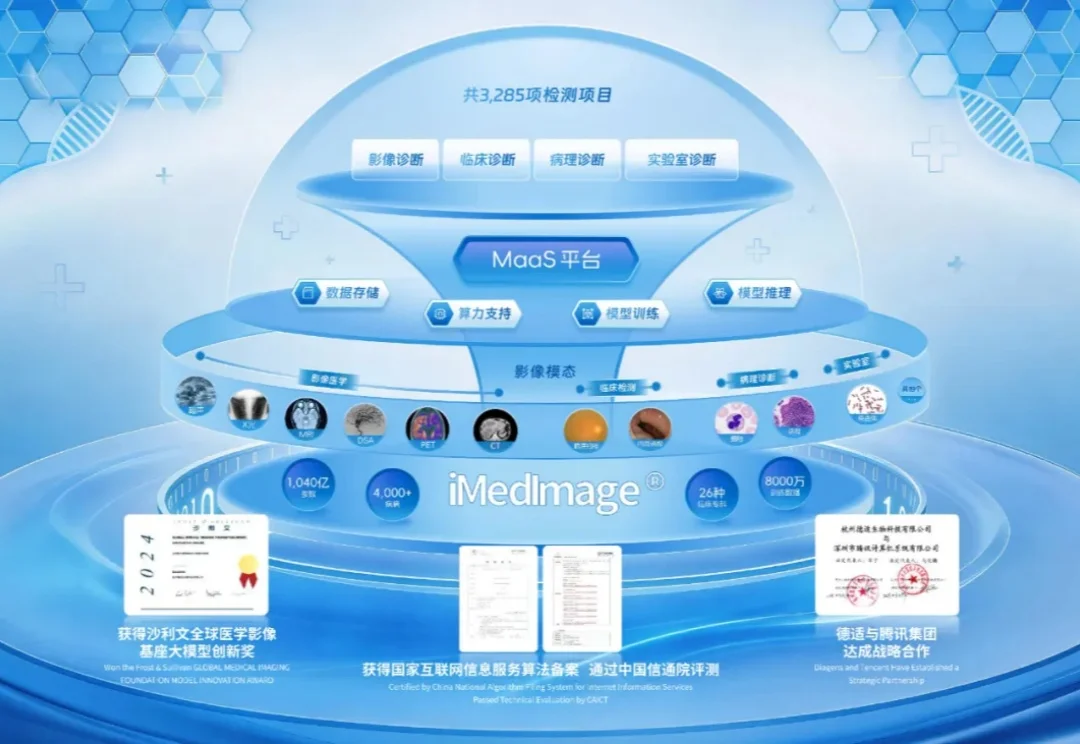
德适AI获三类医疗器械证,医疗AI产业化迎来新突破。
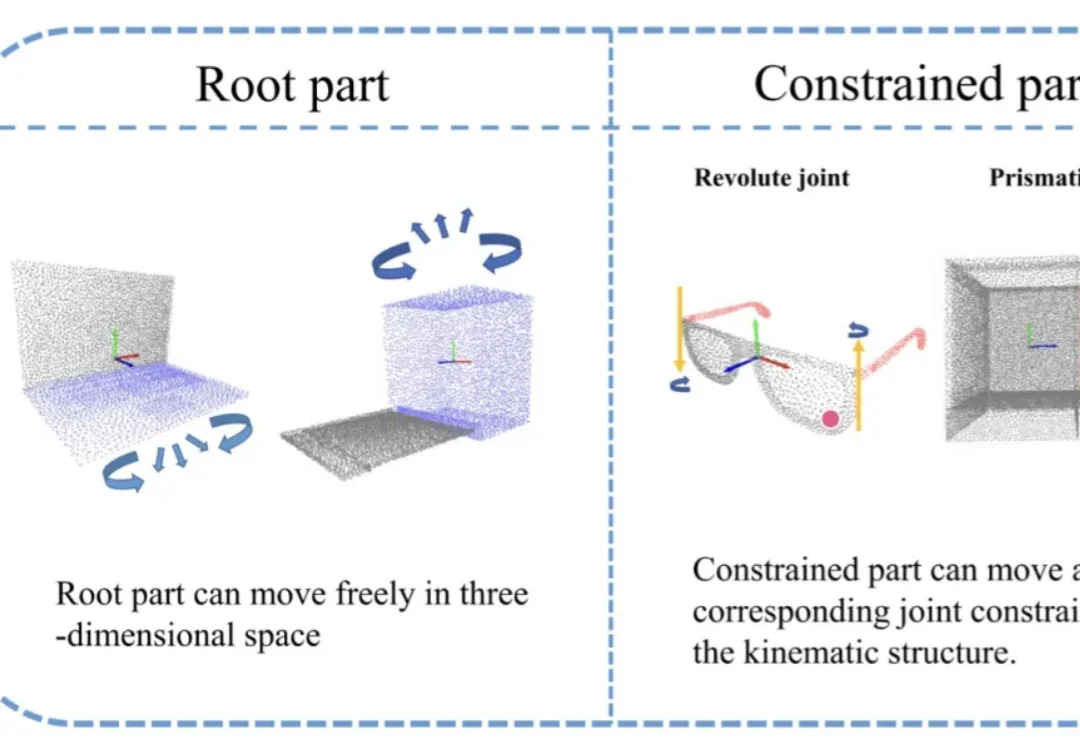
在具身智能快速发展的今天,机器人已经不再满足于「看见」刚体物体,而是开始真正走向复杂环境中的交互与操作。从机械臂开柜门,到服务机器人整理抽屉,再到工业场景中的工具操作,大量真实世界目标都属于关节物体(Articulated Objects)。
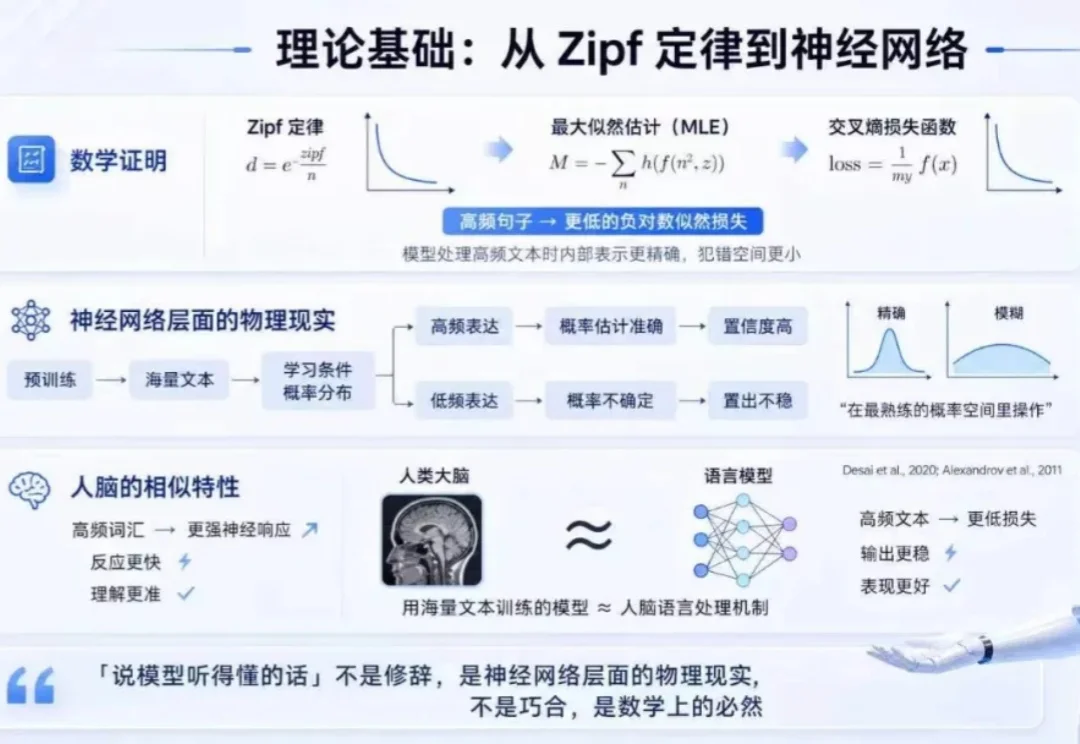
你有没有想过,我们每天用的 AI 大模型,可能在某些词汇上天生就有缺陷?不是因为训练数据不够,不是因为算力不足,而是因为语言本身的规律——那些用得少的词,模型就是学不好。更让人意外的是,这个问题早在 2025 年就被一家中国创业公司系统性地发现并解决了。
就在几天前(5月22日),DeepSeek官方扔出了一枚重磅炸弹:DeepSeek-V4-Pro将在5月底结束优惠后,永久降价至原价的四分之一。各大媒体瞬间被诸如“白菜价”、“夯爆了”的标题刷屏。看看这组惊人的新定价:每百万Token输出6元,输入(缓存未命中)3元,而输入(缓存命中)仅仅只要0.025元!
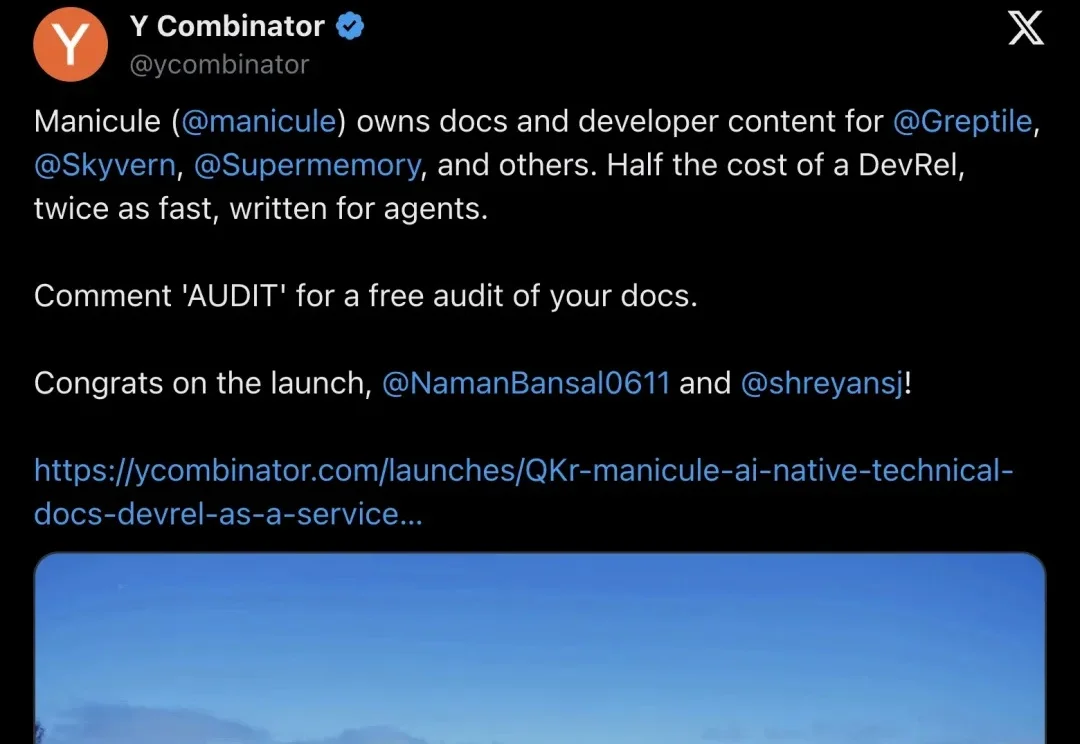
YC 官方账号亲自下场推了一家叫 Manicule 的公司——专门给开发者工具团队承包技术文档和 DevRel 内容,核心卖点:成本只要 DevRel 的一半,速度快一倍,而且文档专门为 AI agent 优化。当 Codex、Claude Code 这些编程 agent 开始直接读你的 docs 来调 API,文档质量差就等于把客户拱手让给竞品。
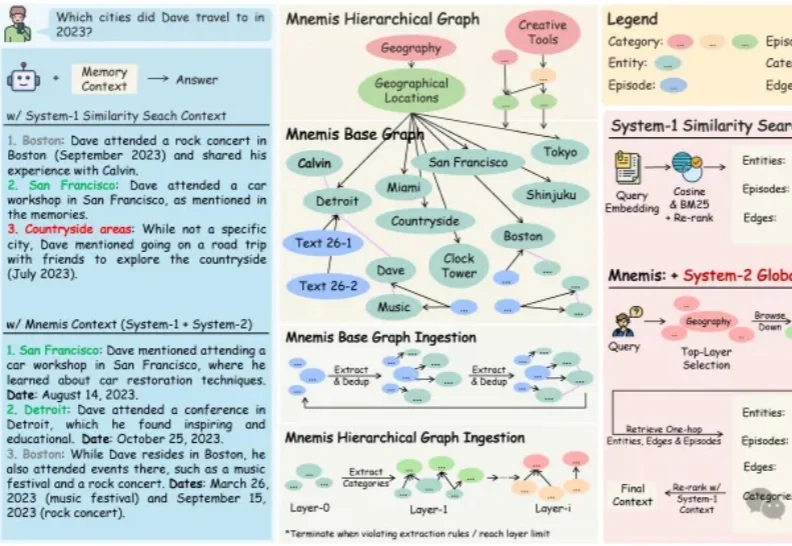
随着大语言模型在各类应用中加速落地,一个核心技术瓶颈日益凸显——AI始终缺乏真正的长期记忆能力。当前主流的RAG(检索增强生成)方案依赖语义相似度检索历史信息,但“语义相似”并不等于“真正相关”,常常出现检索结果不完整、无法区分信息相关性、缺乏推理能力等问题。
GPT-5.5被扒出「假思考」,用两小时就被偷偷换成mini,200美元月费买了个「薛定谔的脑子」。Trace命令实锤,官方文档亲自认领。往后有纷纷吐槽:OpenAI,你糊弄谁呢?