词元(Token),为何重要?单人最高3000万额度,国家超算互联网启动词元赠送
词元(Token),为何重要?单人最高3000万额度,国家超算互联网启动词元赠送国家超算互联网宣布启动新一轮词元赠送活动。该活动面向平台全体用户,限时免费发放单人最高3000万词元额度,以降低科研专属“龙虾”SClaw等智能体体验门槛。此外, 超算互联网用户享0.1元/百万Tokens的特惠续用价,将延至4月6日。
来自主题: AI资讯
8708 点击 2026-03-26 10:55

 搜索
国家超算互联网宣布启动新一轮词元赠送活动。该活动面向平台全体用户,限时免费发放单人最高3000万词元额度,以降低科研专属“龙虾”SClaw等智能体体验门槛。此外, 超算互联网用户享0.1元/百万Tokens的特惠续用价,将延至4月6日。
Token正在重塑AI时代的价值坐标,它是效率革命的引擎,还是成本失控的暗礁?本期将从Token降本的视角,透视AI时代"新石油"的经济逻辑。
你以为AI答错就一定是幻觉?不,它也可能是在故意骗你。
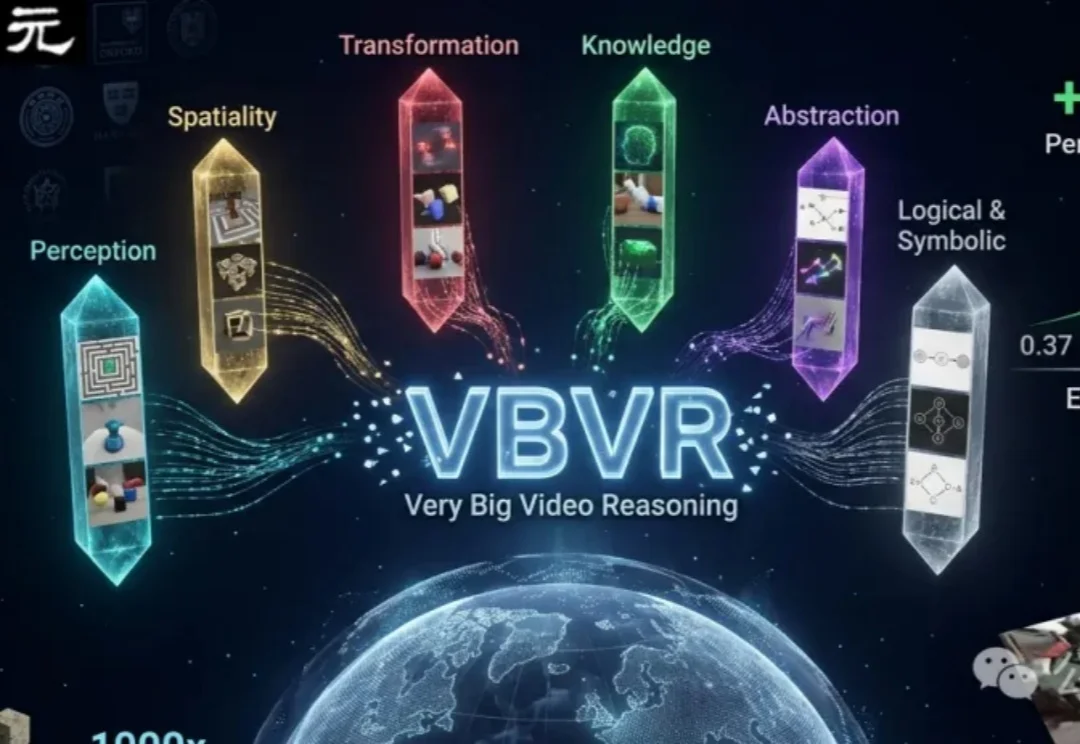
AI视频生成已能「画得像」,但不会「想得对」。VBVR推出百万级视频推理数据集,首次系统评测模型对空间、物理、逻辑和抽象的推理能力,发现顶尖模型通过率仅68%,暴露其缺乏真实认知,推动视频AI从「视觉模仿」迈向「智能推理」。
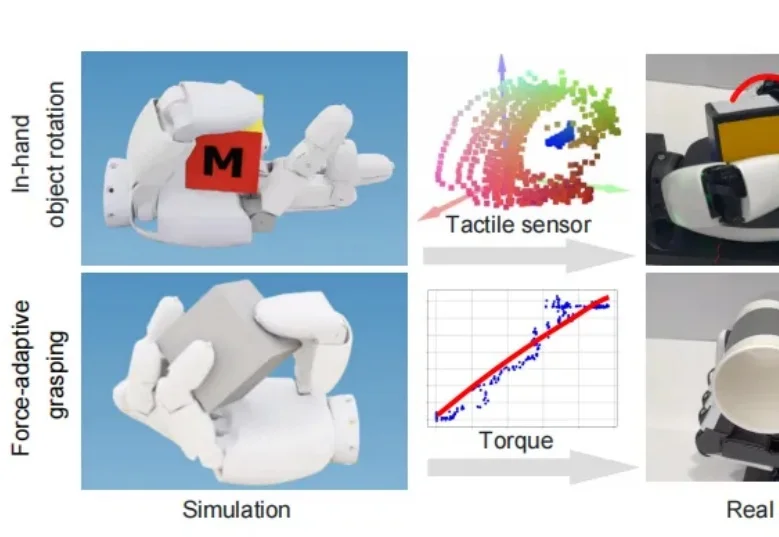
实现具备人类水平的灵巧操作能力,是机器人学领域长期以来的核心挑战之一。尽管多指灵巧手在硬件上具备了类似人类的潜力,但由于接触丰富的物理特性和非理想的驱动机制,训练能够直接部署在真实硬件上的控制策略仍然非常困难。
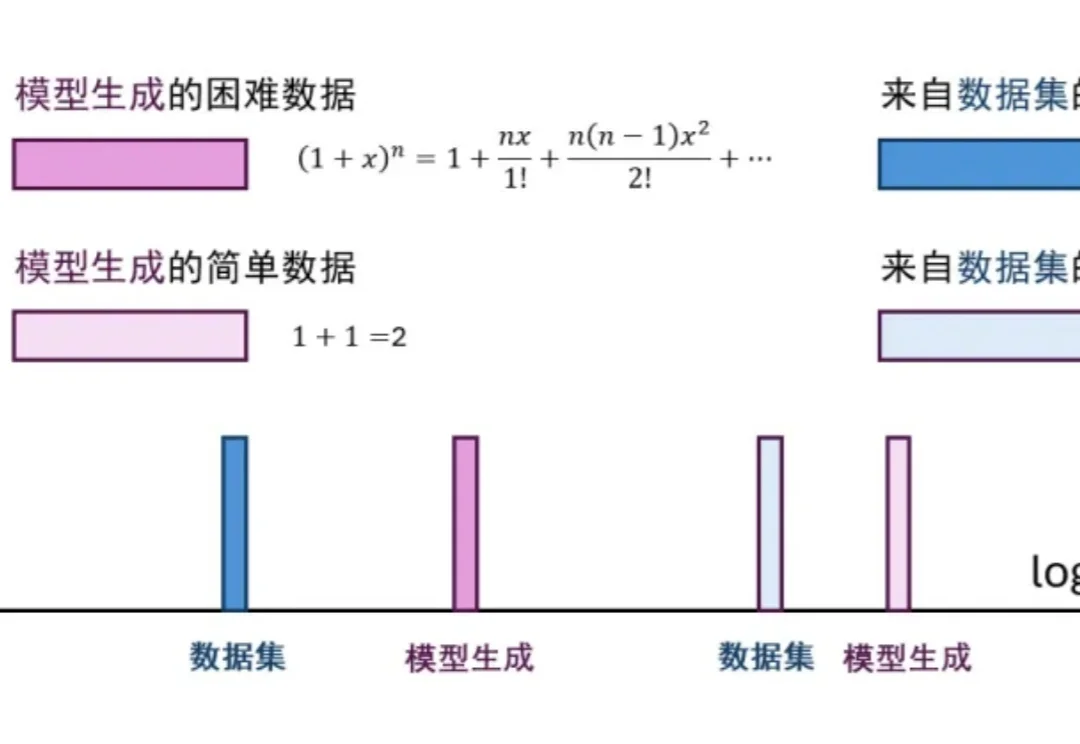
在大模型后训练阶段,监督微调(SFT)和强化学习(RL)是两根不可或缺的支柱。SFT 利用高质量的离线(Off-policy)数据快速注入知识,但受限于静态数据分布,泛化能力往往容易触及天花板并带来灾难性遗忘;RL 则允许模型在探索中不断自我迭代,产生与当前策略同分布(On-policy)的数据,上限极高,但往往伴随着训练极度不稳定、计算资源消耗巨大的痛点。
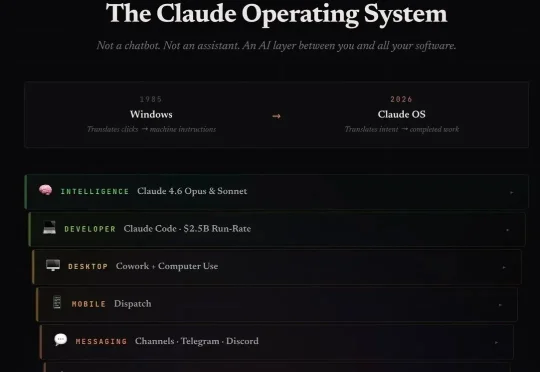
Anthropic的野心曝光了!有人分析称:他们在悄然打造一个AI操作系统,意图统治全球数字生态,做一个统治一切生态的龙虾大脑!这背后,剑指的就是苹果微软的6.4万亿帝国,而OpenAI甚至还排不上号。

当你以为🦞还是大家伙业余养养的新鲜玩具,已经有公司正经在招「龙虾官」了。(doge)先来看看名头看上去最大的一类——CCO(Chief Claw Officer,首席龙虾官)。

Siri 要有自己的独立 App 了。

养微信「龙虾」,官配的最好!WorkBuddy丝滑适配,扫码一键直连。无论身处何处,手机一句话,便能使唤AI 7x24h打工。 全网等了很久的那一天,终于来了!