不卷速度卷验证,陈天桥MiroMind精准预测15天后黄金价格
不卷速度卷验证,陈天桥MiroMind精准预测15天后黄金价格一睁眼!陈天桥带队的大模型黑马MiroMind再度满血归来—— 正式发布新一代重型推理智能体:MiroThinker-1.7和MiroThinker-H1。
来自主题: AI资讯
7008 点击 2026-03-16 15:11

 搜索
一睁眼!陈天桥带队的大模型黑马MiroMind再度满血归来—— 正式发布新一代重型推理智能体:MiroThinker-1.7和MiroThinker-H1。
中国教育界的OpenClaw来了!刚刚,清华教育学院、计算机系联合团队正式开源多智能体AI课堂OpenMAIC:AI老师语音授课,AI同学举手讨论,交互式课程一键生成。
最近AI圈又多了一张硬核通行证,Anthropic刚刚在官网发布了Claude首个AI架构师认证。
多模态模型代码写得像老司机,却在数手指、量柱子时频频翻车?UniPat AI用五百行代码打造的SWE-Vision,让模型「掏出Python尺子」自我验证,一举拿下五大视觉相关基准SOTA。
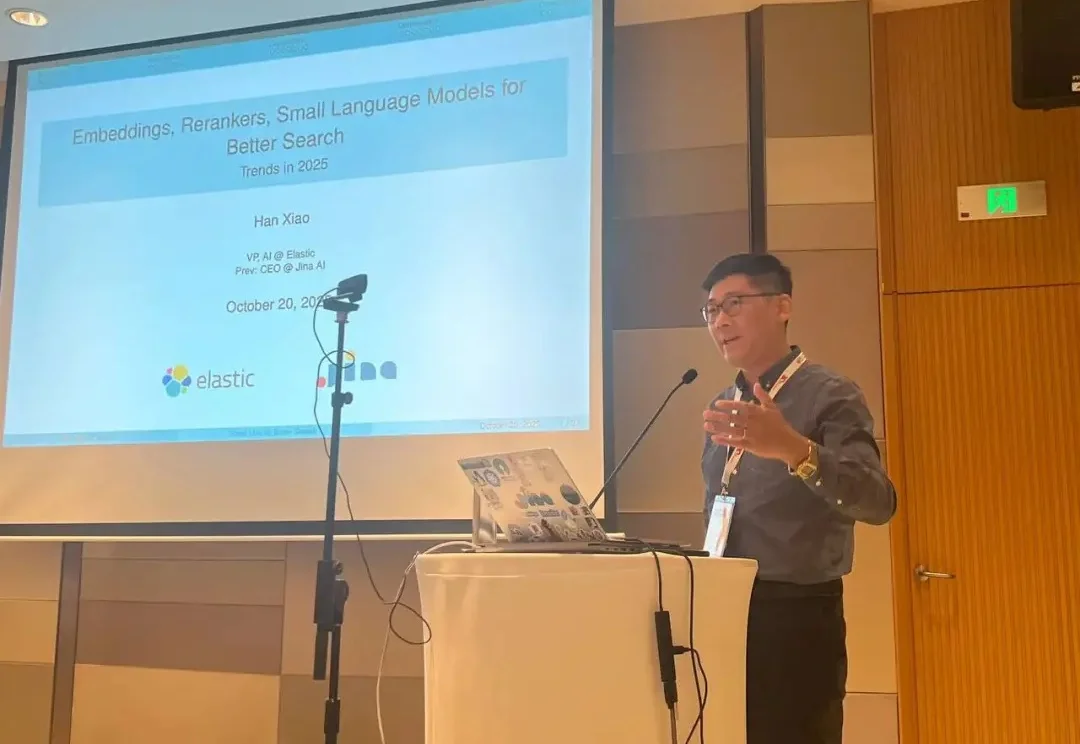
Google 最近发了 Gemini Embedding 2,他们第一个原生多模态向量模型。文本、图像、视频、音频、文档,全部映射到同一个 3072 维向量空间。这是 Omni Embedding(全模态向量模型)的大趋势:一个架构吃下所有模态,从 jina-embeddings-v4 到 Omni-Embed-Nemotron 再到 Omni-5,大家都在往这个方向收敛。
最近,社交媒体上一个帖子火了: MIT 学生如何用 48 小时学完一学期的课?
Datasette创始人Simon Willison公开了一套指南,专门教专业开发者如何用Claude Code等AI编程工具提效。他总结了8大实战模式,从测试驱动到交互式解释,每一条都在重构程序员的工作方式。
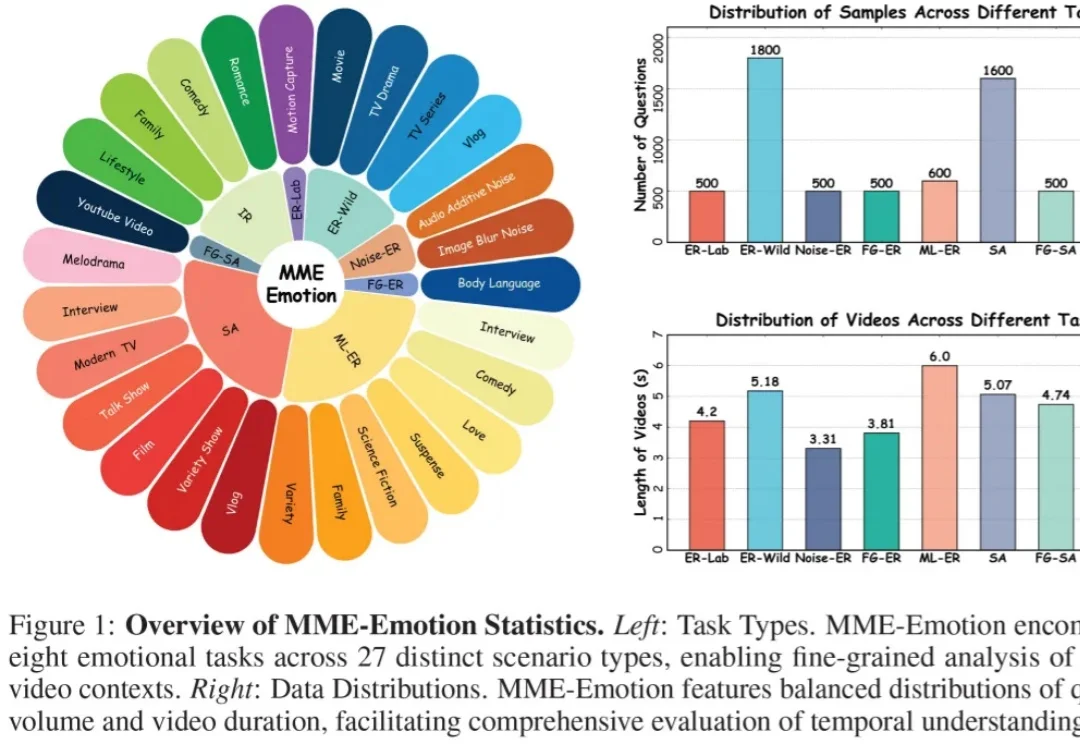
近年来,多模态大模型(Multimodal Large Language Models, MLLMs)正在迅速改变人工智能的能力边界。从图像理解到视频分析,从语音对话到复杂推理,大模型正在逐步具备类似人类的综合感知能力。但一个关键问题仍然没有得到充分回答:这些模型真的能够理解人类情绪吗?
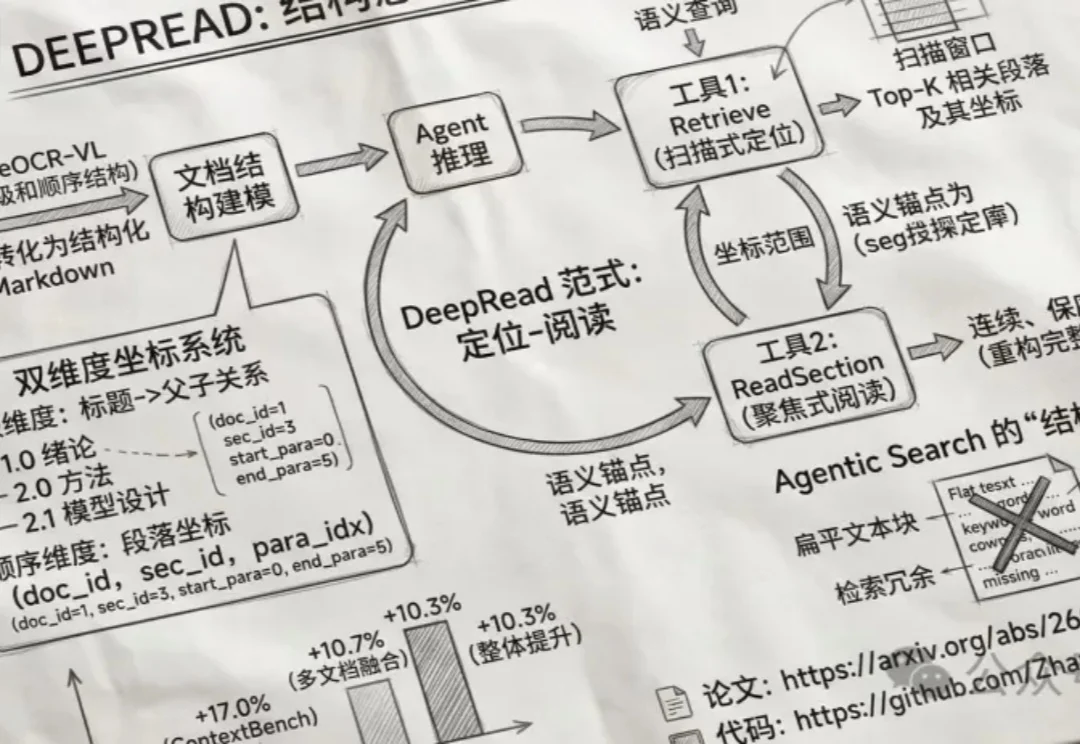
DeepRead让AI像人一样阅读文档:利用OCR识别章节结构,先精准定位相关段落,再完整读取上下文,避免碎片化检索。实验显示,其长文档问答准确率提升17%,能自动跳过冗余信息,精准提取财报、论文等复杂内容,无需额外知识图谱,轻量高效。
在当前的 LLM 开发中,后训练阶段通常被视为赋予模型特定能力的关键环节。传统的观点认为,模型必须通过强化学习(如 PPO、GRPO 或 RLHF)和进化策略(ES)等算法,在反复的迭代和梯度优化过程中调整权重,才能在特定任务上达到理想的性能。