AI资讯新闻榜单内容搜索-o

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: o
GPT-5难产,外媒爆料:性能提升不大,OpenAI高管Slack上当众破防

GPT-5难产,外媒爆料:性能提升不大,OpenAI高管Slack上当众破防

GPT-5难产,外媒爆料:性能提升不大,OpenAI高管Slack上当众破防

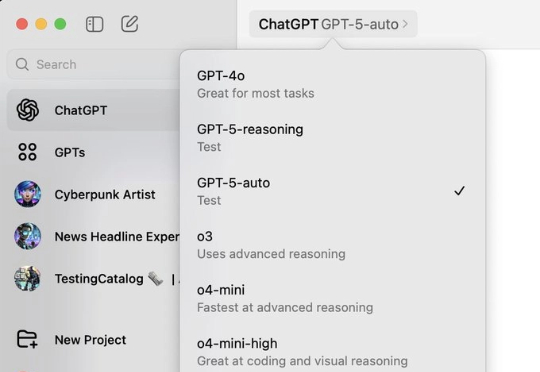
赢了的才是「GPT-5」。 GPT-5 迟迟未现身,网友们开始制作各种梗图「吐槽」其实,这几天关于 GPT-5 的传言就没消停。先是有网友在 macOS ChatGPT 应用中发现了 GPT-5-Auto 和 GPT-5-Reasoning 模型的踪迹:

来自主题: AI资讯
8812 点击    2025-08-02 14:28
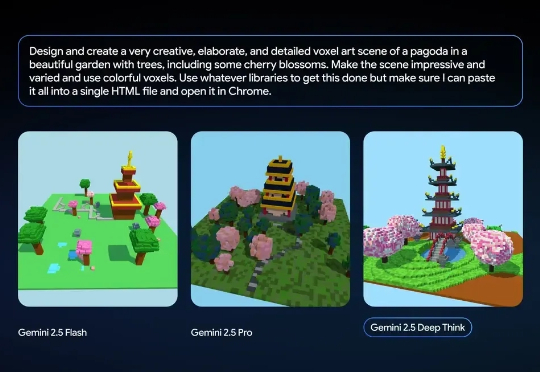
刚刚,谷歌「IMO金牌」模型上线Gemini,数学家第一时间证明猜想

刚刚,谷歌「IMO金牌」模型上线Gemini,数学家第一时间证明猜想

刚刚,谷歌「IMO金牌」模型上线Gemini,数学家第一时间证明猜想

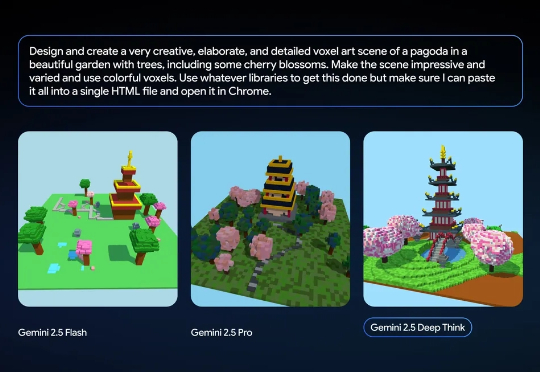
网友:Deep Think 简直太疯狂了。本周五,谷歌宣布向 Google AI Ultra 订阅用户推出 Deep Think 功能,并将全版本的 Gemini 2.5 Deep Think 模型(用于 IMO 竞赛)提供给部分数学家使用。

来自主题: AI资讯
9687 点击    2025-08-02 14:20
这个5亿播放的AI视频,邪乎得平平无奇

这个5亿播放的AI视频,邪乎得平平无奇

这个5亿播放的AI视频,邪乎得平平无奇

夜晚,后院监控视角下,10只小兔子在蹦蹦床。 就这么一条时长8s、平平无奇的视频,在TikTok上单条播放量超过5亿。
来自主题: AI资讯
7754 点击    2025-08-02 14:13
Z Tech|独家解读Meta朱泽园开源新基线,用10%算力跑赢Llama3-8B,科学方法引领新范式,语言模型物理学迈入新时代

Z Tech|独家解读Meta朱泽园开源新基线,用10%算力跑赢Llama3-8B,科学方法引领新范式,语言模型物理学迈入新时代

Z Tech|独家解读Meta朱泽园开源新基线,用10%算力跑赢Llama3-8B,科学方法引领新范式,语言模型物理学迈入新时代

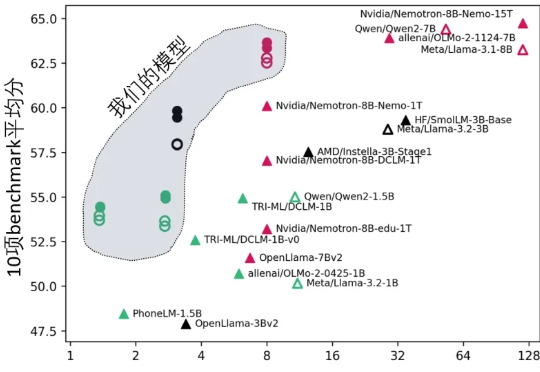
《Physics of Language Models(语言模型物理学)》,正是将AI研究带入“物理学范式”的项目,由Meta FAIR研究院的朱泽园概念化发起,并统筹设计。
来自主题: AI资讯
8857 点击    2025-08-02 14:04
PPIO这家AI Infra公司为什么做了一个“中国版的E2B”?

PPIO这家AI Infra公司为什么做了一个“中国版的E2B”?

PPIO这家AI Infra公司为什么做了一个“中国版的E2B”?

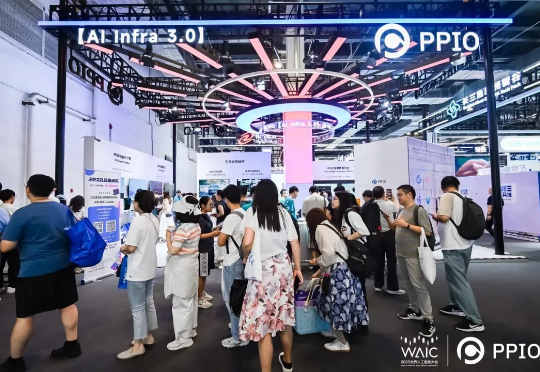
中国首个推出兼容E2B接口Agent沙箱的公司。7月26日,2025世界人工智能大会(WAIC)现场人头攒动。在科技要素拉满的会场内,几乎每个展台都在讨论大模型和AI Agent。
来自主题: AI资讯
11757 点击    2025-08-02 13:52
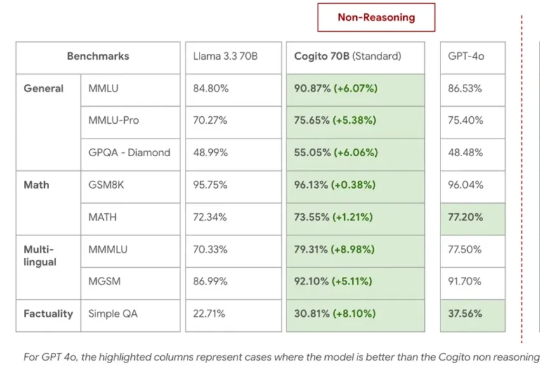
一个模型超了DeepSeek R1、V3,参数671B,成本不到350万美元

一个模型超了DeepSeek R1、V3,参数671B,成本不到350万美元

一个模型超了DeepSeek R1、V3,参数671B,成本不到350万美元

Deep Cogito,一家鲜为人知的 AI 初创公司,总部位于旧金山,由前谷歌员工创立,如今开源的四款混合推理模型,受到大家广泛关注。
来自主题: AI资讯
8726 点击    2025-08-02 13:38
AI答IMO难题坦承“不会”,OpenAI:这就是自我意识

AI答IMO难题坦承“不会”,OpenAI:这就是自我意识

AI答IMO难题坦承“不会”,OpenAI:这就是自我意识

这一次,“不会”竟成了大模型的高光时刻。 虽然在IMO第6题上得了零分,OpenAI的金牌模型却展现了“高智商的诚实”。
来自主题: AI资讯
7426 点击    2025-08-02 13:32
谷歌深夜放出 IMO 金牌模型,多项测试力压 Grok 4、OpenAI o3!网友评论两极分化

谷歌深夜放出 IMO 金牌模型,多项测试力压 Grok 4、OpenAI o3!网友评论两极分化

谷歌深夜放出 IMO 金牌模型,多项测试力压 Grok 4、OpenAI o3!网友评论两极分化

昨夜,谷歌宣布向 Google AI Ultra 订阅用户推出 Deep Think 功能,Gemini 2.5 Deep Think 模型在今年的国际数学奥林匹克竞赛 (IMO) 上夺得金牌。
来自主题: AI资讯
8808 点击    2025-08-02 13:09
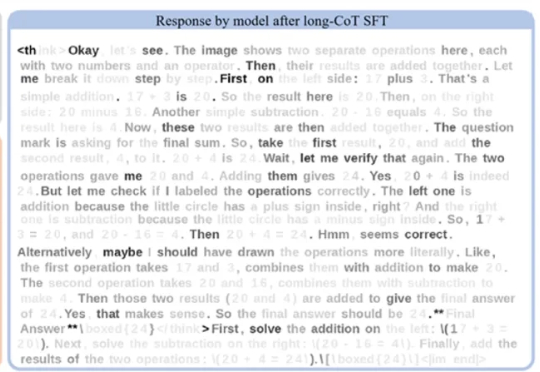
多模态后训练反常识:长思维链SFT和RL的协同困境

多模态后训练反常识:长思维链SFT和RL的协同困境

多模态后训练反常识:长思维链SFT和RL的协同困境

在语言模型领域,长思维链监督微调(Long-CoT SFT)与强化学习(RL)的组合堪称黄金搭档 —— 先让模型学习思考模式,再用奖励机制优化输出,性能通常能实现叠加提升。
来自主题: AI技术研报
9571 点击    2025-08-02 12:49
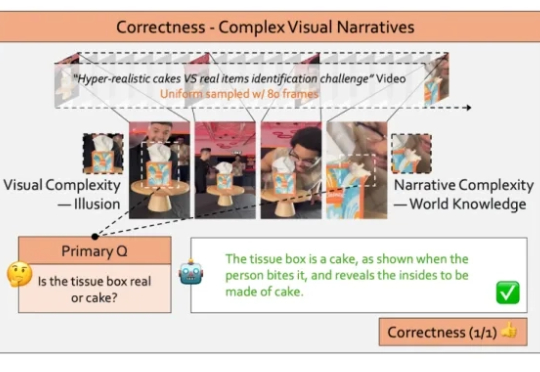
大模型无法真正理解视频,GPT-4o正确率仅36%,南洋理工大团队提出新基准

大模型无法真正理解视频,GPT-4o正确率仅36%,南洋理工大团队提出新基准

大模型无法真正理解视频,GPT-4o正确率仅36%,南洋理工大团队提出新基准

视频大型语言模型(Video LLMs)的发展日新月异,它们似乎能够精准描述视频内容、准确的回答相关问题,展现出足以乱真的人类级理解力。

来自主题: AI技术研报
8666 点击    2025-08-02 12:43