RSI热潮之下,自我迭代的国产Agentic Infra,卷向了英伟达GPU的物理极限
RSI热潮之下,自我迭代的国产Agentic Infra,卷向了英伟达GPU的物理极限无问芯穹(Infinigence AI)以国产Agentic Infra让GPU算子优化Agent登顶NVIDIA Research的SOL-ExecBench四项赛道,并通过Skills、共享Memory和隔离评测形成自我迭代闭环,揭示资源调度与工作流设计对RSI效率的影响。
搜索
无问芯穹(Infinigence AI)以国产Agentic Infra让GPU算子优化Agent登顶NVIDIA Research的SOL-ExecBench四项赛道,并通过Skills、共享Memory和隔离评测形成自我迭代闭环,揭示资源调度与工作流设计对RSI效率的影响。
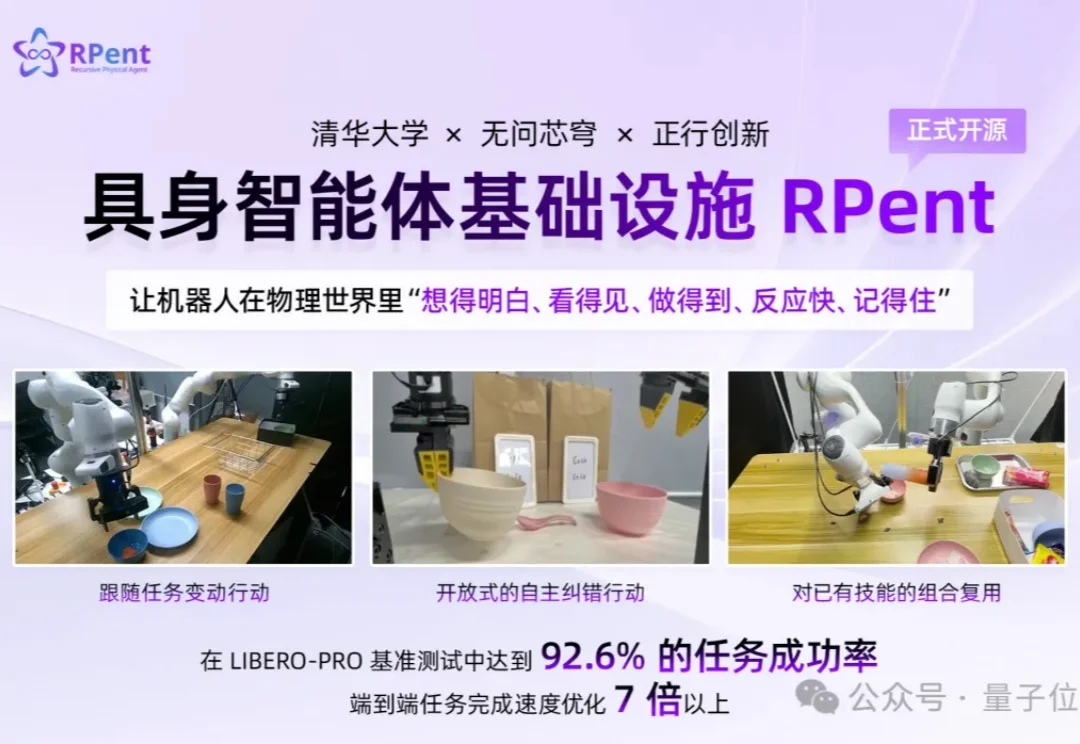
清华大学、智元与无问芯穹提出群体经验学习(Collective Experience Learning,CEL),在96台机器人上验证FERT与FATS,使五项任务总体成功率达97.5%,手机包装任务成功率从86.7%升至98.3%。
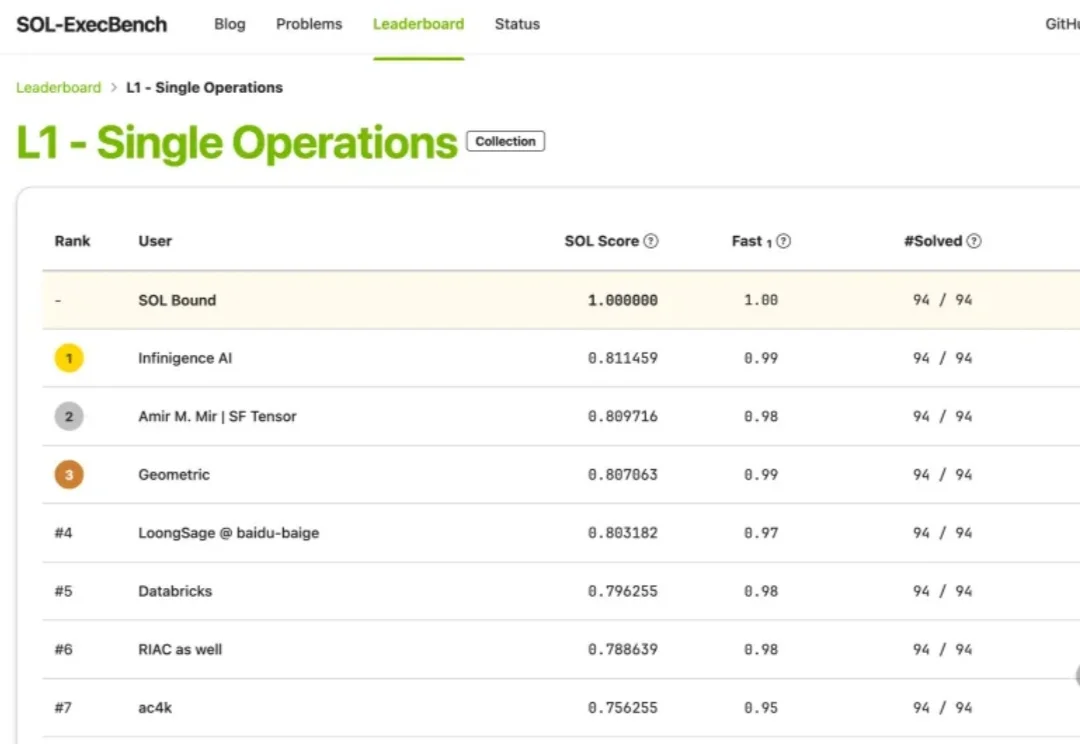
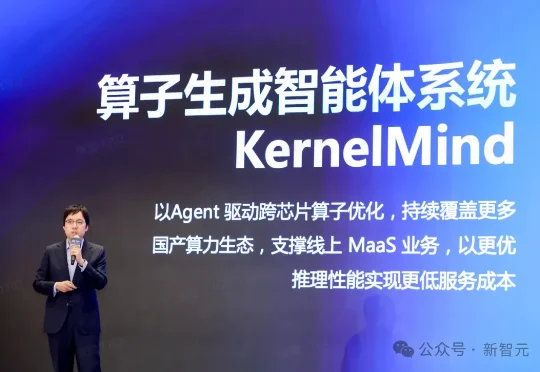
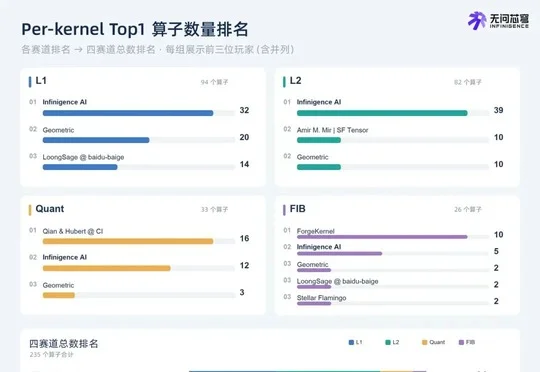
近日,在NVIDIA Research推出的GPU算子性能评测榜单SOL-ExecBench [1] 上,无问芯穹(Infinigence AI)取得亮眼成绩: 先后登顶L1基础算子、L2融合算子、Quant量化算子与FlashInfer-Bench推理算子全部四大赛道。
大厂林立,独立AI Infra厂商凭何能冲出重围?
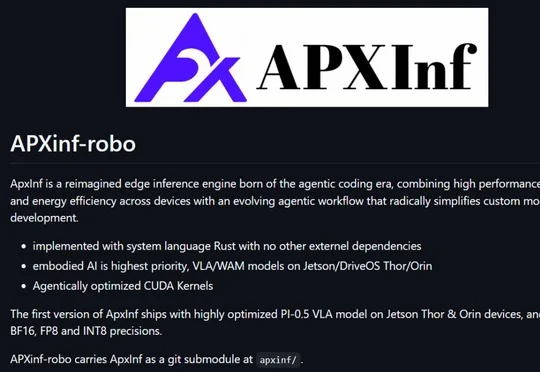
清华大学联合无问芯穹与上海交通大学开源了面向具身模型的端侧推理引擎APXInf,通过全栈优化在Thor芯片上将π0.5推理速度提高约10.7倍,并引入可由Agent执行的工程化流程以适配模型的持续迭代。
一架架飞机在空中有序飞行,按时起降,看似只是飞机自己的事情,实际上,它需要持续与机场、跑道、航线以及地面资源系统协同。
Codex、Claude Code等数字世界智能体,已经向我们展示出了一种全新且高效的工作方式:大模型理解目标,拆解任务,调用适当的工具,并根据执行结果不断调整计划,直到完成任务。
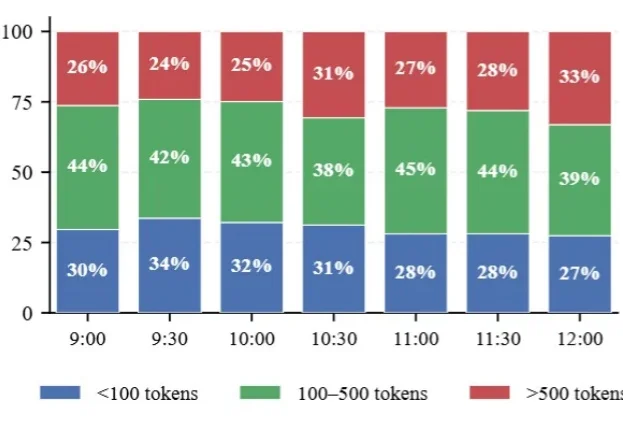
在刚刚落幕的2026 WAIC世界人工智能大会上,无问芯穹首次公布了其在大模型推理系统架构中的新突破——跨集群异构推理架构PDD。
就在今年的WAIC上,无问芯穹一口气亮出了「前店后厂一中心」,一整套完整的Agentic Infra战略布局:算力集散中心(一中心):Agentic Infra自主式基础设施平台;Token工厂(后厂):Agentic MaaS大模型服务平台;
6月22日Claude全家桶集体宕机,只是冰山一角。当最强大模型被丢进真实机房直面「幽灵故障」,AISHPerf-智算运维智能体评测基准给出残酷答案:全军覆没,无一过50分。这道鸿沟,第一次被量化。