登上NeurIPS,Genesis开创无需OCC引导的多模态生成新范式,在视频与激光雷达指标上达到SOTA水平
登上NeurIPS,Genesis开创无需OCC引导的多模态生成新范式,在视频与激光雷达指标上达到SOTA水平由华中科技大学与小米汽车提出了业内首个无需 OCC 引导的多模态的图像 - 点云联合生成框架 Genesis。该算法只需基于场景描述和布局(包括车道线和 3D 框),就可以生成逼真的图像和点云视频。
搜索
由华中科技大学与小米汽车提出了业内首个无需 OCC 引导的多模态的图像 - 点云联合生成框架 Genesis。该算法只需基于场景描述和布局(包括车道线和 3D 框),就可以生成逼真的图像和点云视频。
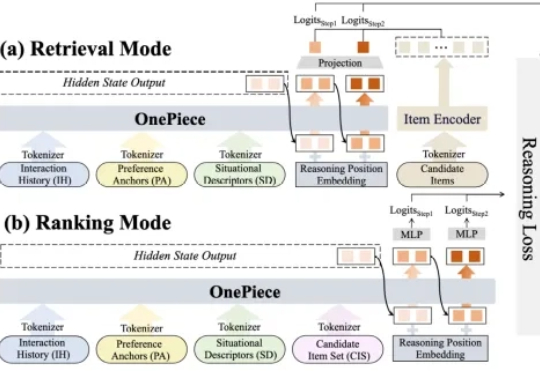
2025 年,生成式推荐(Generative Recommender,GR)的发展如火如荼,其背后主要的驱动力源自大语言模型(LLM)那诱人的 scaling law 和通用建模能力(general-purpose modeling),将这种能力迁移至搜推广工业级系统大概是这两年每一个从业者孜孜不倦的追求。
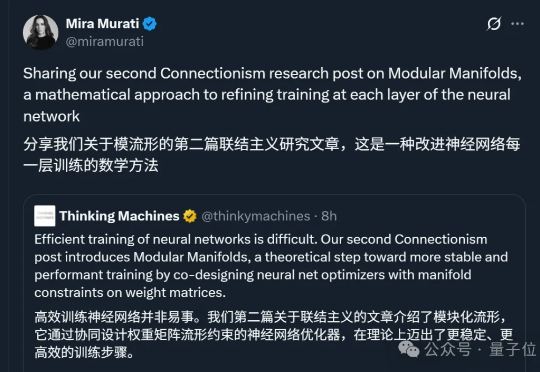
明星创业公司Thinking Machines,第二篇研究论文热乎出炉!公司创始人、OpenAI前CTO Mira Murati依旧亲自站台,翁荔等一众大佬也纷纷转发支持:论文主题为“Modular Manifolds”,通过让整个网络的不同层/模块在统一框架下进行约束和优化,来提升训练的稳定性和效率。
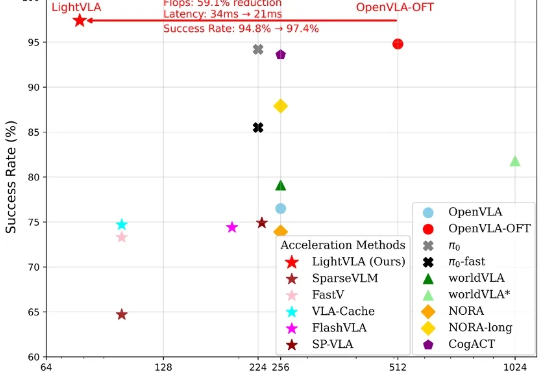
LightVLA 是一个旨在提升 VLA 推理效率且同时提升性能的视觉 token 剪枝框架。当前 VLA 模型在具身智能领域仍面临推理代价大而无法大规模部署的问题,然而大多数免训练剪枝框架依赖于中间注意力输出,并且会面临性能与效率的权衡问题。
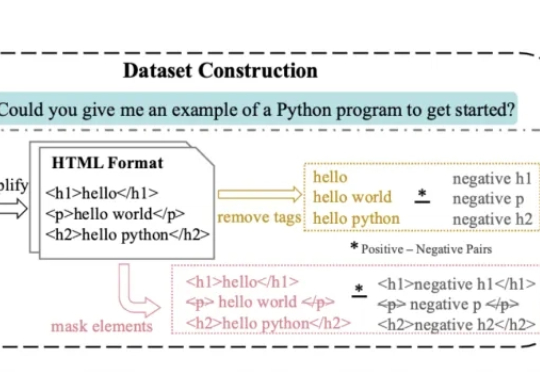
AI读不懂HTML、Markdown长文档的标题和结构,找信息总踩坑?解决方案来了——SEAL全新对比学习框架通过带结构感知+元素对齐,让模型更懂长文。
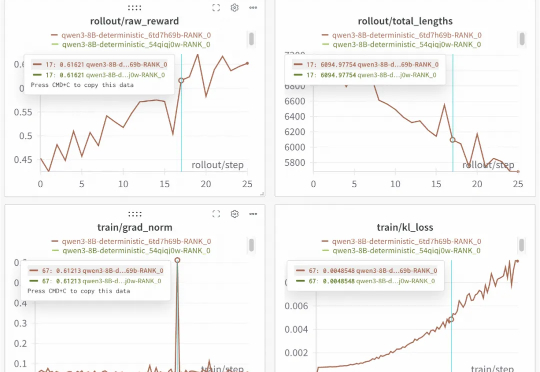
开源框架实现100%可复现的稳定RL训练!下图是基于Qwen3-8B进行的重复实验。两次运行,一条曲线,实现了结果的完美重合,为需要高精度复现的实验场景提供了可靠保障。这就是SGLang团队联合slime团队的最新开源成果。
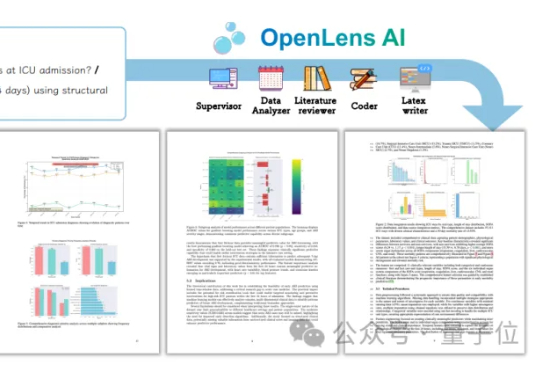
医学研究迎来“零人工”时代了?!清华大学自动化系索津莉课题组,发布首个专为医疗信息学设计的全自主AI研究框架——OpenLens AI。首次实现从文献挖掘→实验设计→数据分析→代码生成→可投稿论文的全链条自动化闭环。
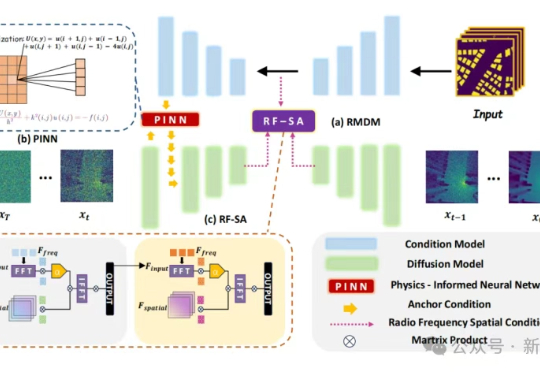
抢滩6G前夜,AI加物理正在重塑无线电地图产业格局。香港科技大学(广州)等机构联手重磅发布PhyRMDM框架,打破认知盲区,将物理约束与生成模型能力融合一体,显著提升高精度无线电地图的生成质量与稳定性。这一成果已被顶会ACM MM 2025接收。
所谓“AI精神病”并非正式医学诊断,实际报道案例多表现为被AI强化的妄想而非全面精神病症状。专家指出这是AI(特别是其“谄媚效应”设计)对脆弱人群(如有精神病史)既有妄想的触发或放大,需警惕过早贴标签的污名化风险,应将其理解为AI加速的精神问题,纳入现有诊疗框架而非创造新类别。
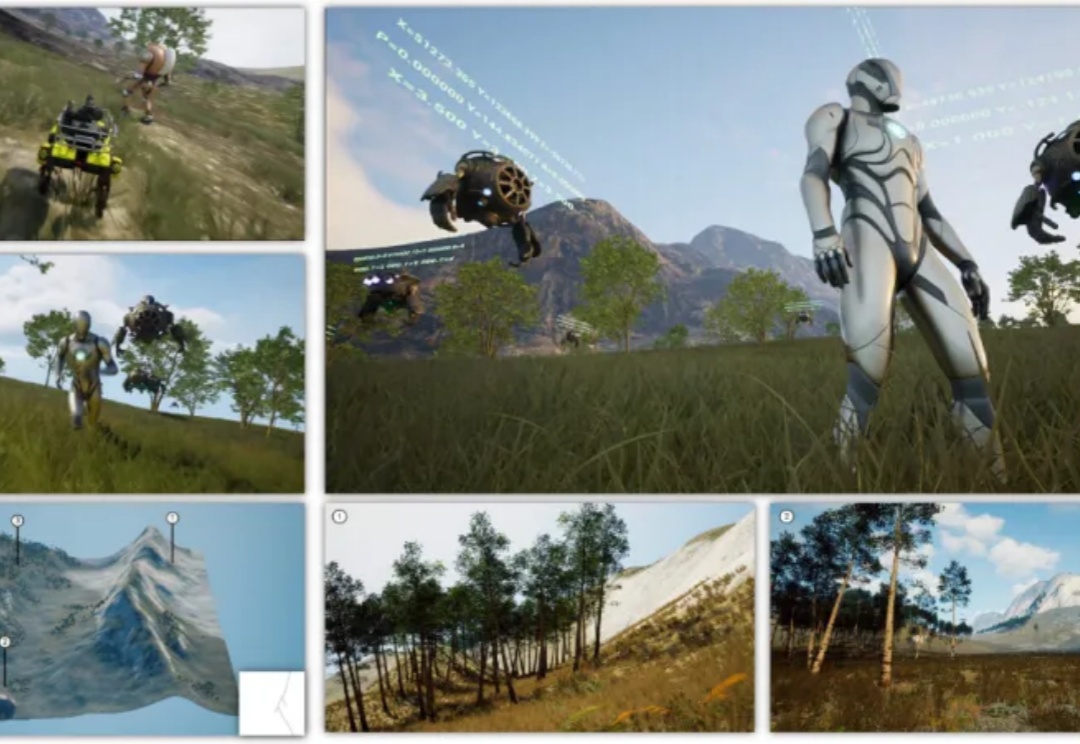
构建一个工业级高仿真 3D 虚拟世界,需要投入多少时间与人力?如果仅需一段描述、一张草图,AI 便可快速自动生成 —— 你相信吗?