体验完4月最强的三个模型:跑分涨了,却不说人话了
体验完4月最强的三个模型:跑分涨了,却不说人话了四月真是如风驰电掣:Anthropic 发布了 Opus 4.7,OpenAI 发布了 GPT 5.5,最后,DeepSeek 更新了暌违已久的 V4。三家公司的发布通稿读起来都差不多:跑分又涨了,上下文更长了,推理更强了,代码能力又创了新高。
来自主题: AI资讯
10758 点击 2026-04-29 09:45

 搜索
四月真是如风驰电掣:Anthropic 发布了 Opus 4.7,OpenAI 发布了 GPT 5.5,最后,DeepSeek 更新了暌违已久的 V4。三家公司的发布通稿读起来都差不多:跑分又涨了,上下文更长了,推理更强了,代码能力又创了新高。
终于,“养虾人”们也有自己的专属模型了。
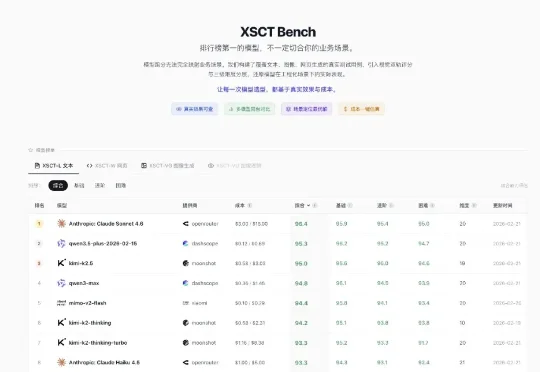
春节闭关五天,我做了个东西:一个大模型场景化测评平台。35000+ 次模型跑测,一共 42+ 模型,11,000 块人民币。我全部跑完了,结论汇成一个平台,还会持续更新。
模型众多,该如何选择? GPT-5:OpenAI的最新旗舰模型,统一智能系统,GPT-5 集成了多个模型,自动根据任务复杂度选择最适合的模型进行处理,多模态首选。 GPT-5 Thinking:GPT
用过才知道,「快」不是万能药。
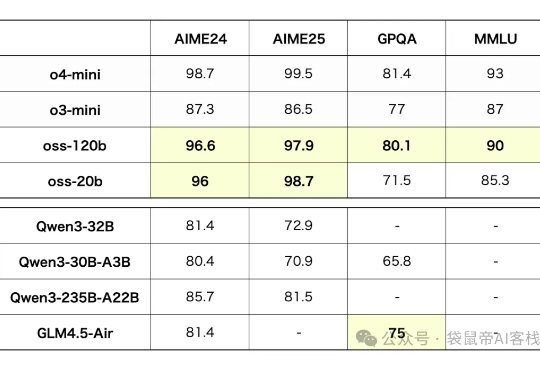
一直被称为"CloseAI"的OpenAI,终于舍得发布了他们继GPT-2之后的第一个开源模型:GPT-OSS
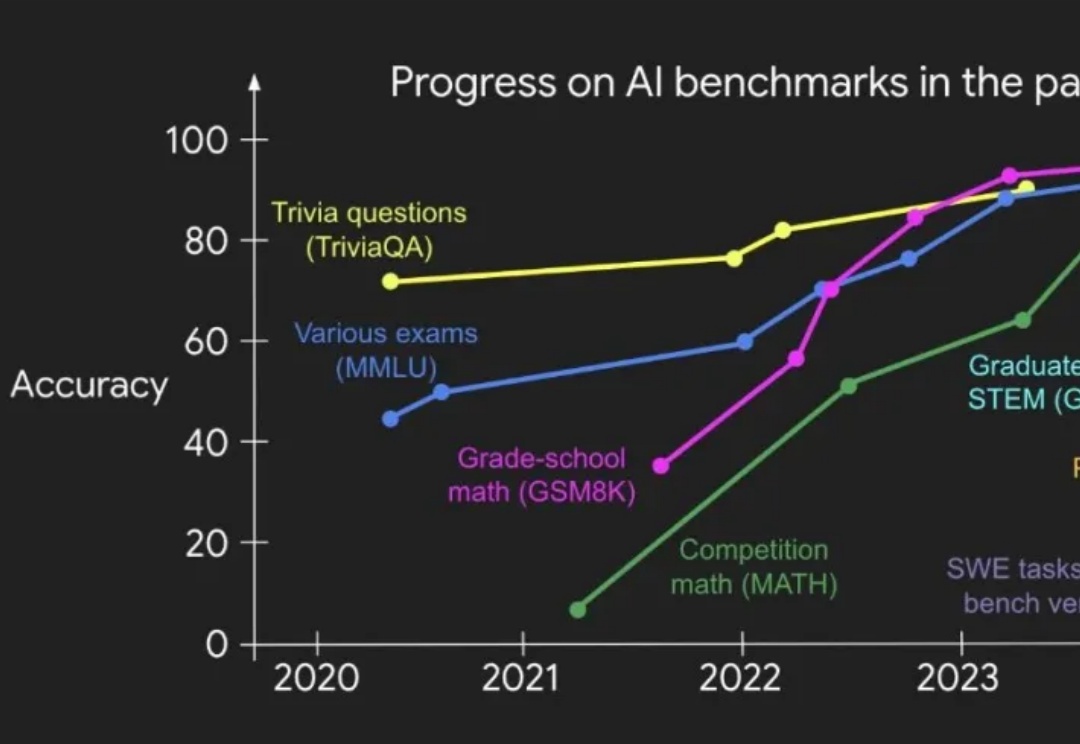
在三个月前,OpenAI 研究员 Shunyu Yao 发表了一篇关于 AI 的下半场的博客引起了广泛讨论。他在博客中指出,AI 研究正在从 “能不能做” 转向 “学得是否有效”,传统的基准测试已经难以衡量 AI 的实际效用,他指出现有的评估方式中,模型被要求独立完成每个任务,然后取平均得分。这种方式忽略了任务之间的连贯性,无法评估模型长期适应能力和更类人的动态学习能力。
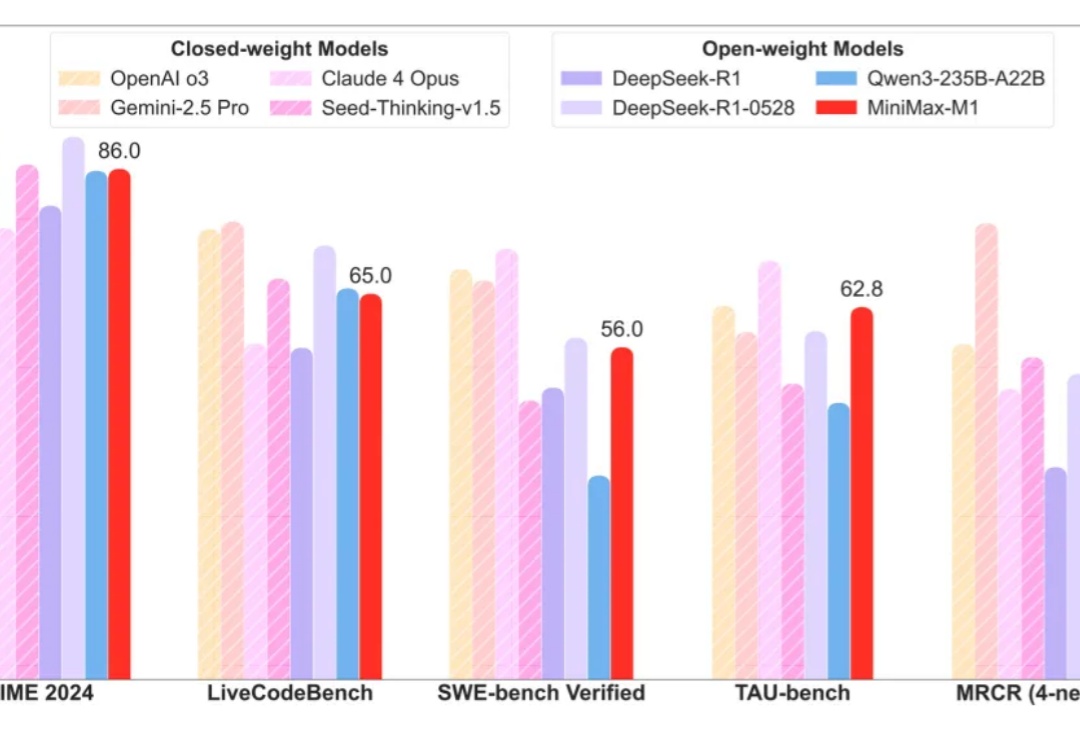
最近,我的AI交流群和别的一些AI群都炸锅了,话题的焦点是MiniMax-M1
要知道,过去几年,各种通用评测逐渐同质化,越来越难以评估模型真实能力。GPQA、MMLU-pro、MMLU等流行基准,各家模型出街时人手一份,但局限性也开始暴露,比如覆盖范围狭窄(通常不足 50 个学科),不含长尾知识;缺乏足够挑战性和区分度,比如 GPT-4o 在 MMLU-Pro 上准确率飙到 92.3%。
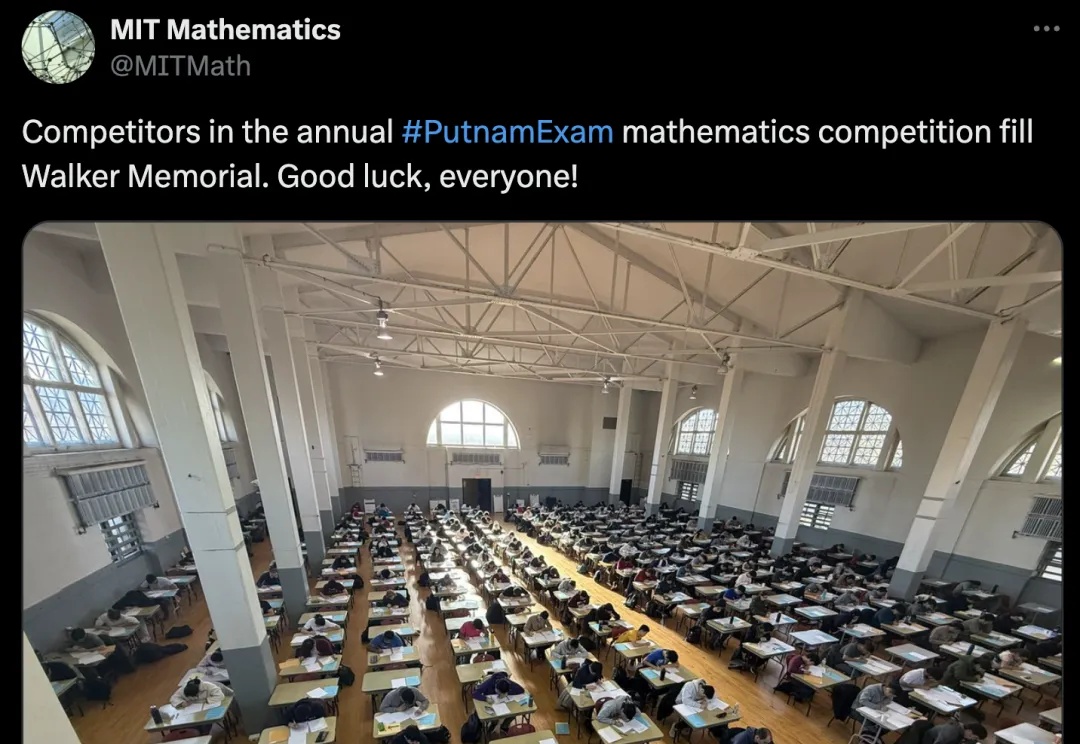
美国本科生最难数学竞赛,o1 pro竟然只用半小时就全部做出来了?要知道,参赛学生的正常答题时长是6小时。不过网友们仔细看它的解题过程后发现,错误率似乎高达100%,12道题没有一道完全正确?