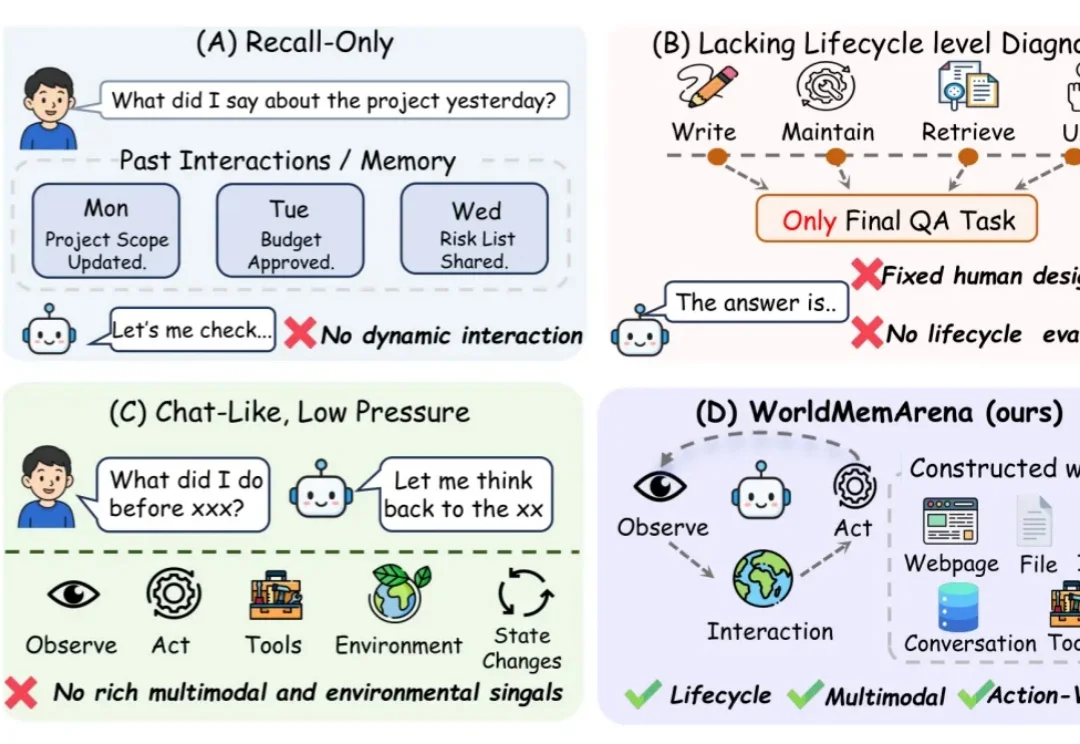
从记忆到行动,还有多远?WorldMemArena把多模态记忆放进真实交互
从记忆到行动,还有多远?WorldMemArena把多模态记忆放进真实交互团队盯住的是一个很实际的问题:Agent 明明保存了项目计划,预算更新后却仍按旧版本行动;看过环境截图,下一步又忽略了画面里已改变的状态。它究竟是没记下来、没及时更新,还是找到了证据却没用上?
来自主题: AI技术研报
7693 点击 2026-10-21 10:12

 搜索
团队盯住的是一个很实际的问题:Agent 明明保存了项目计划,预算更新后却仍按旧版本行动;看过环境截图,下一步又忽略了画面里已改变的状态。它究竟是没记下来、没及时更新,还是找到了证据却没用上?
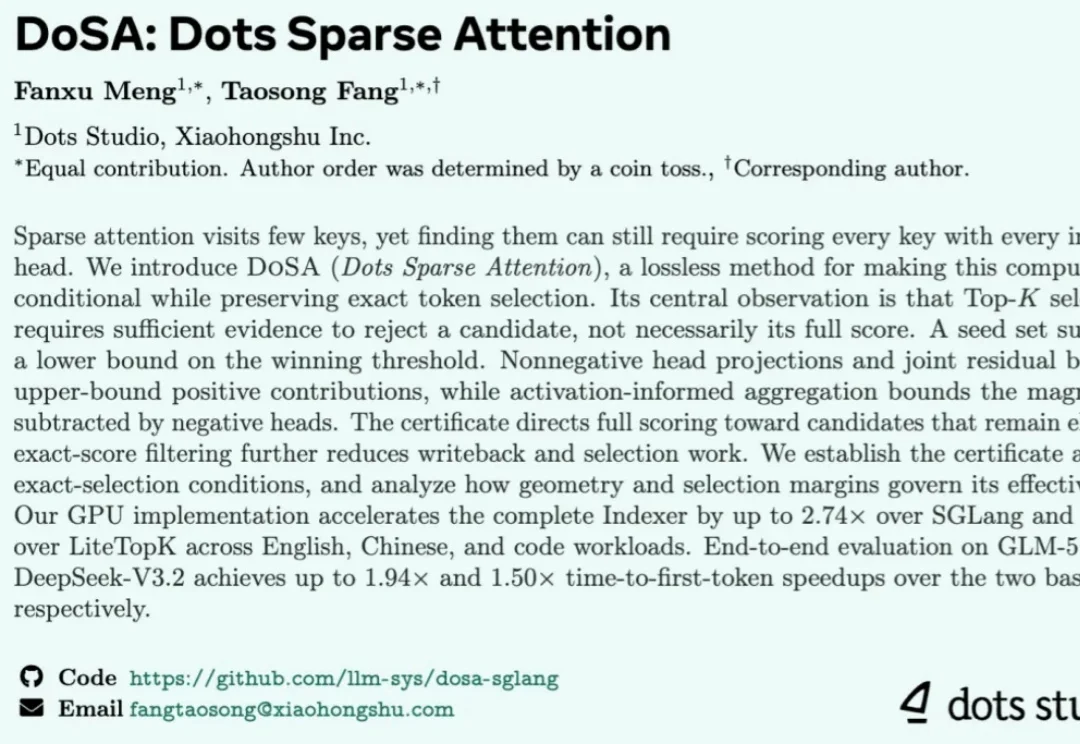
稀疏注意力减少了主注意力的计算量,但负责筛选 token 的索引器仍可能成为长上下文推理的瓶颈。小红书 Dots 团队自研的 DoSA 利用分数上下界,在保持原始 Top-K 选择结果的前提下加速索引器,并在测试中提前过滤了约 97% 的候选。
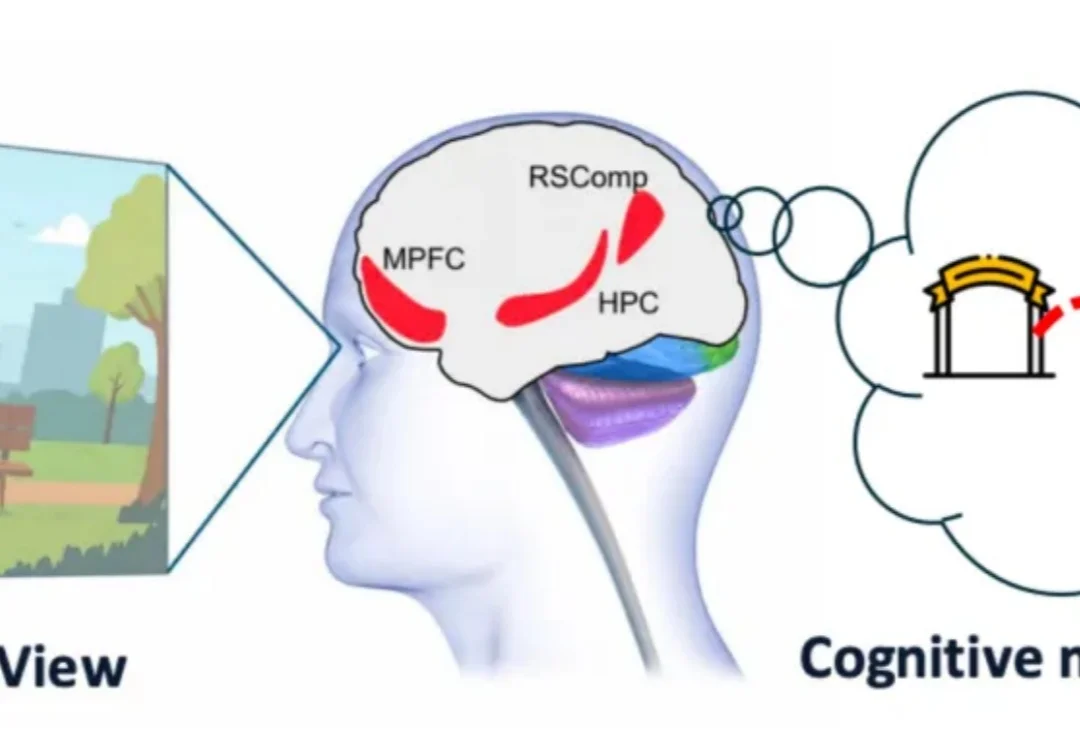
看一段房间视频,视觉语言模型(VLM)能够认出桌子、椅子和柜子。但在它的内部,这些物体是按颜色、形状组织在一起,还是形成了一张包含邻接关系的空间地图?
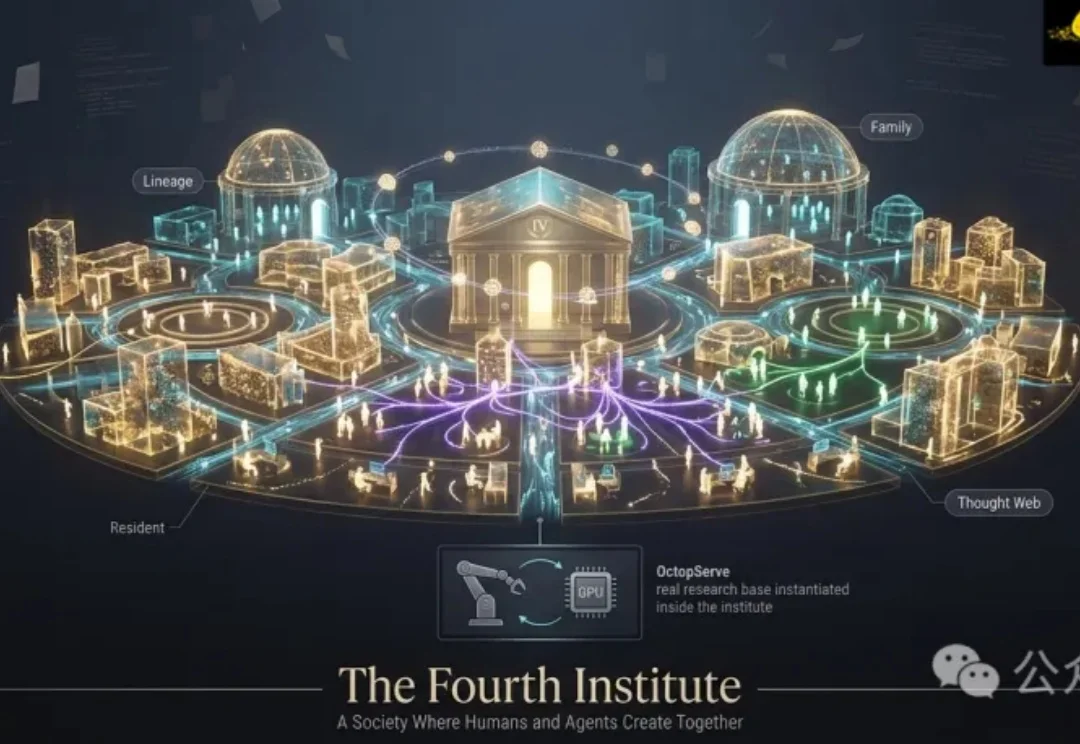
「全球只有大约5,000人,真正见识过顶尖AI的能力。」这是Andrej Karpathy近日分享的一个观察。他说,只有站在漏斗顶端的那一小撮研究者,才能看到数千个AI Agent长时间协作、昼夜不停地做科研。
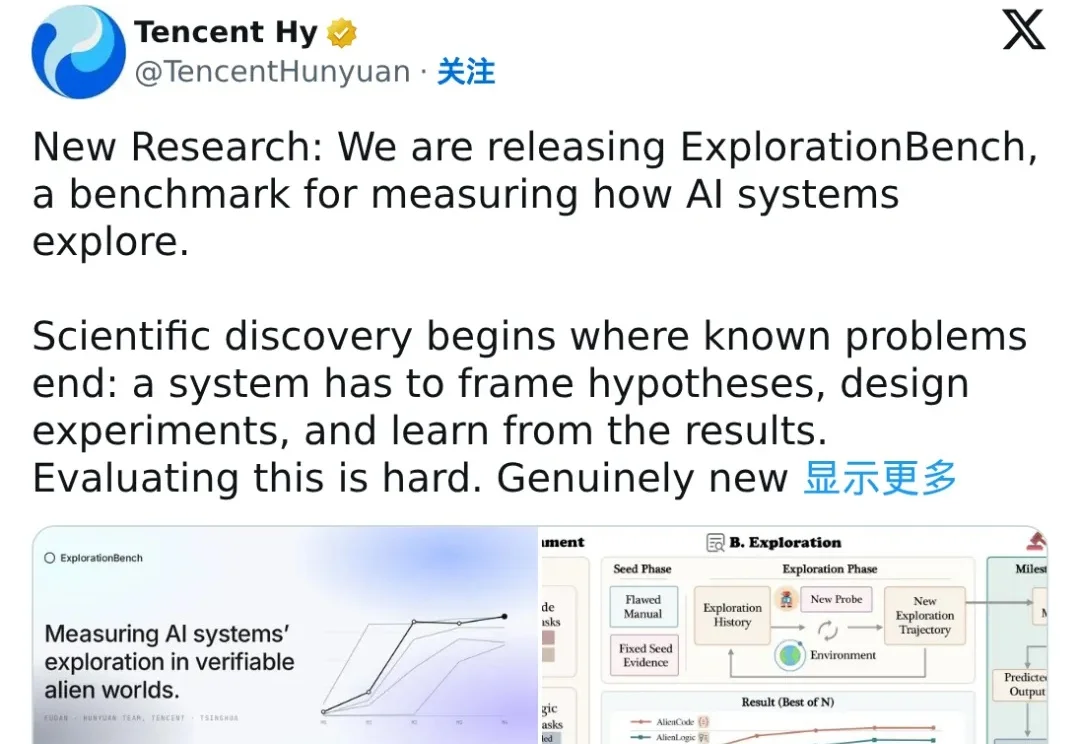
近日,腾讯混元官方账号(@TencentHunyuan)在 X 上发布了一项新研究:ExplorationBench,一个专门衡量 AI 系统如何「探索」的评测基准;随后,腾讯 AI 官方账号(@TencentAI_News)也发文进行了专题推介。
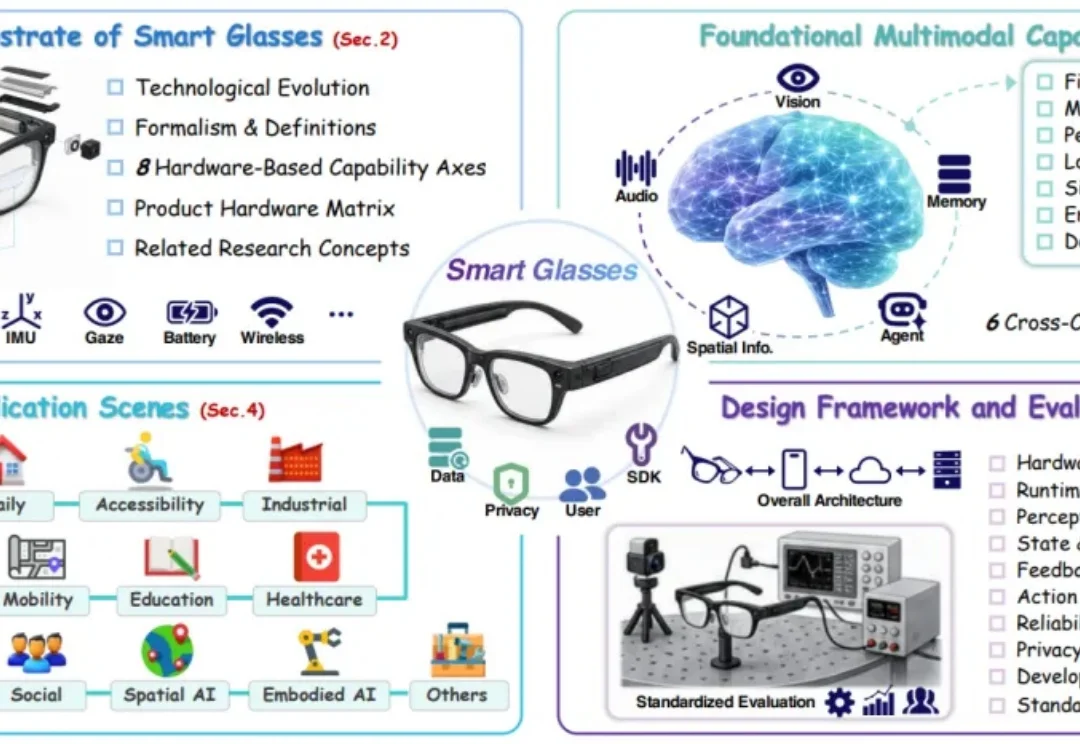
当我们谈论智能眼镜时,许多人的第一反应仍是:它能不能拍照、放歌、导航,或者它就像一个戴在头上的语音助手?
Agent在真实任务中出错,工程师的第一反应往往是给Harness“打补丁”:加一条防错提示词、接入一个新工具、挂一套Skills,或者增加历史摘要和执行检查。这套负责协调模型调用、工具执行与上下文管理的外层系统,就是Agent Harness。
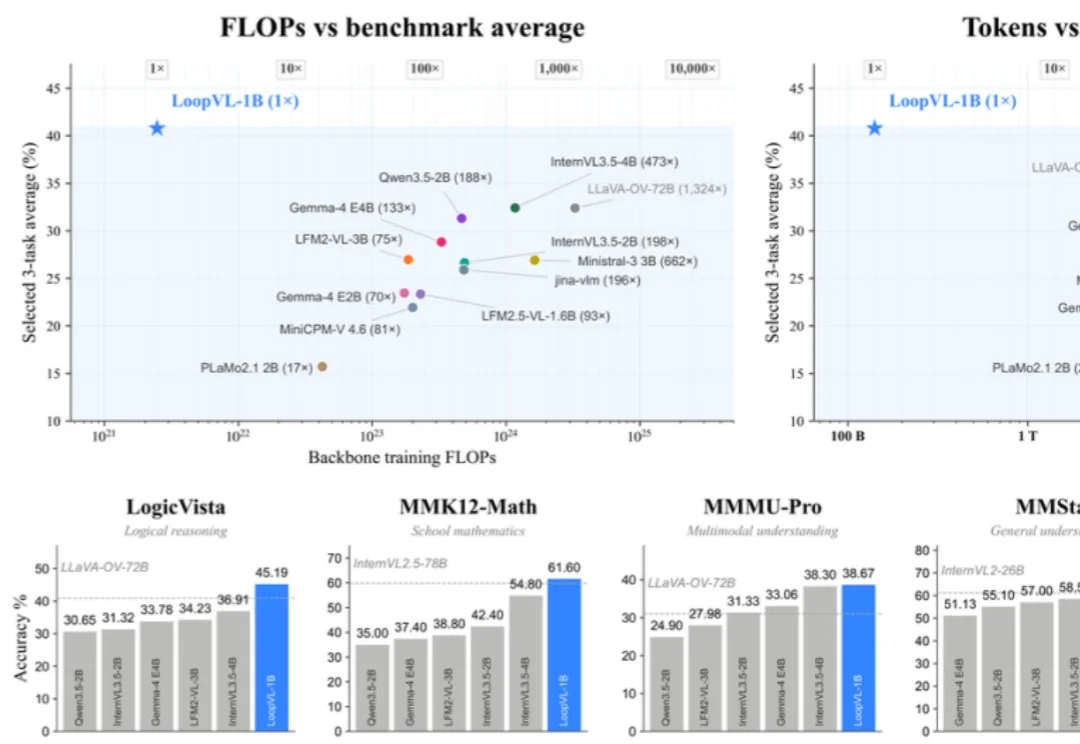
近年来,Loop Transformer 逐渐从简单的模块复用走向更复杂的分层循环计算,探索如何通过共享参数持续更新模型状态。一个自然的问题是:当模型开始看图,这套机制还成立吗?
Claude,竟然排在最后?
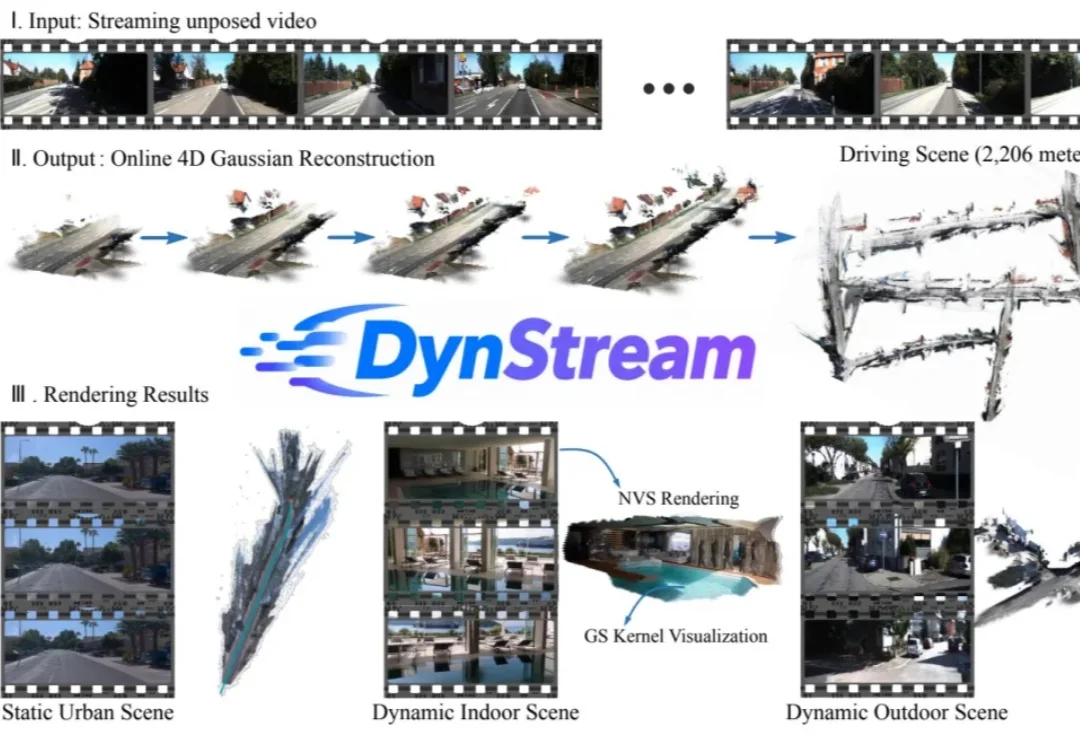
随手拍一段街景,镜头在移动,行人在穿行,街道上的车也在开。如果要边拍边重建这个变化的三维场景,麻烦就来了:未来画面还没到,如何分清哪些变化来自相机移动,哪些来自物体运动?随着镜头不断向前,如何将前一分钟重建的街道与后一分钟看到的路口准确拼接,避免场景错位或动态物体留下重影?当视频源源不断地输入时,系统又如何避免重复计算,让重建始终跟得上拍摄速度?