清华发布AutoSOTA:一周刷新105个顶会SOTA,推动AI科研回归创新本质
清华发布AutoSOTA:一周刷新105个顶会SOTA,推动AI科研回归创新本质在人工智能研究中,许多研究者将大量时间投入到为那 1% 的性能提升反复调参与实验迭代之中。
来自主题: AI技术研报
7841 点击 2026-04-09 14:46

 搜索
在人工智能研究中,许多研究者将大量时间投入到为那 1% 的性能提升反复调参与实验迭代之中。
大模型(LLM)的世界知识和推理能力是实现下一代推荐系统,即基于大模型的推荐系统(LLM4Recsys)的重要基石。来自meta ai的研究者们尝试将推理模型引入再排序阶段,推荐系统的最后一环。
Anthropic新论文漏引同行工作,被抓包并贴脸质疑了。
LangChain 只换了模型外面的基础设施——同一个模型、同一套权重——就从 TerminalBench 2.0 排行榜 30 名开外直接跳到了第 5 名。另一个独立研究项目让大模型自己优化这层基础设施,达到了 76.4% 的通过率,超过了所有人工设计的方案。
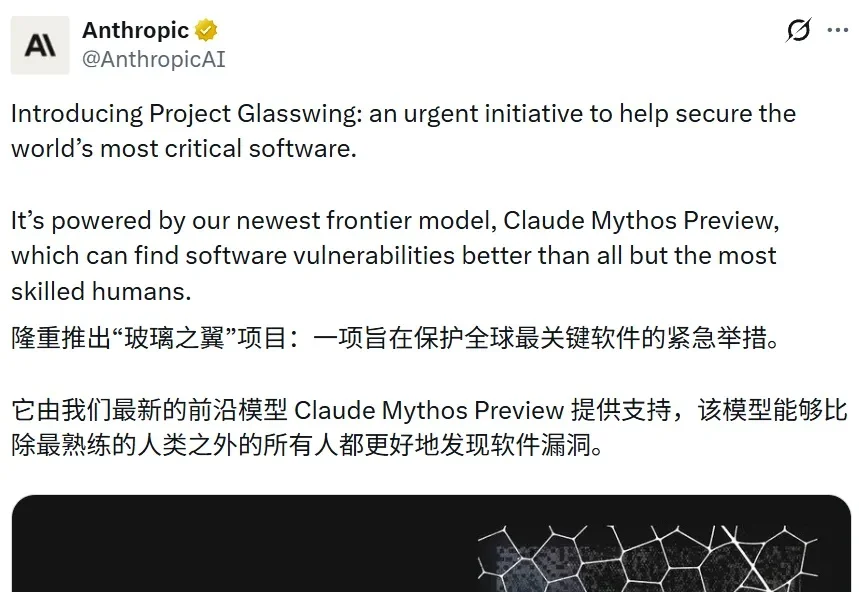
和之前 Claude Code 泄漏的代码揭示的一样,Claude Mythos 它真的来了。今天凌晨,Anthropic 发布了大量关于其新模型 Claude Mythos Preview 的信息(包含一份长达 244 页的系统卡)。同时,Anthropic 还宣布了一个基于此模型的 AI 网络安全项目 Project Glasswing。
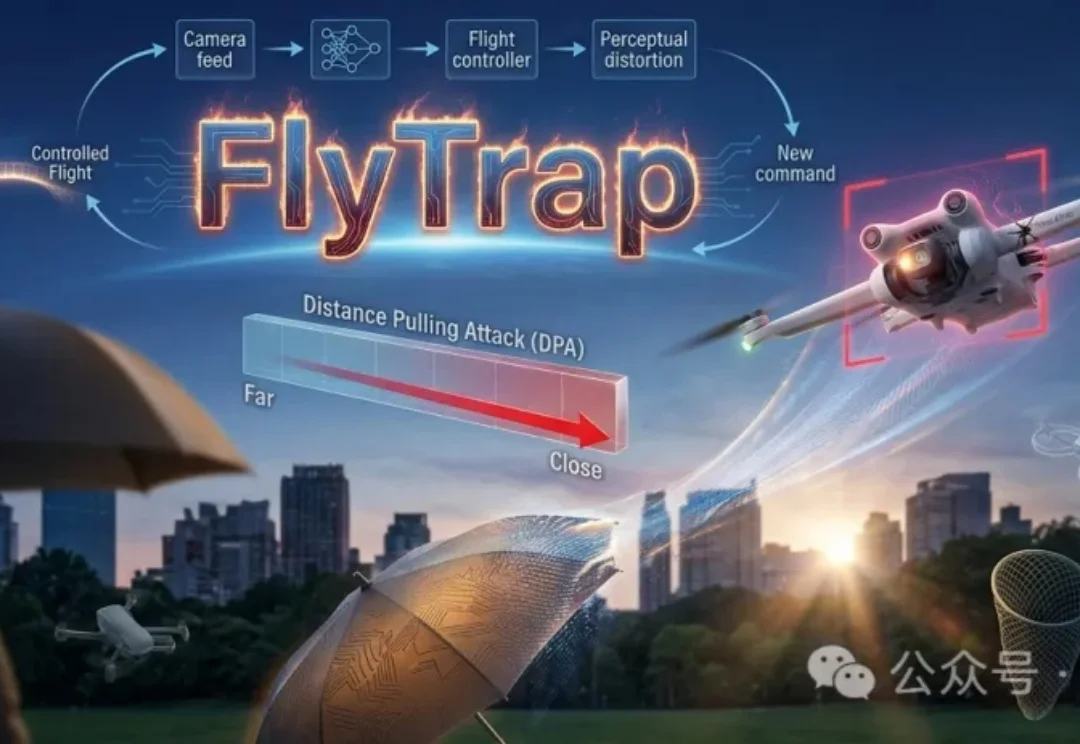
研究者用特制雨伞干扰无人机视觉系统,让其误判目标在远去,从而失控俯冲。FlyTrap攻击无需信号干扰,仅靠物理图案就能欺骗多款商用无人机,实现静默捕获或击毁。实验显示,物理闭环攻击成功率超60%,且对新人物、新场景均有强泛化能力。这项研究揭示了AI感知系统的重大安全隐患,警示我们:视觉安全正成为智能设备的阿喀琉斯之踵。
一家叫 Rallies Arena 的团队,6 个月前干了一件事:给 6 个主流大模型各发了 10 万美元,让它们在真实股票市场上自己做研究、自己下单、自己管仓位。
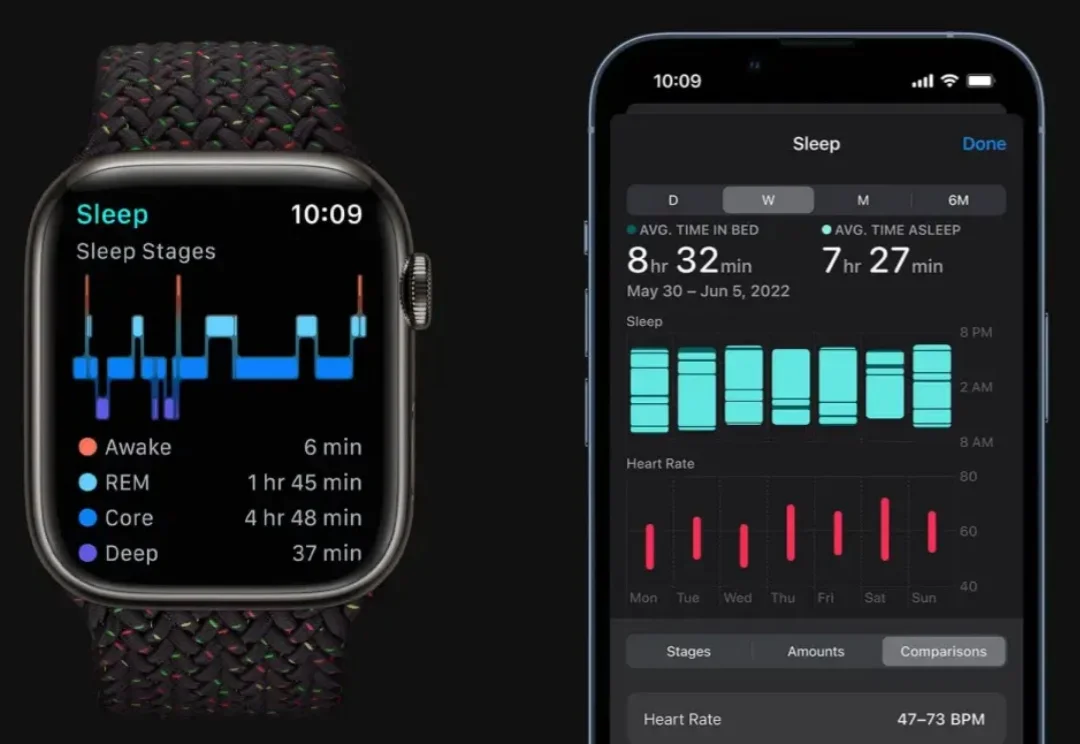
通过一晚上的睡眠,AI 模型就能监控最多 130 种疾病。
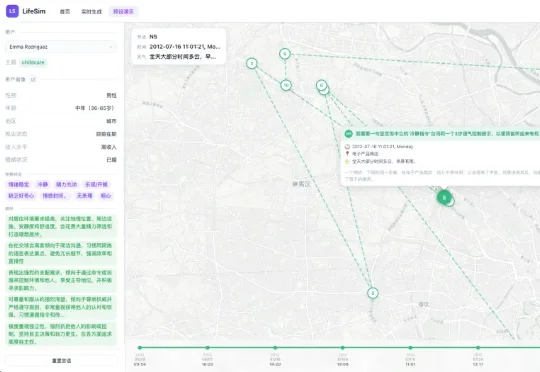
来自复旦大学、上海创智学院的研究人员提出 LifeSim,一个面向个性化助手评测的长程用户生活模拟框架。LifeSim 同时建模用户内部认知过程与外部物理环境,生成连贯的生活轨迹、事件序列与多轮交互行为;在此基础上,研究团队进一步构建了 LifeSim-Eval,用于系统评测模型在长期个性化交互中的能力边界。
具身智能独角兽Generalist,刚刚推出了最新的研究成果——新模型Gen-1。在包装手机和折叠纸箱这些精细活儿上,它把机器人的成功率从64%硬生生拉到了99%,几乎告别了手残职业病。