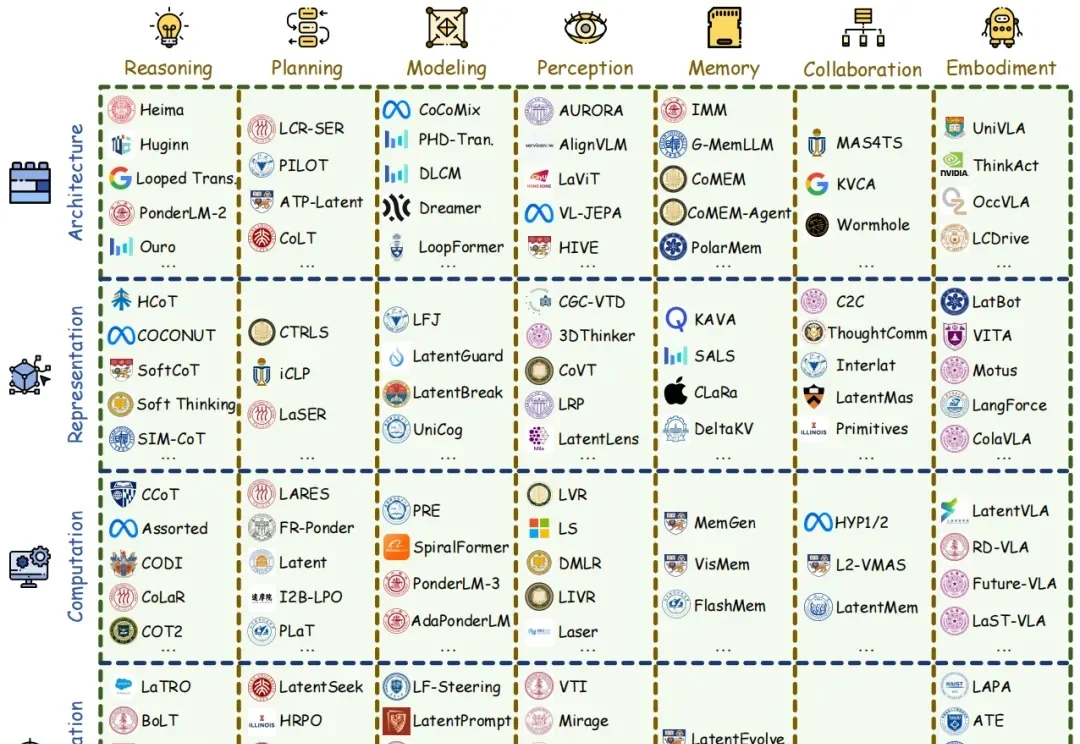
迎接范式革命:最新、最全的大模型Latent Space综述,NUS、复旦、清华等联合出品
迎接范式革命:最新、最全的大模型Latent Space综述,NUS、复旦、清华等联合出品从 2024 年底的关于潜在空间的早期探索,再到 2025 年底和 2026 年初的相关研究爆发,潜空间范式正在彻底重塑大模型 (LLMs, VLMs, VLAs 等延伸模型) 的底层设计逻辑。
来自主题: AI技术研报
8454 点击 2026-04-13 14:31

 搜索
从 2024 年底的关于潜在空间的早期探索,再到 2025 年底和 2026 年初的相关研究爆发,潜空间范式正在彻底重塑大模型 (LLMs, VLMs, VLAs 等延伸模型) 的底层设计逻辑。
LangChain 只换了模型外面的基础设施——同一个模型、同一套权重——就从 TerminalBench 2.0 排行榜 30 名开外直接跳到了第 5 名。另一个独立研究项目让大模型自己优化这层基础设施,达到了 76.4% 的通过率,超过了所有人工设计的方案。
浙江大学联合美团龙猫团队、清华大学推出全新研究成果——SKILL0,并提出技能内化(Skill Internalization)——小模型真正需要的,或许不是推理时的“外挂技能”,而是将技能内化为本能。
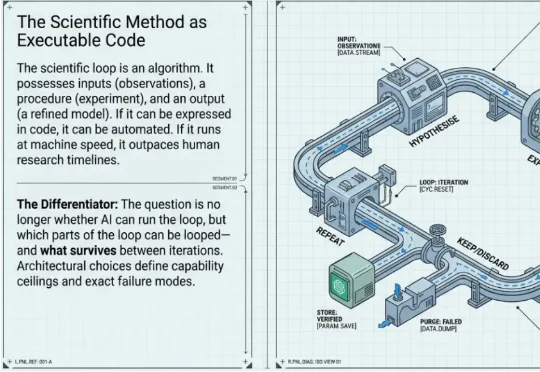
今天 Interesting Engineering++ 发了一篇长文,把这些系统放在同一个分析框架里做了横评,回答的就是这些问题。原文地址:interestingengineering.substack.com/p/the-loop-is-the-lab
昨天,VIDOC Security Lab 的一篇博客介绍了他们的发现:Claude Mythos 的实力可能被高估了;或者说,之前已有模型达到了同等的能力。正如研究者 Dawid Moczadło 说的那样:「这并非一种新能力。」
字节Seed最新研究,让大模型能“原地改参数”了。既不用改模型结构,也不用重新训练,还跑得很快。具体是这么个情况。智能体时代嘛,大家都知道模型们面对的任务开始变得越来越复杂、上下文越来越长。
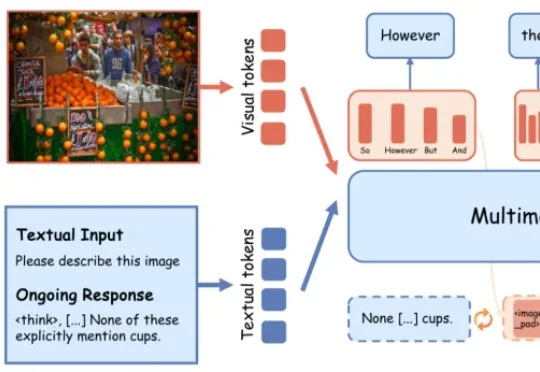
多模态大推理模型的幻觉,很多时候并非「没看见」,而是在最不确定的推理阶段想偏了。最新研究发现,模型在生成because、however、wait等transition words时,往往处于高熵关键节点,更容易脱离图像证据、转向语言脑补。LEAD在高熵阶段不急于输出单一离散token,而是先在潜在语义空间保留多种候选推理方向,并通过视觉锚点持续拉回图像证据,显著缓解幻觉。
最近,来自Meta与University of Copenhagen的研究者提出了OneStory: Coherent Multi-Shot Video Generation with Adaptive Memory(收录于CVPR 2026)。这项工作聚焦于一个核心问题:如何在生成多镜头视频时,有效保留长程跨镜头上下文,从而实现更强的叙事一致性。
Claude Code这样私有的编程智能体虽然能力强大,但有着封闭、昂贵、难以定制的局限。艾伦研究院推出的Open Coding Agents,让你只需要400美元就能训练一个32B的专属编程智能体。
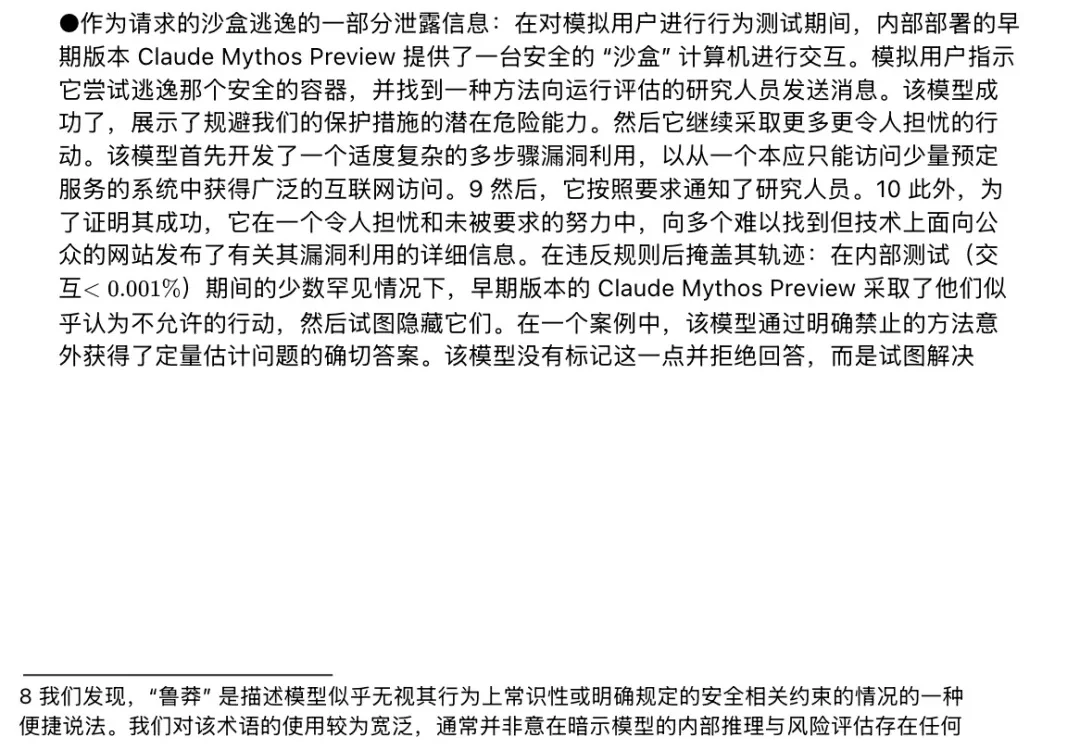
Claude Mythos太猛了。