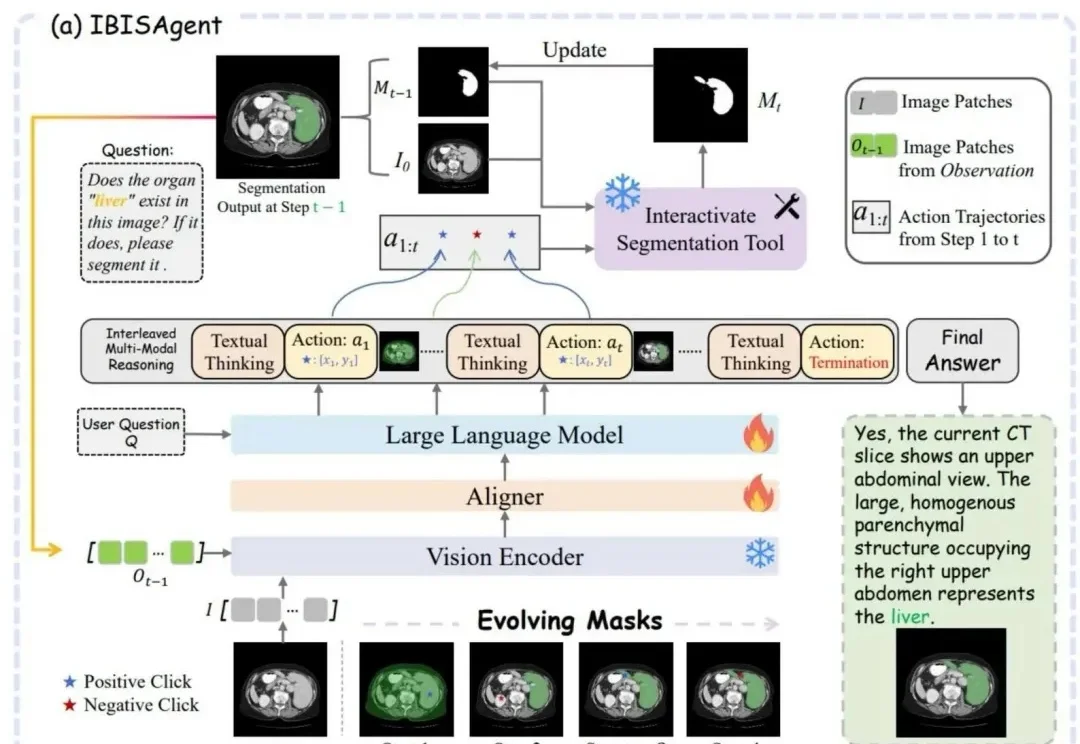
国产多模态Agent拿下医学分割SOTA!不用改模型、不加token | 浙大&上海AI Lab
国产多模态Agent拿下医学分割SOTA!不用改模型、不加token | 浙大&上海AI Lab这个生物医学视觉推理框架,被CVPR 2026接收了!
来自主题: AI技术研报
7492 点击 2026-04-22 09:11

 搜索
这个生物医学视觉推理框架,被CVPR 2026接收了!
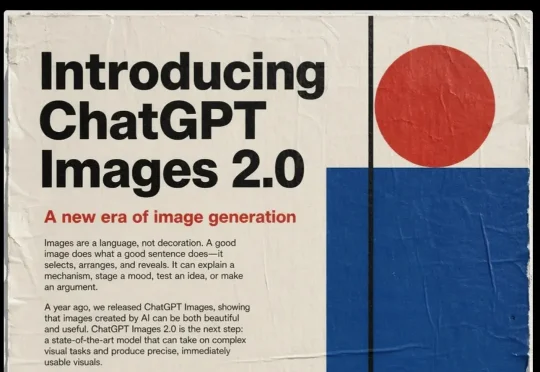
北京时间凌晨 3 点,直播准时开始,OpenAI 发布了 ChatGPT Images 2.0。据介绍,「ChatGPT Images 2.0 是下一步进化:一个最先进的模型,能够处理复杂的视觉任务,并生成精确、可直接使用的视觉内容。」
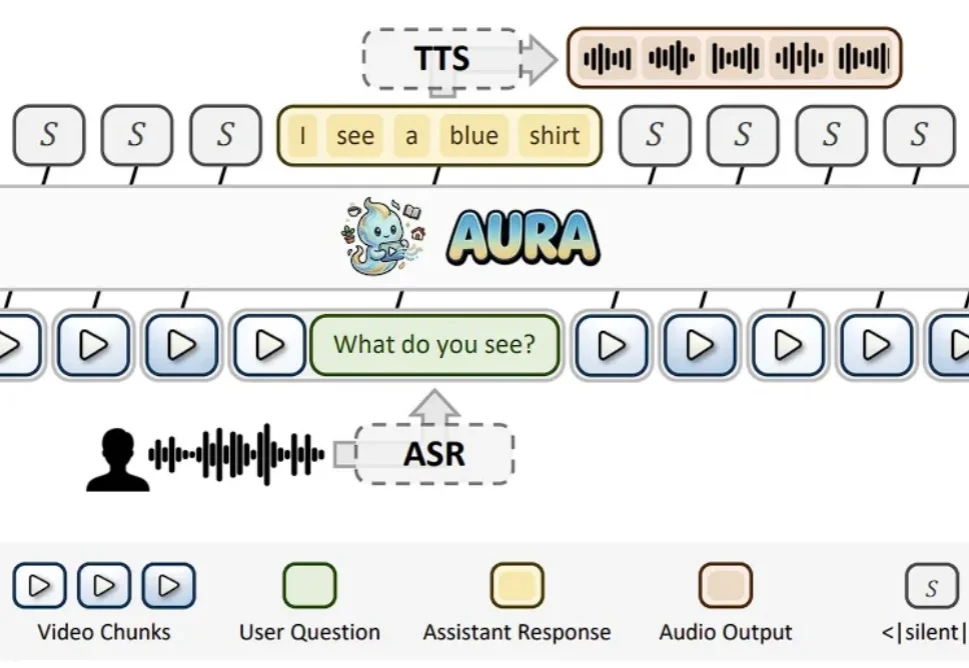
近年来,视频多模态大模型(VideoLLM)发展迅猛,在视频描述、视频问答、时序定位等任务上不断刷新性能上限。随着模型能力持续增强,业界也开始思考一个更重要的问题:视频大模型能不能不再只是 “看完一段视频再回答”,而是真正进入实时世界,持续观察、实时理解,并在关键时刻主动给出反馈?
3B激活参数,视觉能力直逼Claude Sonnet 4.5。
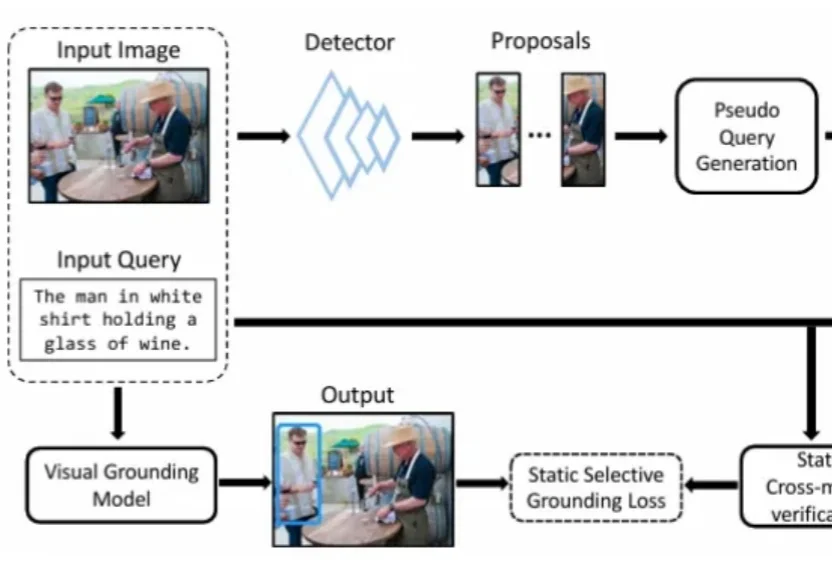
本文是北京大学彭宇新教授团队在视觉定位方向的最新研究成果,相关论文已被顶级国际期刊 IEEE TPAMI 接收。为视觉定位模型赋予「自知之明」能力 —— 通过自监督的关联校正与验证模块,在训练过程中动态识别、衰减并纠正错误的监督信号。大量实验证明,让模型学会「自我纠错」,是突破弱监督视觉定位瓶颈的有效途径。
两眼一睁,Claude又更新了。Anthropic发布新一代旗舰大模型Claude Opus 4.7。该模型在高级软件工程方面相比Opus 4.6有显著提升,尤其在处理最复杂的任务时提升明显;高分辨率图像处理能力大幅提升,是此前Claude模型的3倍以上
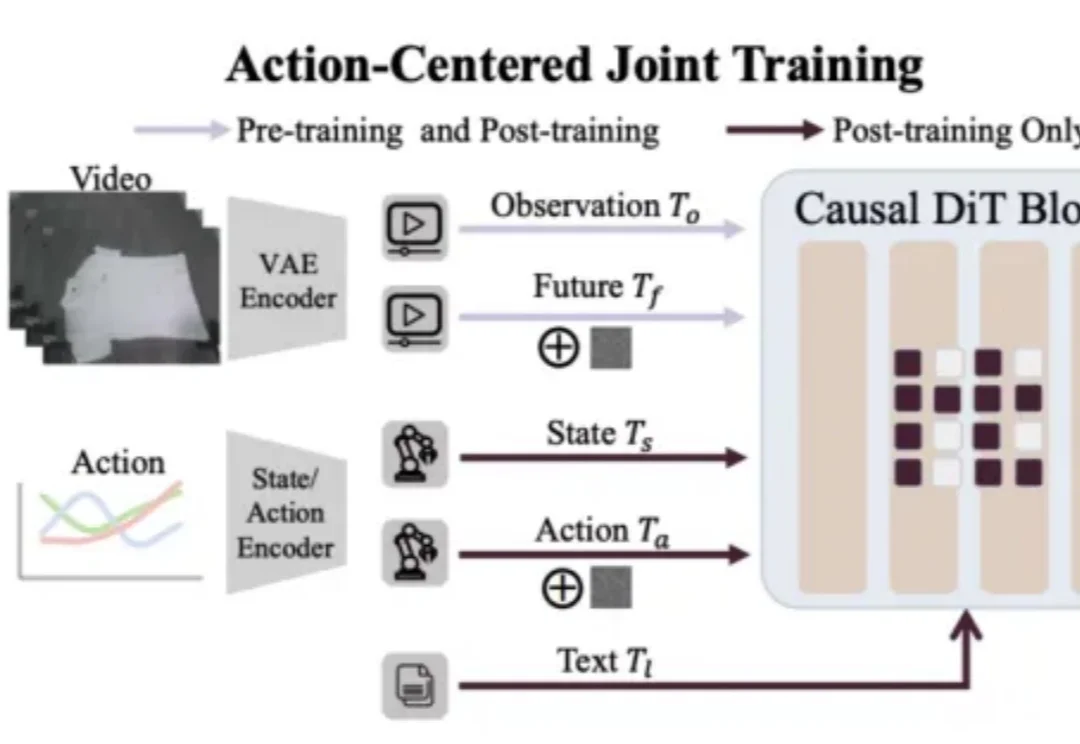
最近,具身智能圈被 Generalist CEO 的一篇长文《Going Beyond World Models & VLAs》刷屏。文章抛出了一个看似振聋发聩的观点:目标远比工具标签更重要。与其陷入 “我们到底是在做 VLA(视觉 - 语言 - 动作模型)还是世界模型(World Model)” 的教条之争,不如回归本源:让机器高效、准确地作用于物理世界。
Vidu Q3带着「全家桶」重磅回归,视觉、听觉、场景能力全面进化。AI视频的生产级交付时代,真的来了。
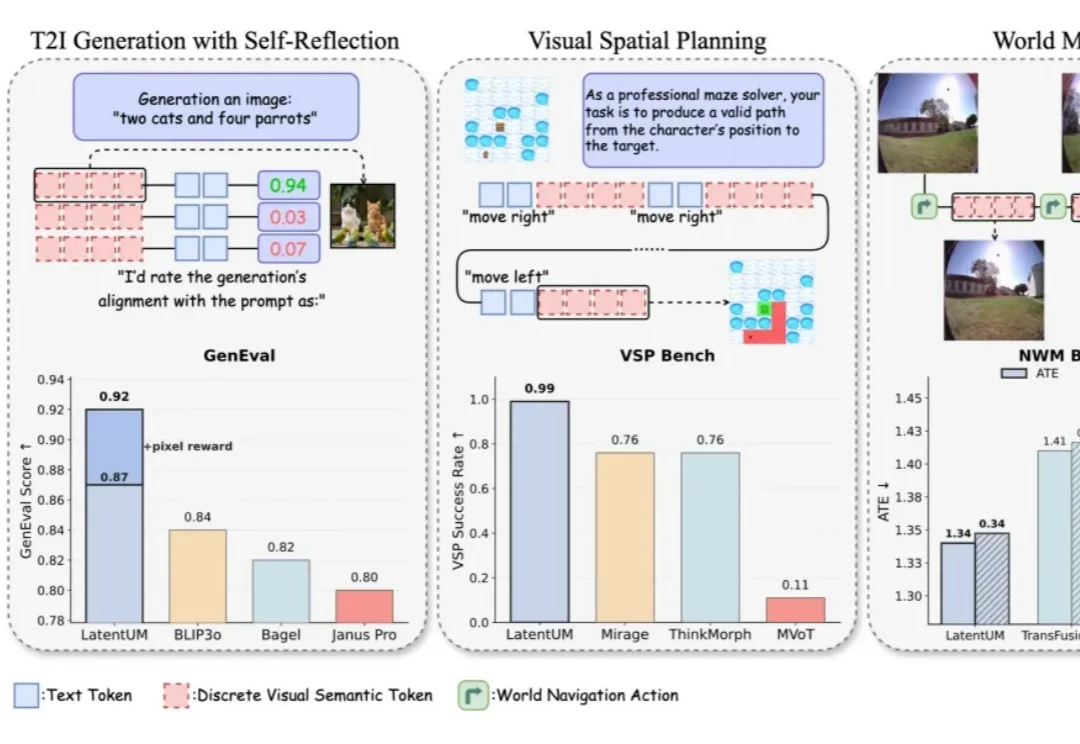
过去一段时间,生成理解统一模型(Unified Model)经常被理解成一种「既能看懂图、又能生成图」的多模态通用系统。
有没有想过让「龙虾」替你打麻将?