2025年了,AI还看不懂时钟!90%人都能答对,顶尖AI全军覆没
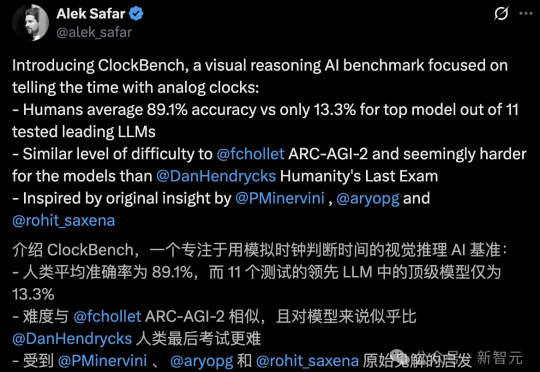
2025年了,AI还看不懂时钟!90%人都能答对,顶尖AI全军覆没一般人准确率89.1%,AI最好只有13.3%。在新视觉基准ClockBench上,读模拟时钟这道「小学题」,把11个大模型难住了。为什么AI还是读不准表?是测试有问题还是AI真不行?
来自主题: AI资讯
8559 点击 2025-09-09 17:24

 搜索
一般人准确率89.1%,AI最好只有13.3%。在新视觉基准ClockBench上,读模拟时钟这道「小学题」,把11个大模型难住了。为什么AI还是读不准表?是测试有问题还是AI真不行?
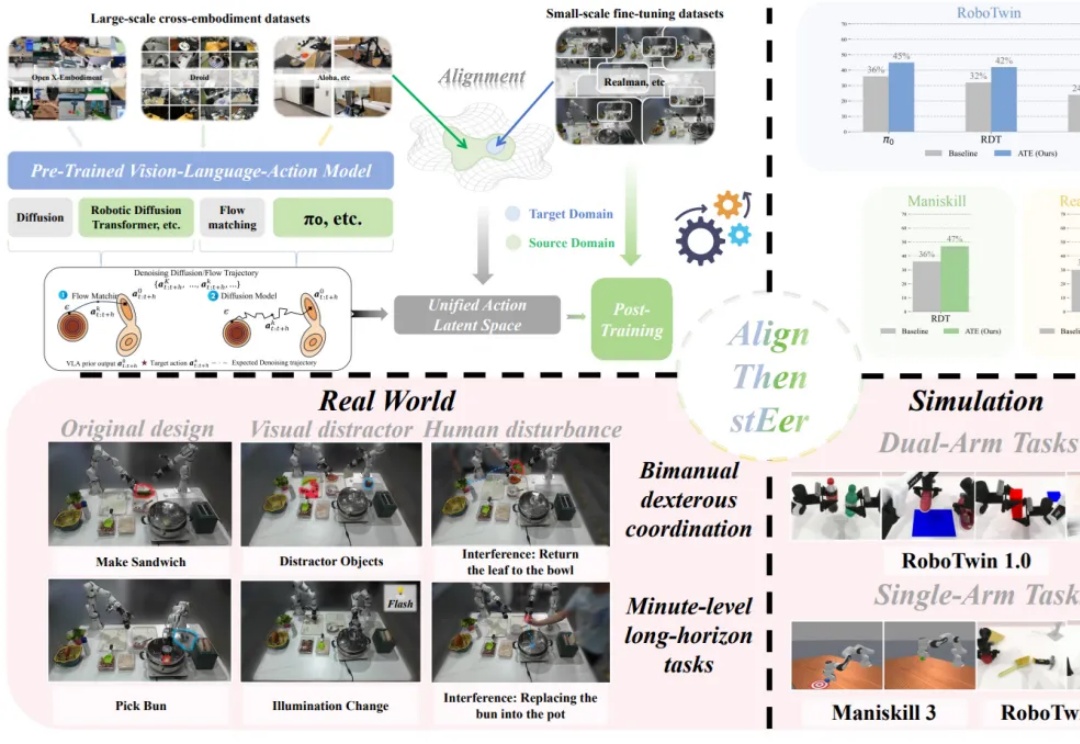
在多模态大模型的基座上,视觉 - 语言 - 动作(Visual-Language-Action, VLA)模型使用大量机器人操作数据进行预训练,有望实现通用的具身操作能力。
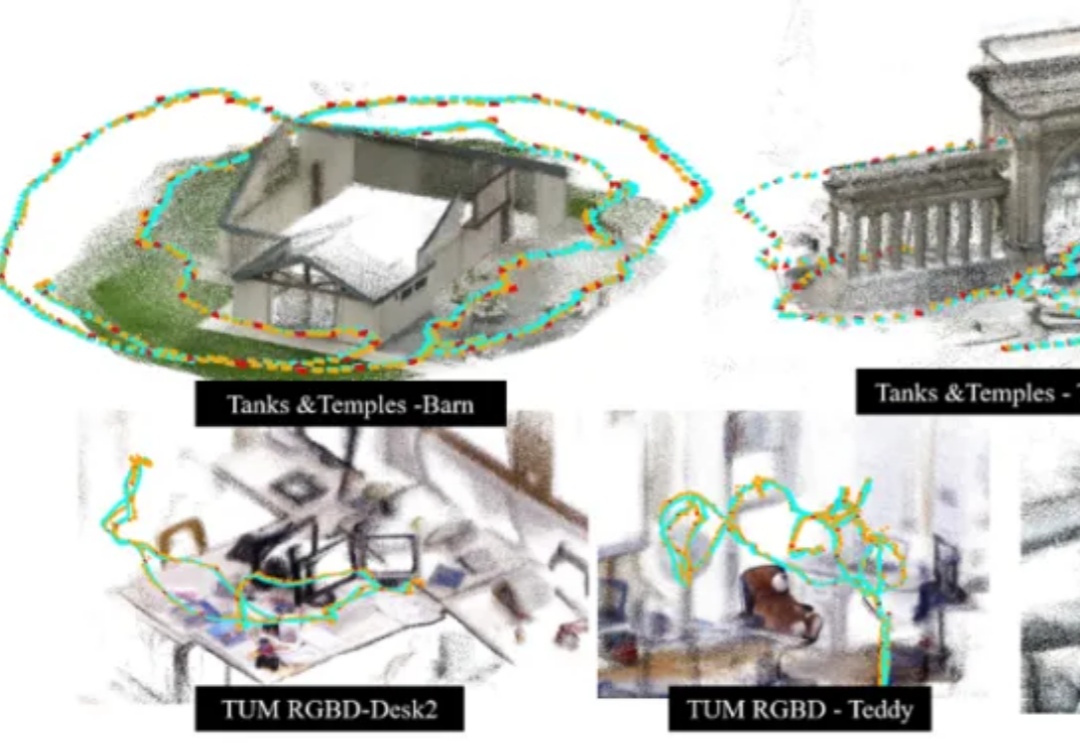
香港科技大学谭平教授团队与地平线(Horizon Robotics)团队最新发布了一项 3D 场景表征与大规模重建新方法 SAIL-Recon,通过锚点图建立构建场景全局隐式表征,突破现有 VGGT 基础模型对于大规模视觉定位与 3D 重建的处理能力瓶颈,实现万帧级的场景表征抽取与定位重建,将空间智能「3D 表征与建模」前沿推向一个新的高度。
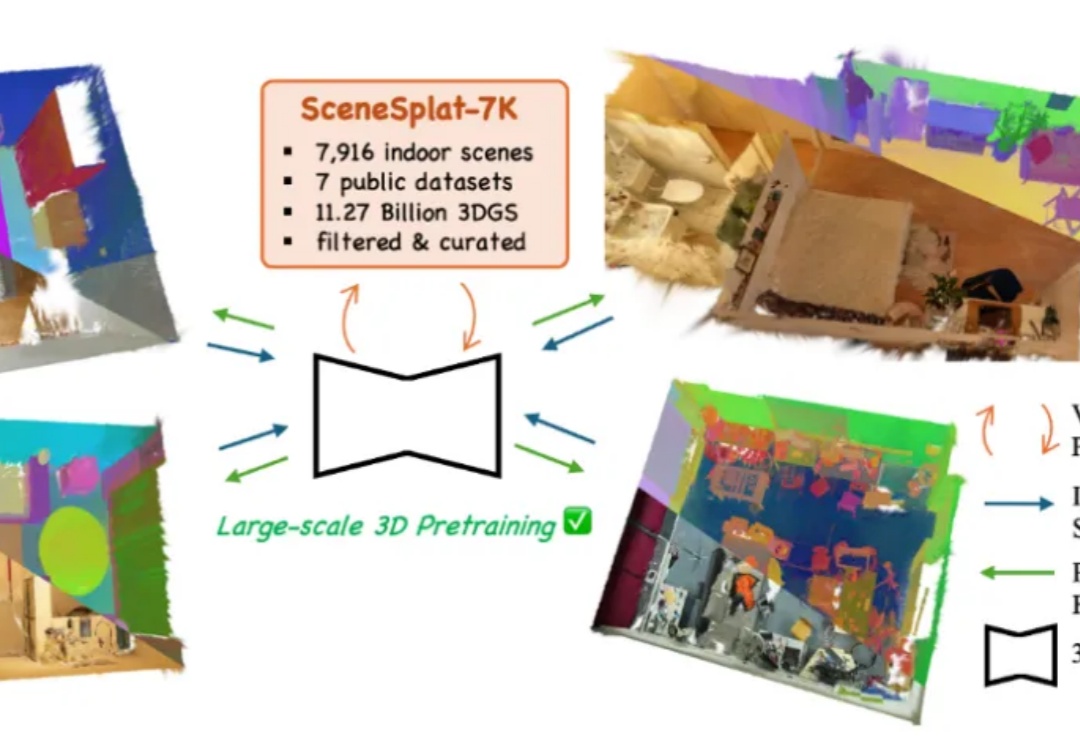
开放词汇识别与分类对于全面理解现实世界的 3D 场景至关重要。目前,所有现有方法在训练或推理过程中都依赖于 2D 或文本模态。这凸显出缺乏能够单独处理 3D 数据以进行端到端语义学习的模型,以及训练此类模型所需的数据。与此同时,3DGS 已成为各种视觉任务中 3D 场景表达的重要标准之一。
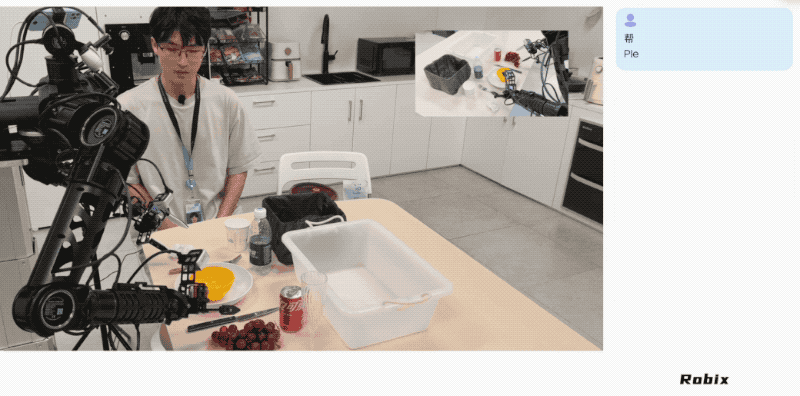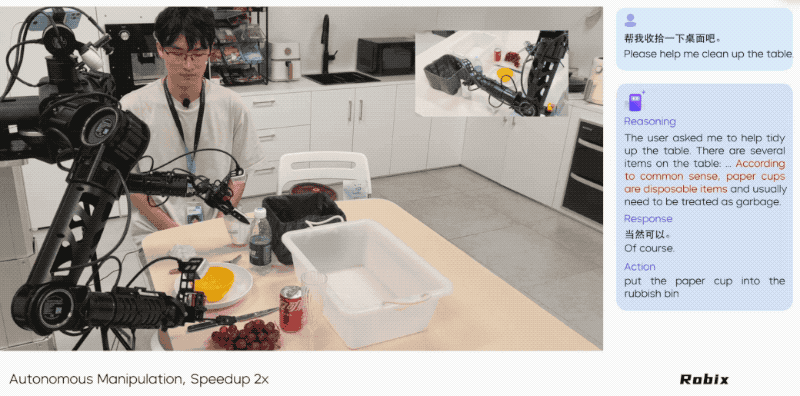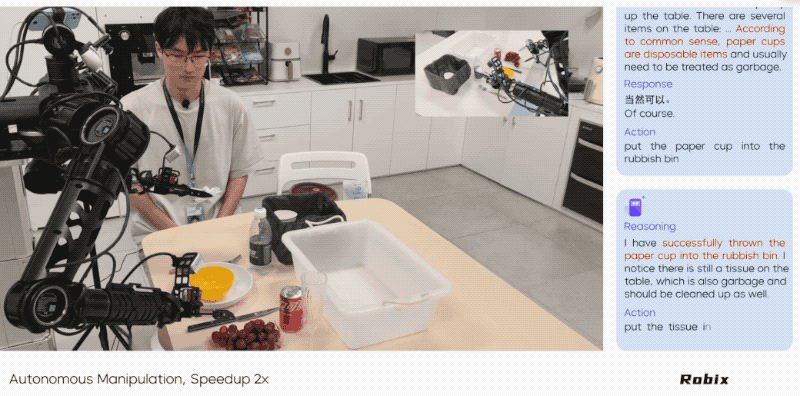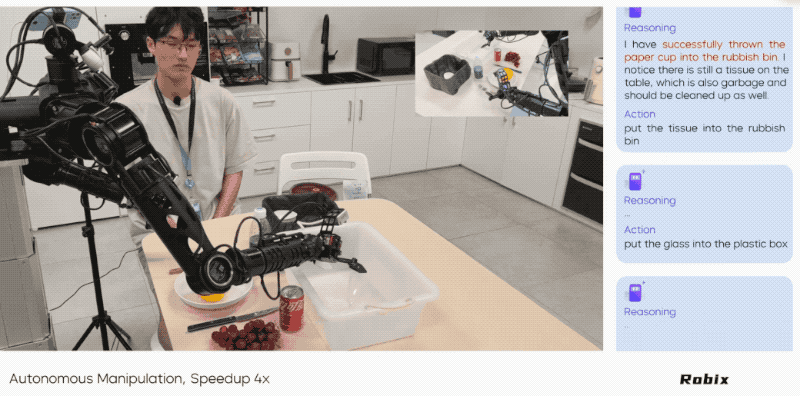
机器人终于不用散装大脑了! 字节Seed一个模型就能搞定机器人推理、任务规划和自然语言交互。
就在刚刚,斯坦福大学经典 CV 课程 ——《CS231n:深度学习与计算机视觉》(2025 春季)正式上线了!课程网站:https://cs231n.stanford.edu/该系列课程深入探讨了深度学习架构的细节,并重点关注围绕图像分类、定位和检测等视觉识别任务的端到端模型学习,尤其是图像分类领域。
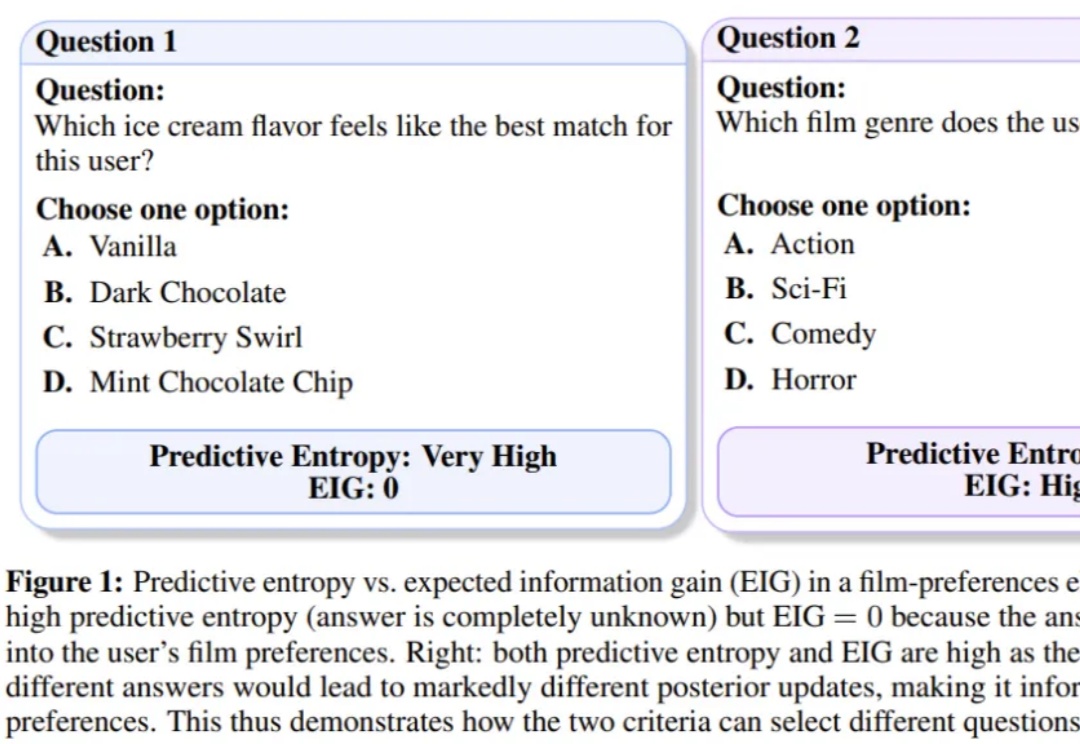
在这场以大型语言模型(LLM)为核心的 AI 浪潮中,苹果似乎一直保持着低调,很少出现在技术报道的前沿。尽管如此,时不时地,该公司也能拿出一些非常亮眼的研究成果,比如能在 iPhone 上直接运行的高效视觉语言模型 FastVLM。
近期,多模态大模型在图像问答与视觉理解等任务中进展迅速。随着 Vision-R1 、MM-Eureka 等工作将强化学习引入多模态推理,数学推理也得到了一定提升。
据申妈朋友圈报道,字节Seed大模型视觉基础研究团队负责人冯佳时已正式离职。根据其在字节的职级体系判断,他的级别应在4-1或4-2之间,属于公司最为稀缺的核心研究序列。冯佳时后续去向或是AI创业。
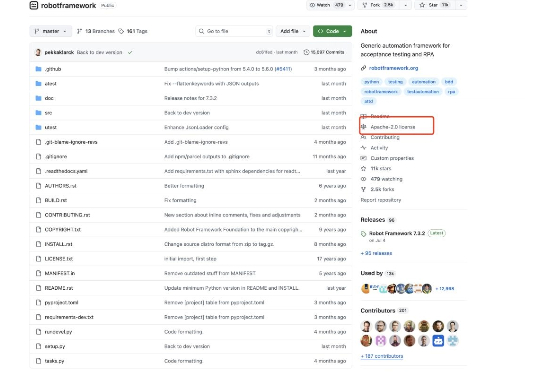
github排名第一,视觉模型与自动化 这两年,RPA+AI(智能自动化流程)经常被提及,在企业/机构数字化转型过程中,自动化和智能化是提升效能的重要方式,而迈向自动化和智能化的第一步则是机器人流程自动化(RPA)。