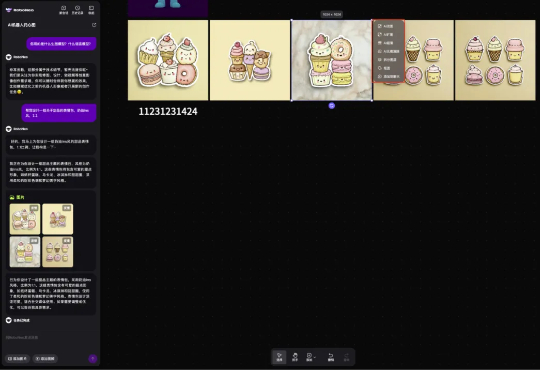
完全免费开放,美图上线AI视觉Agent
完全免费开放,美图上线AI视觉Agent本来以为美图可能会在 8 月份推出新产品,给中期财报壮声势,但没想到,公告发布 20 天不到,这款名为 RoboNeo 的 AI Agent 就上线了,而且是直接面向所有用户免费开放。
来自主题: AI资讯
11715 点击 2025-07-14 22:16

 搜索
本来以为美图可能会在 8 月份推出新产品,给中期财报壮声势,但没想到,公告发布 20 天不到,这款名为 RoboNeo 的 AI Agent 就上线了,而且是直接面向所有用户免费开放。
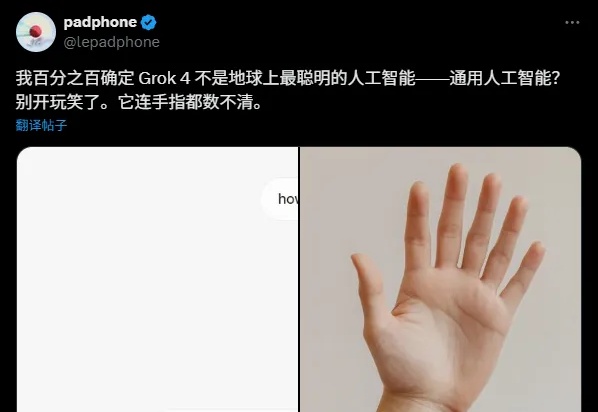
昨天Grok4发布完以后,我随手刷了一下X。
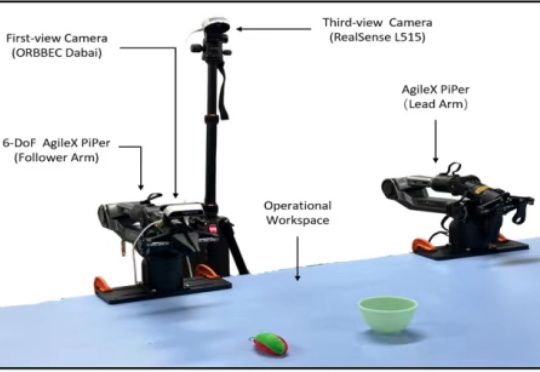
近年来,视觉 - 语言 - 动作(Vision-Language-Action, VLA)模型因其出色的多模态理解与泛化能力,已成为机器人领域的重要研究方向。尽管相关技术取得了显著进展,但在实际部署中,尤其是在高频率和精细操作等任务中,VLA 模型仍受到推理速度瓶颈的严重制约。
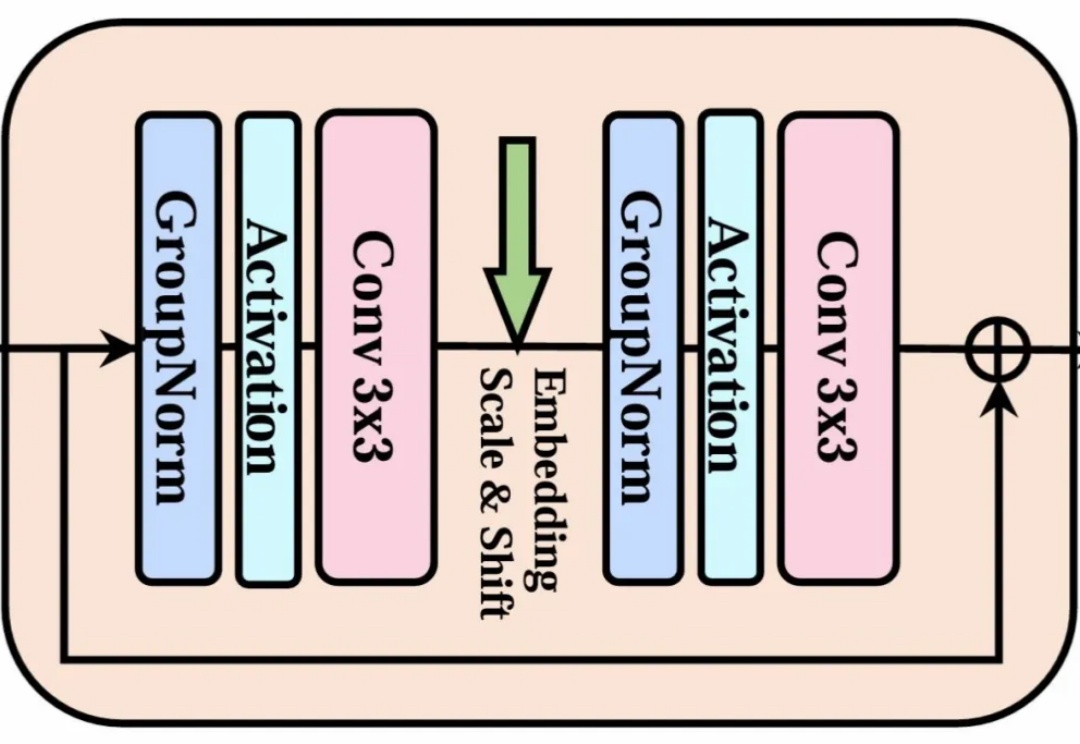
当整个 AI 视觉生成领域都在 Transformer 架构上「卷生卷死」时,一项来自北大、北邮和华为的最新研究却反其道而行之,重新审视了深度学习中最基础、最经典的模块——3x3 卷积。
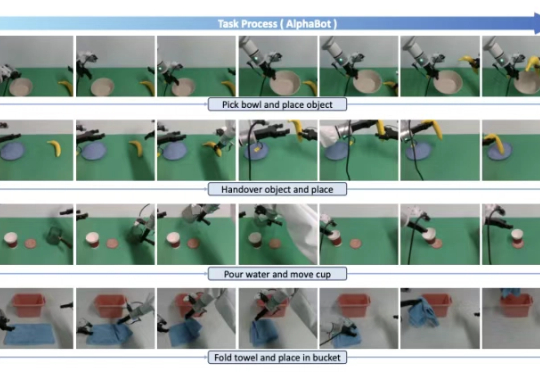
在机器人操控领域,实现高频响应与复杂推理的统一,一直是一个重大技术挑战。近期,北京大学与香港中文大学的研究团队联合发布了名为 Fast-in-Slow(FiS-VLA) 的全新双系统视觉 - 语言 - 动作模型。
MoCa框架把单向视觉语言模型转化为双向多模态嵌入模型,通过持续预训练和异构对比微调,提升模型性能和泛化能力,在多模态基准测试中表现优异,尤其小规模模型性能突出。
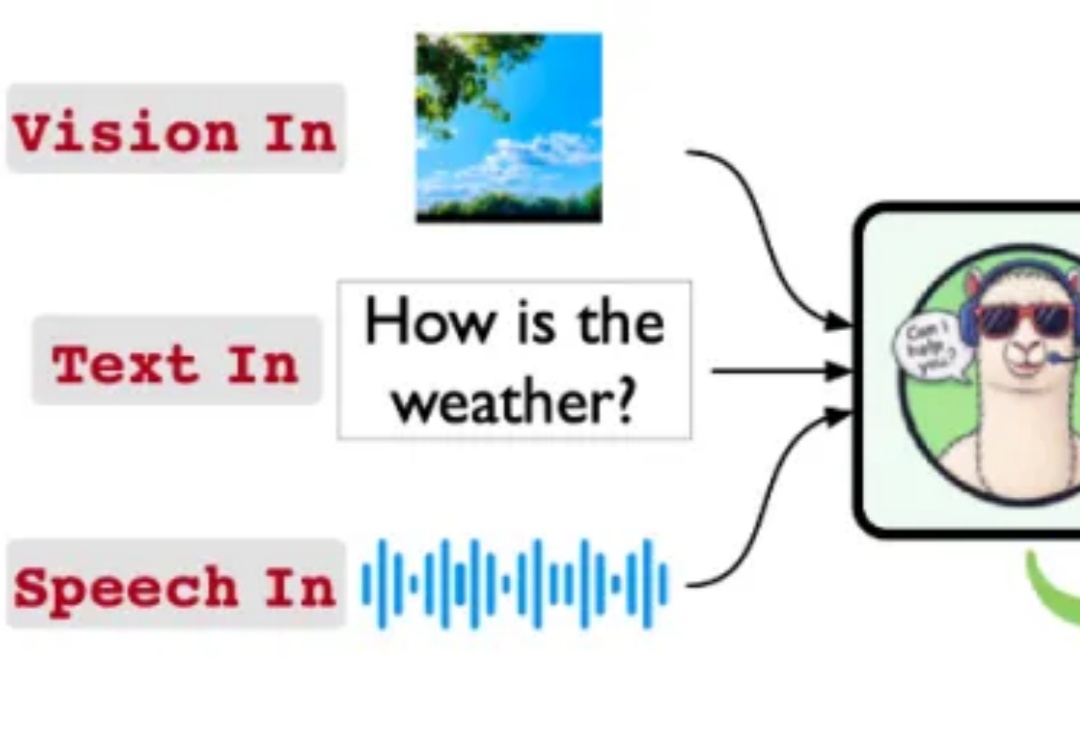
Stream-Omni:同时支持各种模态组合交互的文本-视觉-语音多模态大模型
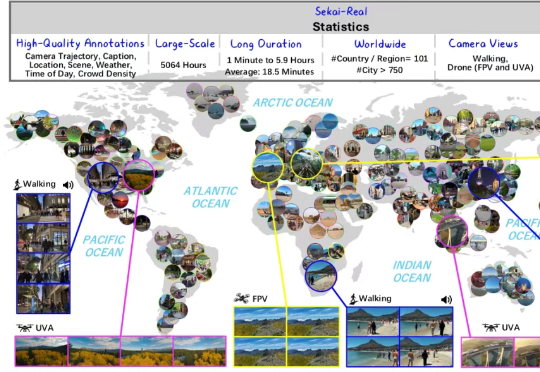
现在,国内研究机构就从数据基石的角度出发,拿出了还原真实动态世界的新进展:上海人工智能实验室、北京理工大学、上海创智学院、东京大学等机构聚焦世界生成的第一步——世界探索,联合推出一个持续迭代的高质量视频数据集项目——Sekai(日语意为“世界”),服务于交互式视频生成、视觉导航、视频理解等任务,旨在利用图像、文本或视频构建一个动态且真实的世界,可供用户不受限制进行交互探索。
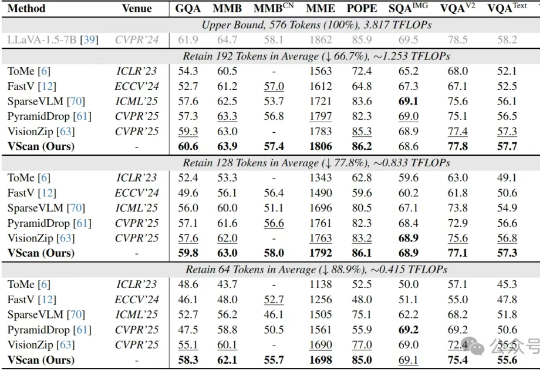
多图像、长视频、细粒度感知正在让大型视觉语言模型(LVLM)变得越来越聪明,但也越来越“吃不消”:视觉Token数量的激增所带来的推理成本暴涨,正逐渐成为多模态智能扩展的最大算力瓶颈。
一次性揭秘Gemini多模态技术!就在刚刚,Gemini模型行为产品负责人Ani Baddepudi在谷歌自家的开发者频道开启了爆料模式。