AI资讯新闻榜单内容搜索-视觉

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 视觉
超CLIP准确率11%!伯克利港大阐明「LLM文本-视觉」对齐深层机制

超CLIP准确率11%!伯克利港大阐明「LLM文本-视觉」对齐深层机制

超CLIP准确率11%!伯克利港大阐明「LLM文本-视觉」对齐深层机制

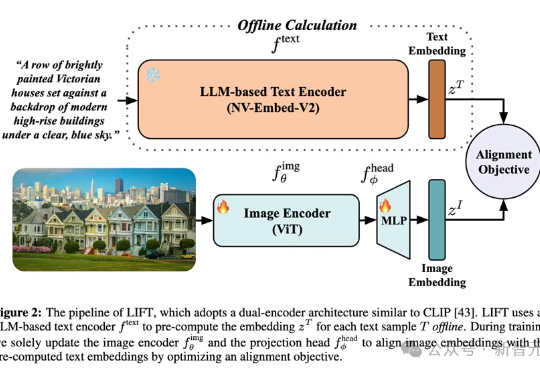
多模态对齐模型借助对比学习在检索与生成任务中大放异彩。最新趋势是用冻结的大语言模型替换自训文本编码器,从而在长文本与大数据场景中降低算力成本。LIFT首次系统性地剖析了此范式的优势来源、数据适配性、以及关键设计选择,在组合语义理解与长文本任务上观察到大幅提升。

来自主题: AI技术研报
8810 点击    2025-07-03 11:00
画到哪,动到哪!字节跳动发布视频生成「神笔马良」ATI,已开源!

画到哪,动到哪!字节跳动发布视频生成「神笔马良」ATI,已开源!

画到哪,动到哪!字节跳动发布视频生成「神笔马良」ATI,已开源!

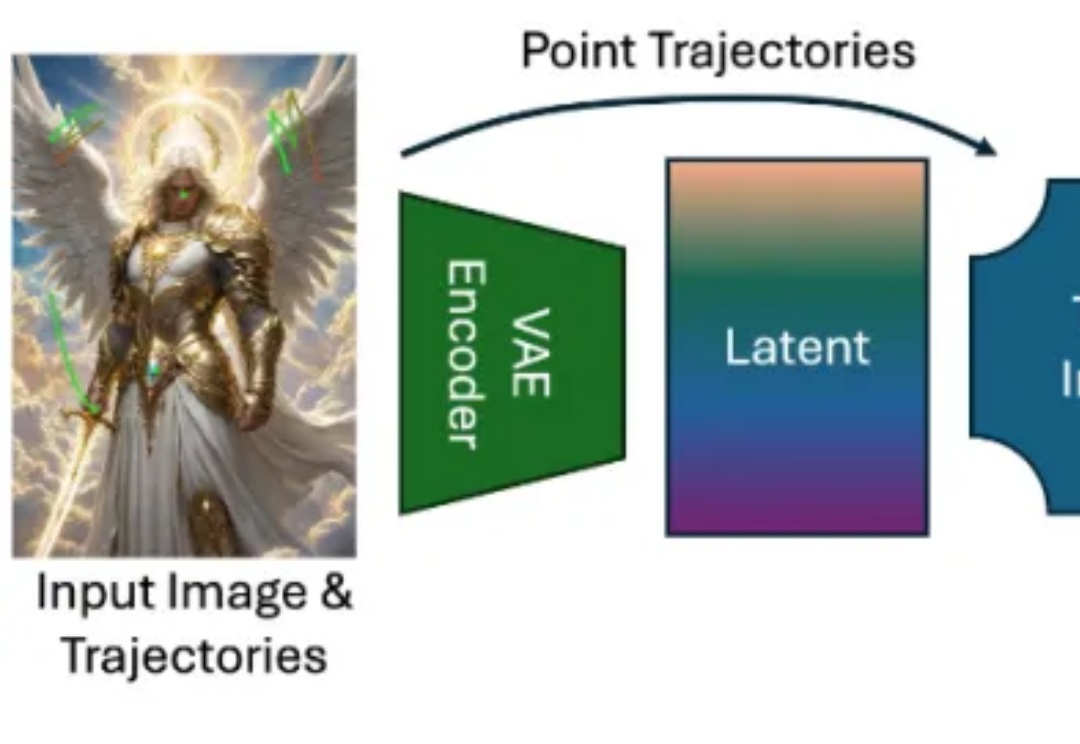
近年来,随着扩散模型(Diffusion Models)、Transformer 架构与高性能视觉理解模型的蓬勃发展,视频生成任务取得了令人瞩目的进展。从静态图像生成视频的任务(Image-to-Video generation)尤其受到关注,其关键优势在于:能够以最小的信息输入生成具有丰富时间连续性与空间一致性的动态内容。
来自主题: AI技术研报
10483 点击    2025-07-03 10:07
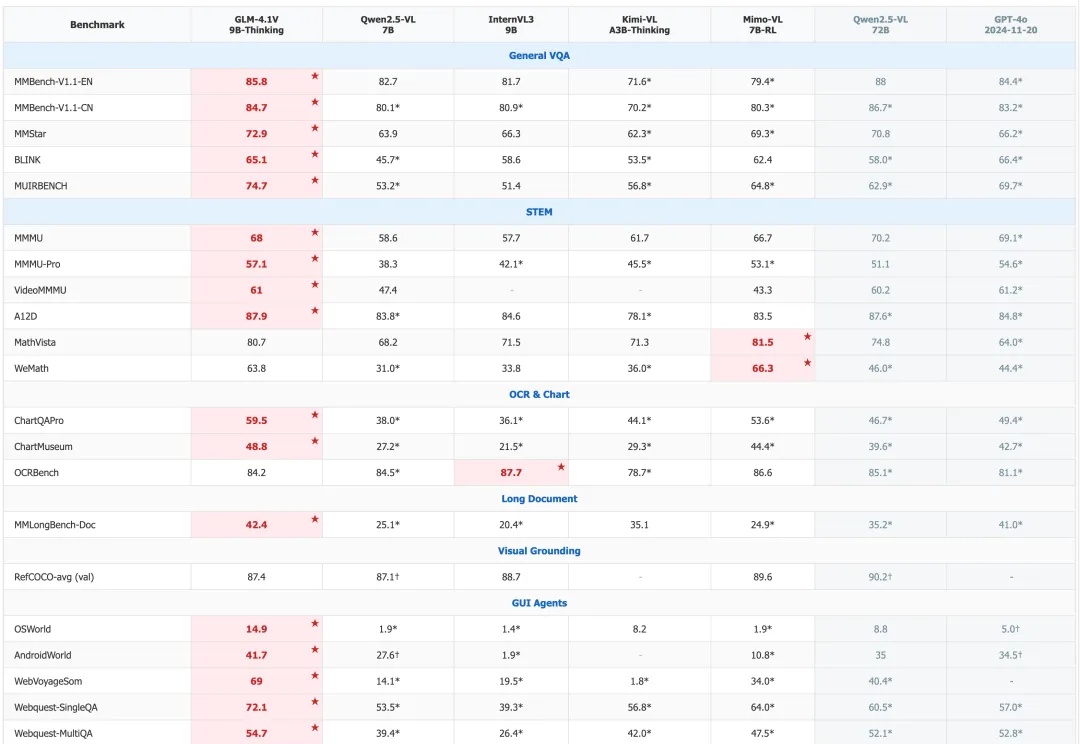
我们用世界名画和Meme“拷打”了智谱9B的视觉推理模型,结果出人意料

我们用世界名画和Meme“拷打”了智谱9B的视觉推理模型,结果出人意料

我们用世界名画和Meme“拷打”了智谱9B的视觉推理模型,结果出人意料

2025年上半年,AI开源领域的竞赛异常激烈,主要围绕着几个核心方向展开:首先是效率竞赛,各路玩家不再单纯追求千亿、万亿参数的“巨无霸”模型,而是更专注于通过新架构和训练方法,用更小的参数实现更强的性能。其次,多模态已成标配,纯文本模型越来越少,新发布的旗舰模型几乎都具备了处理图像、视频等多种信息的能力。
来自主题: AI产品测评
12269 点击    2025-07-02 17:31
大模型时代,通用视觉模型将何去何从?

大模型时代,通用视觉模型将何去何从?

大模型时代,通用视觉模型将何去何从?

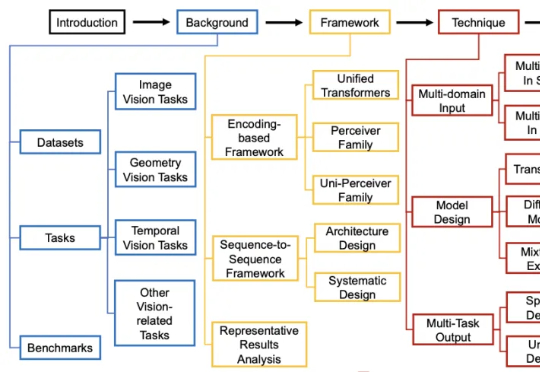
过去几年,通用视觉模型(Vision Generalist Model,简称 VGM)曾是计算机视觉领域的研究热点。
来自主题: AI技术研报
10820 点击    2025-07-02 10:52
重磅!华为联手顶级三甲,AI医疗大模型开源!

重磅!华为联手顶级三甲,AI医疗大模型开源!

重磅!华为联手顶级三甲,AI医疗大模型开源!

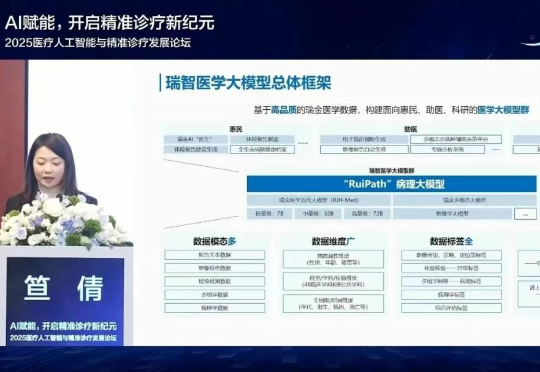
6月30日,上海交通大学医学院附属瑞金医院宣布,RuiPath病理大模型的视觉基础模型正式开源。
来自主题: AI资讯
8523 点击    2025-07-02 10:43
ICML 2025 Spotlight | 清华朱军组&NVIDIA提出DDO:扩散/自回归模型训练新范式,刷新图像生成SOTA

ICML 2025 Spotlight | 清华朱军组&NVIDIA提出DDO:扩散/自回归模型训练新范式,刷新图像生成SOTA

ICML 2025 Spotlight | 清华朱军组&NVIDIA提出DDO:扩散/自回归模型训练新范式,刷新图像生成SOTA

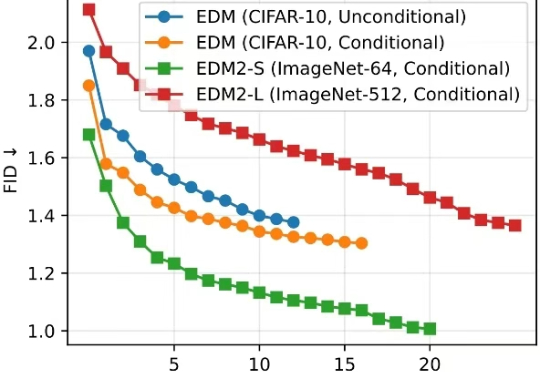
清华大学朱军教授团队与 NVIDIA Deep Imagination 研究组联合提出一种全新的视觉生成模型优化范式 —— 直接判别优化(DDO)。
来自主题: AI技术研报
9376 点击    2025-07-02 10:33
UofT、UBC、MIT和复旦等联合发布:扩散模型驱动的异常检测与生成全面综述

UofT、UBC、MIT和复旦等联合发布:扩散模型驱动的异常检测与生成全面综述

UofT、UBC、MIT和复旦等联合发布:扩散模型驱动的异常检测与生成全面综述

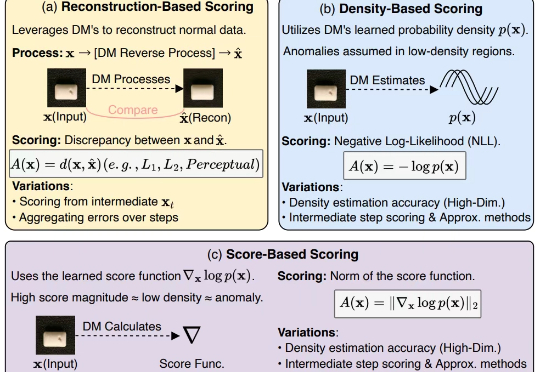
扩散模型(Diffusion Models, DMs)近年来展现出巨大的潜力,在计算机视觉和自然语言处理等诸多任务中取得了显著进展,而异常检测(Anomaly Detection, AD)作为人工智能领域的关键研究任务,在工业制造、金融风控、医疗诊断等众多实际场景中发挥着重要作用。
来自主题: AI资讯
8342 点击    2025-07-01 10:55
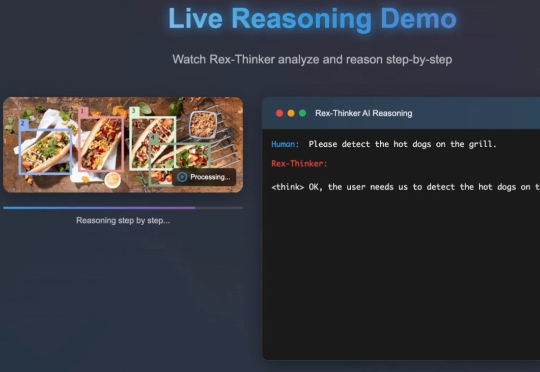
会“思考”的目标检测模型来了!IDEA提出Rex-Thinker:基于思维链的指代物体检测模型,准确率+可解释性双突破

会“思考”的目标检测模型来了!IDEA提出Rex-Thinker:基于思维链的指代物体检测模型,准确率+可解释性双突破

会“思考”的目标检测模型来了!IDEA提出Rex-Thinker:基于思维链的指代物体检测模型,准确率+可解释性双突破

在日常生活中,我们常通过语言描述寻找特定物体:“穿蓝衬衫的人”“桌子左边的杯子”。如何让 AI 精准理解这类指令并定位目标,一直是计算机视觉的核心挑战。
来自主题: AI技术研报
10120 点击    2025-07-01 10:11
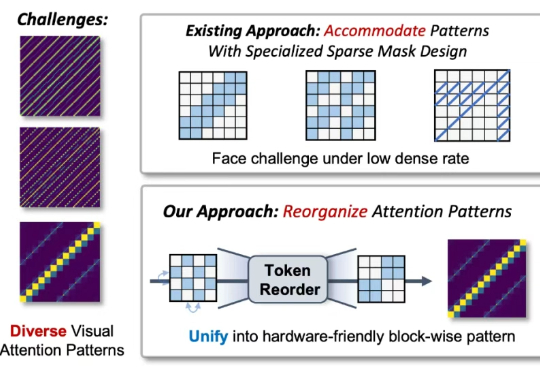
用好视觉Attention局部性,清华、字节提出Token Reorder,无损实现5倍稀疏、4比特量化

用好视觉Attention局部性,清华、字节提出Token Reorder,无损实现5倍稀疏、4比特量化

用好视觉Attention局部性,清华、字节提出Token Reorder,无损实现5倍稀疏、4比特量化

近年来,随着视觉生成模型的发展,视觉生成任务的输入序列长度逐渐增长(高分辨率生成,视频多帧生成,可达到 10K-100K)。

来自主题: AI技术研报
8092 点击    2025-06-30 15:35