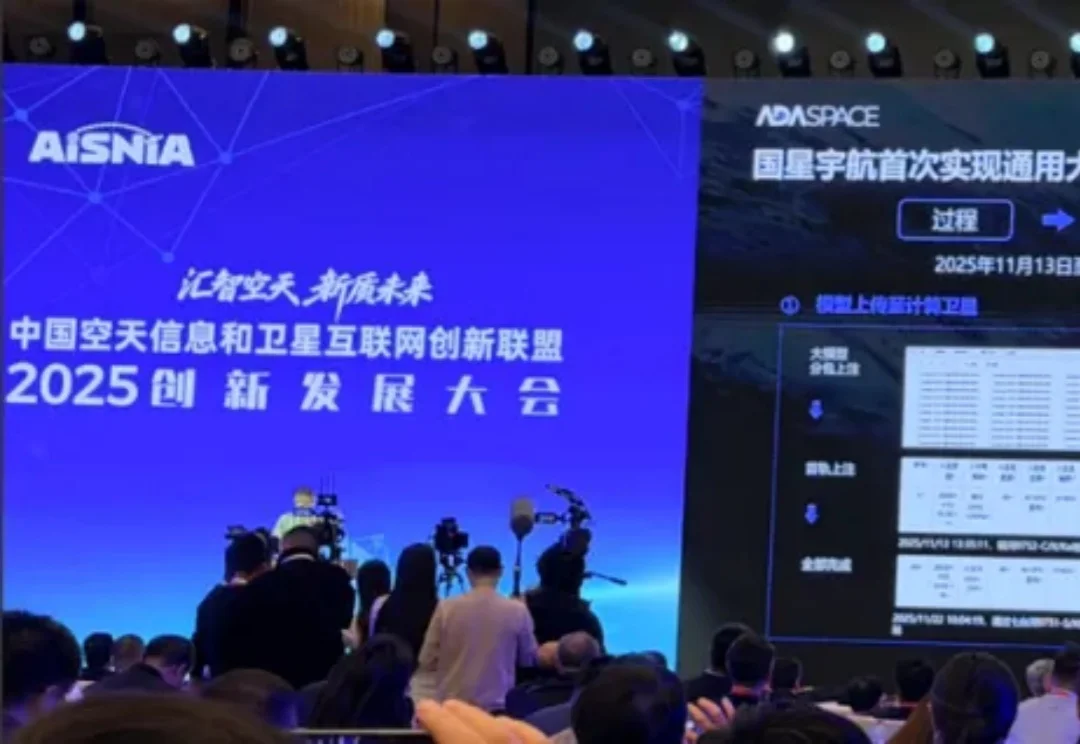
中国团队引领太空算力:首次太空在轨部署通用大模型,发2800颗卫星服务数亿硅基智能体
中国团队引领太空算力:首次太空在轨部署通用大模型,发2800颗卫星服务数亿硅基智能体岁末年初,全球AI竞争聚焦到了最新趋势—— 太空算力。
来自主题: AI资讯
11648 点击 2026-01-28 15:32

 搜索
岁末年初,全球AI竞争聚焦到了最新趋势—— 太空算力。
这几天,相信大家肯定都被一个产品名给刷屏了。
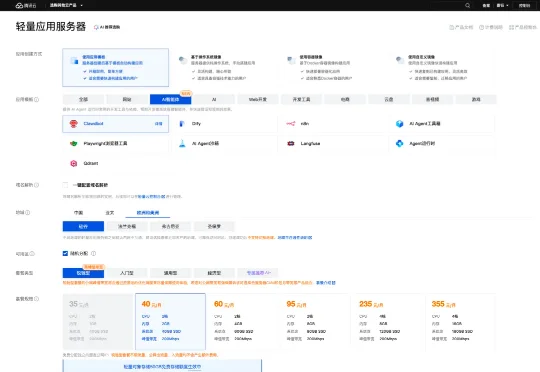
相较于筹备实体硬件涉及的购置成本、时间及后续电费,云服务器显然是更快捷、经济的选择。而轻量应用服务器 Lighthouse 具备开箱即用、高性价比及免运维的特性,与 Clawdbot 的部署需求完美契合。
过去一整年,具身智能成了 AI 行业里最被反复提及、却最难真正落地的方向。一边是人形机器人发布会密集登场,另一边却始终缺乏可规模部署的现实成果。算法在进步,算力在堆叠,但问题始终没有改变:机器人到底该如何被教会在真实世界中行动。
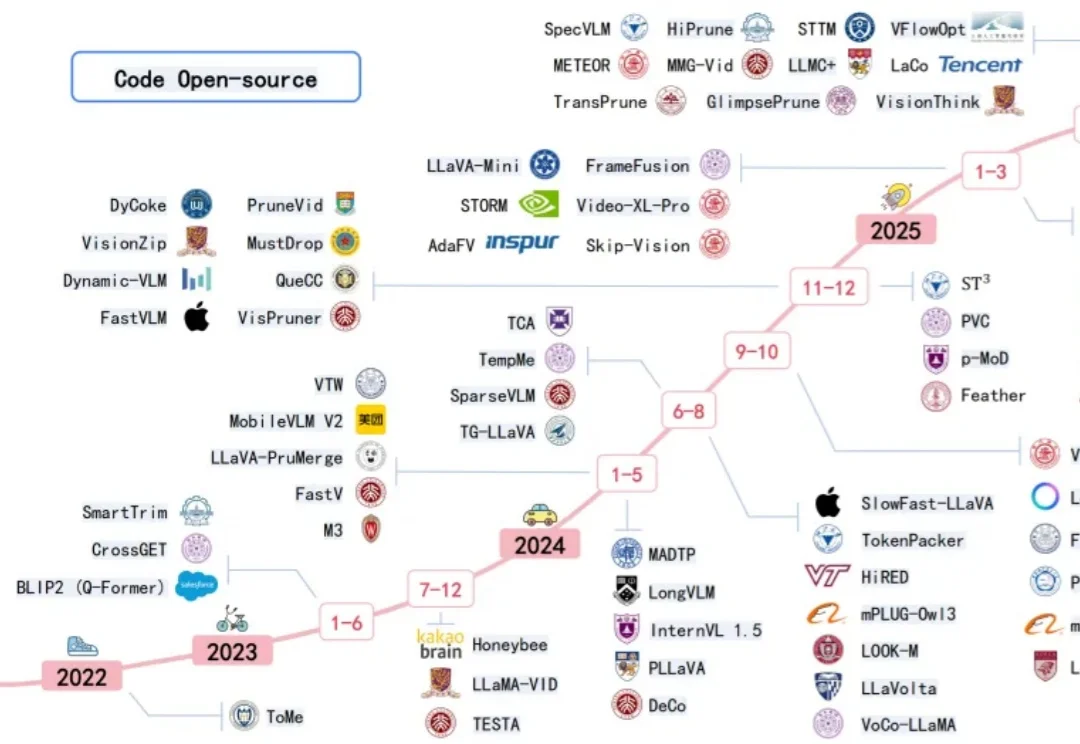
近年来多模态大模型在视觉感知,长视频问答等方面涌现出了强劲的性能,但是这种跨模态融合也带来了巨大的计算成本。高分辨率图像和长视频会产生成千上万个视觉 token ,带来极高的显存占用和延迟,限制了模型的可扩展性和本地部署。
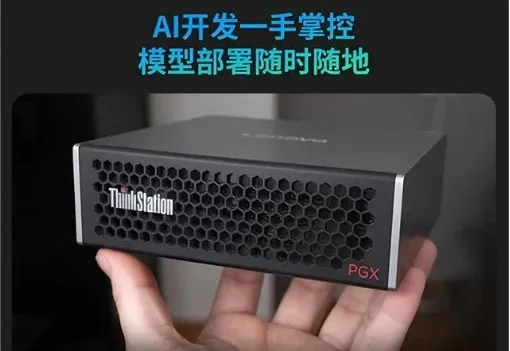
随着AI浪潮的袭来,笔者本人以及团队都及时的调整了业务方向,转型为一名AI开发者和AI产品开发团队,常常需要微调大模型注入业务场景依赖的私域知识,然后再把大模型部署上线进行推理,以支撑业务智能体或智能问答产品的逻辑流程。
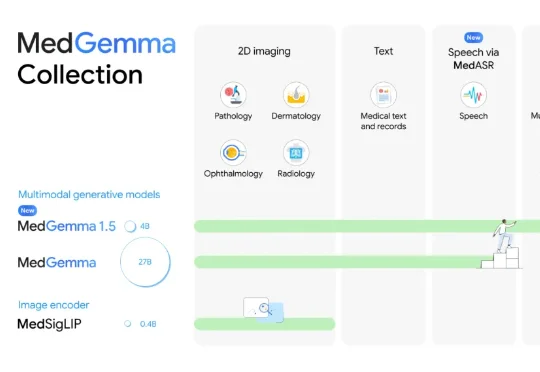
刚刚,AI医疗新突破,来自谷歌!这一次,他们直接瞄准了真实临床环境的痛点。为此,谷歌祭出了最新模型MedGemma 1.5,找到了破局答案。相较于此前的MedGemma 1.5,MedGemma 1.5在多模态应用上实现重大突破,融合了:
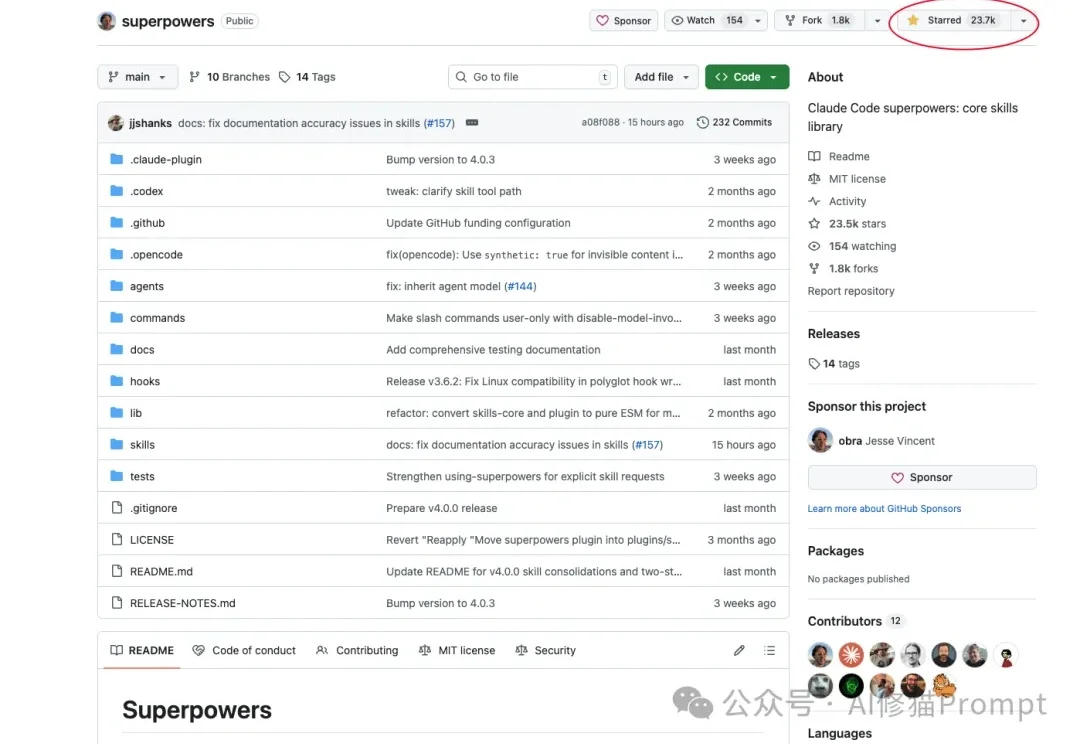
这是一个拥有23.7k star的Skills开源项目。支持一键部署在Claude code、Codex以及最近非常火的Opencode。
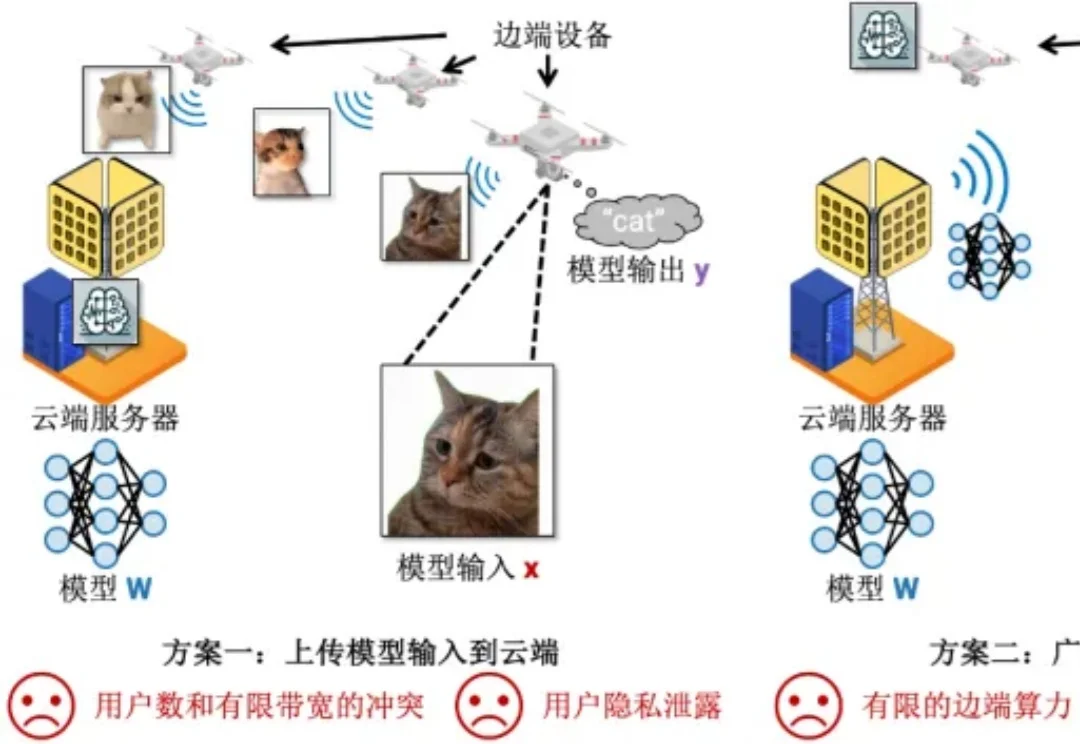
机器学习部署在边端设备的时候,模型总是存储在云端服务器上(5G 基站),而模型输入输出总是在边端设备上(例如用照相机拍摄照片然后识别其中的目标)。在这种场景下,传统有以下两种方案完成机器学习的推理:
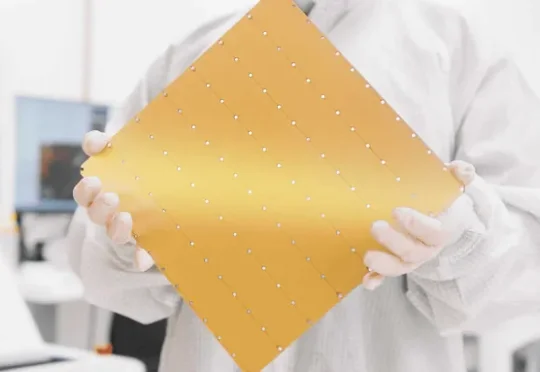
今天,OpenAI与美国AI芯片独角兽Cerebras联合宣布,将部署750兆瓦的Cerebras晶圆级系统,为OpenAI客户提供服务。该合作将于2026年起分阶段落地,并于2028年之前完成,建成后将成为全球规模最大的高速AI推理平台。