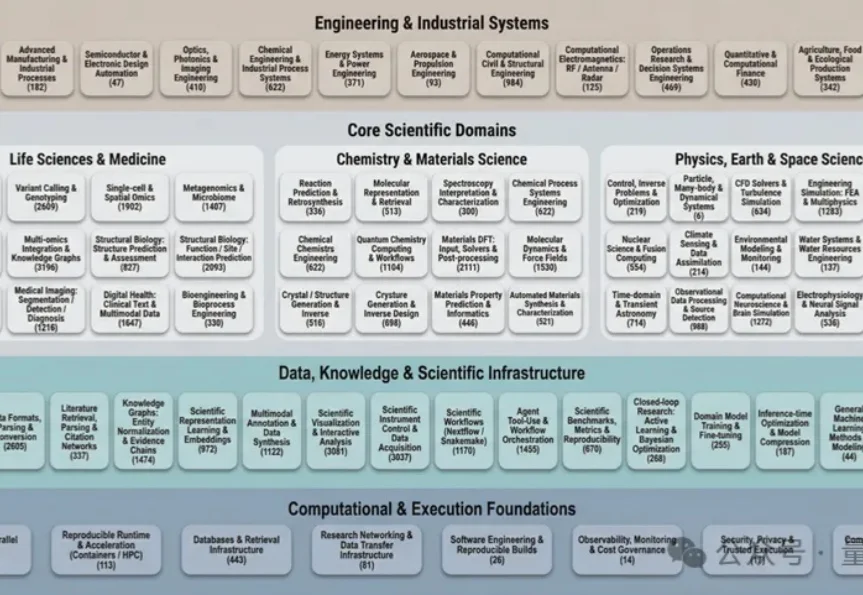
AI4S又一瓶颈被攻克:两个AI「吵架」,让科研代码部署成功率突破95%
AI4S又一瓶颈被攻克:两个AI「吵架」,让科研代码部署成功率突破95%过去几十年里,科学计算领域积累了数量空前的开源软件工具。
来自主题: AI技术研报
11598 点击 2026-01-14 10:01

 搜索
过去几十年里,科学计算领域积累了数量空前的开源软件工具。
没有代码,没有部署,没有服务器配置。我只是用"人话"描述了我想要什么,Google就帮我搞定了一切。
在真实世界中,部署并不是一个孤立步骤,而是一条连续链路:工具能否被发现、是否被正确理解、能否构建环境,以及是否真的可以被执行。Deploy-Master 正是围绕这条链路,被设计为一个以执行为中心的一站式自动化工作流。
昨晚,Anthropic 宣布已经部署了更严格的技术保障措施,用以防止第三方工具“伪装”为官方 Claude Code 客户端,从而绕过速率限制和计费机制,低成本调用底层 Claude 模型,此外,Anthropic 也被曝出切断了包括 xAI 在内的部分竞争对手对 Claude 模型的访问权限,其中 Cursor IDE 成为了关键的“触发点”。
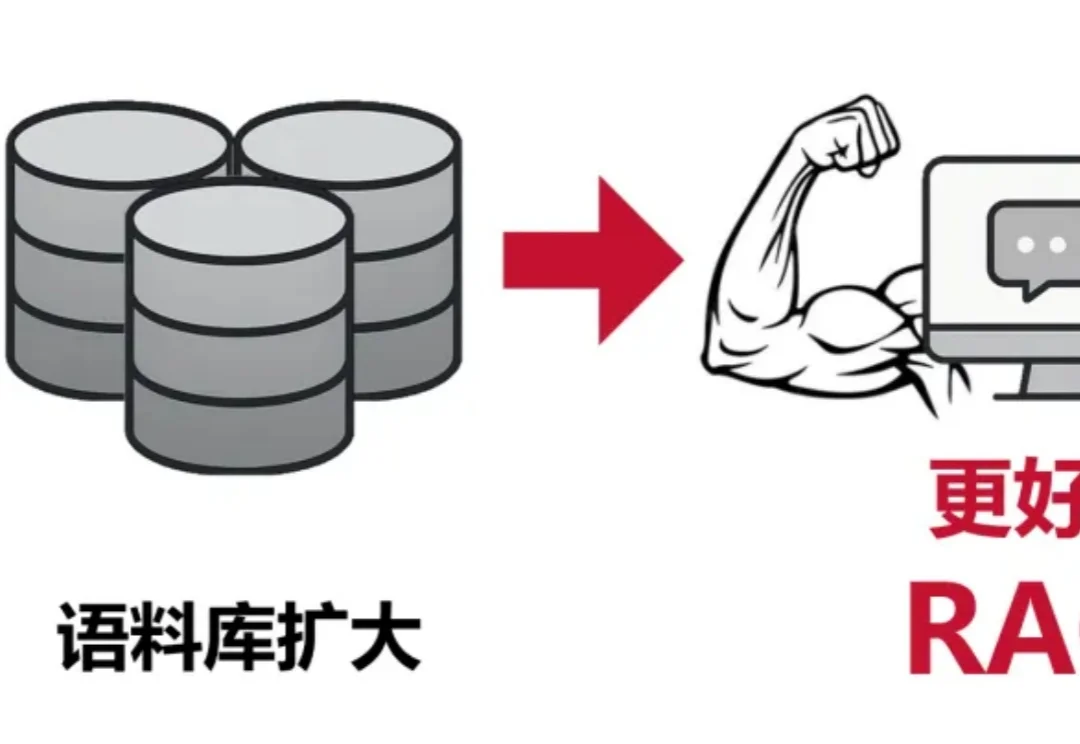
在检索增强生成中,扩大生成模型规模往往能提升准确率,但也会显著抬高推理成本与部署门槛。CMU 团队在固定提示模板、上下文组织方式与证据预算,并保持检索与解码设置不变的前提下,系统比较了生成模型规模与检索语料规模的联合效应,发现扩充检索语料能够稳定增强 RAG,并在多项开放域问答基准上让小中型模型在更大语料下达到甚至超过更大模型在较小语料下的表现,同时在更高语料规模处呈现清晰的边际收益递减。
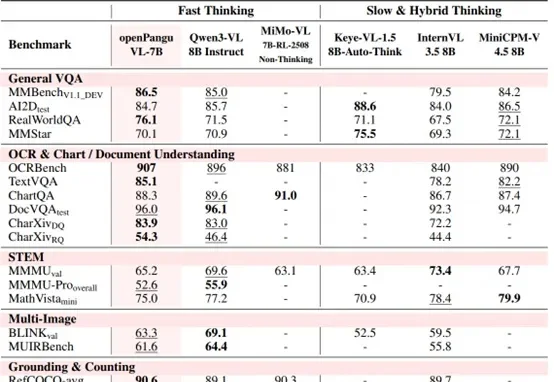
7B量级模型,向来是端侧部署与个人开发者的心头好。
大家好,我是袋鼠帝 在过去的2年里,我为了写教程,也为了让AI帮我躺平,前前后后试了上百种AI工具,有免费的,有付费的,有本地部署的。 有些工具很棒,有些一言难尽,甚至有些已经不在了 最近几天我把这2
近日,腾讯微信 AI 团队提出了 WeDLM(WeChat Diffusion Language Model),这是首个在工业级推理引擎(vLLM)优化条件下,推理速度超越同等 AR 模型的扩散语言模型。
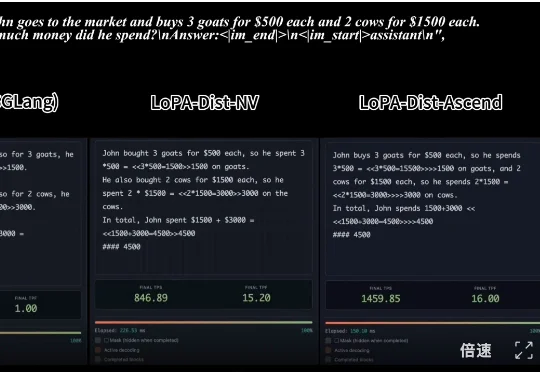
,时长 00:20 视频 1:单样例推理速度对比:SGLang 部署的 Qwen3-8B (NVIDIA) vs. LoPA-Dist 部署 (NVIDIA & Ascend)(注:NVIDIA 平台
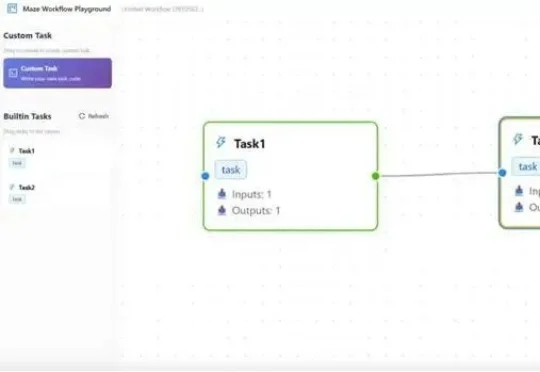
在大模型智能体(LLM Agent)落地过程中,复杂工作流的高效执行、资源冲突、跨框架兼容、分布式部署等问题一直困扰着开发者。而一款名为Maze的分布式智能体工作流框架,正以任务级精细化管理、智能资源调度、多场景部署支持等核心优势,为这些痛点提供一站式解决方案。