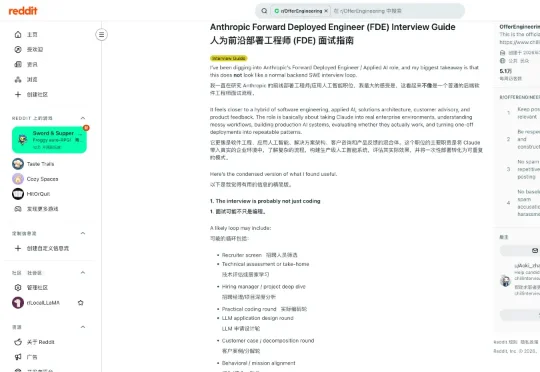
硅谷最火的新岗位,划出了 AI 时代职场的斩杀线
硅谷最火的新岗位,划出了 AI 时代职场的斩杀线FDE 是什么,这个最近在硅谷走红的岗位,怎么就突然成了 AI 公司招聘页面的热门。Forward Deployed Engineer 是 FDE 的全称,常译作前沿部署工程师或前线部署工程师。这类工程师既要写生产代码,也要懂 Agent、评测和安全;既要进入客户现场,又要决定什么问题值得解决。
来自主题: AI资讯
10089 点击 2026-08-30 12:16

 搜索
FDE 是什么,这个最近在硅谷走红的岗位,怎么就突然成了 AI 公司招聘页面的热门。Forward Deployed Engineer 是 FDE 的全称,常译作前沿部署工程师或前线部署工程师。这类工程师既要写生产代码,也要懂 Agent、评测和安全;既要进入客户现场,又要决定什么问题值得解决。
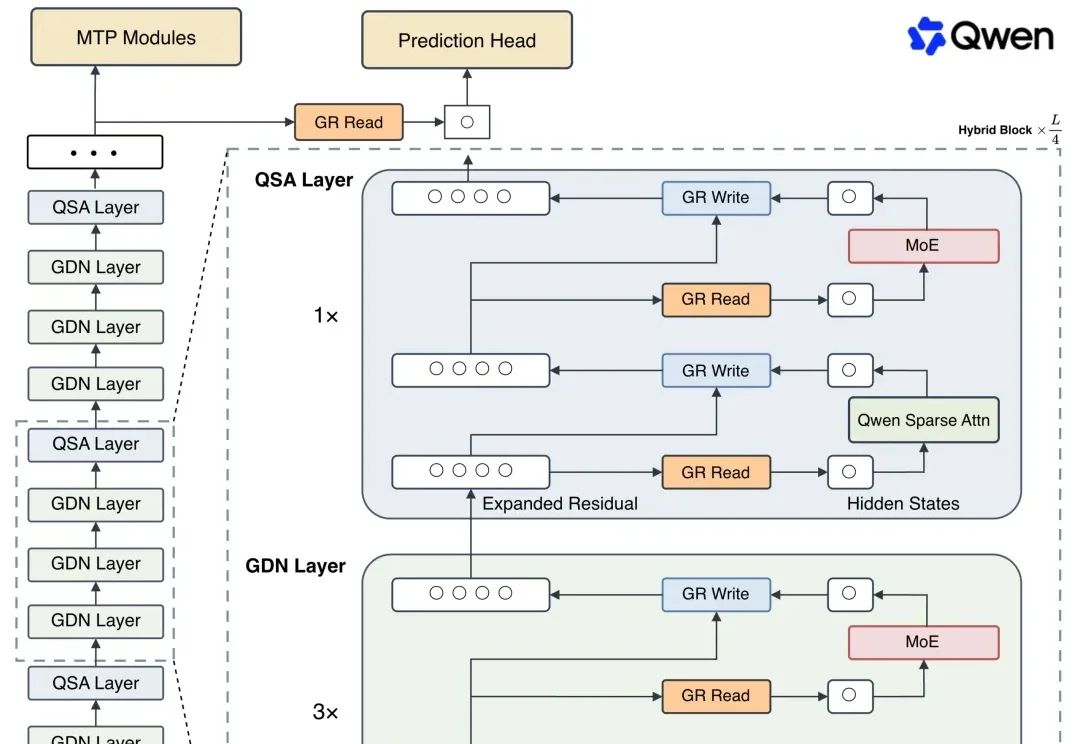
Qwen4还没出,架构先开源了。
业务覆盖企业私有化算力部署与自营Token工厂。 作者 | 杨京丽 编辑 | 李水青 智东西8月27日报道,昨日,北京AI基础设施创企博伦智汇宣布完成千万级天使轮融资。本轮融资由专注AI及AI Inf
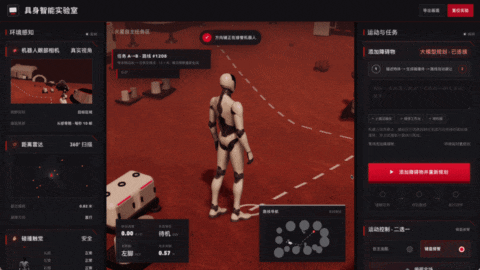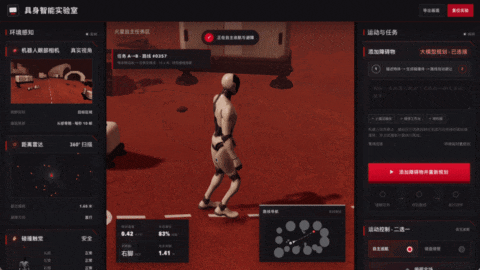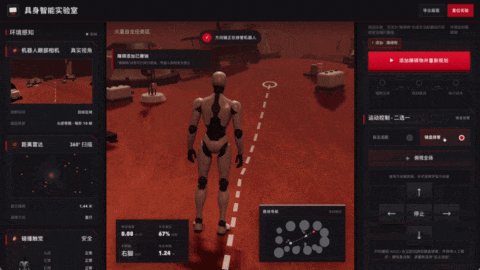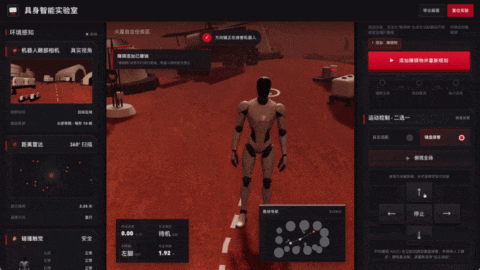
今天,飞象老师正式发布3.0版本。这次升级最值得关注的变化,是新增了“教育应用生成”能力。用户只需要在对话框里说清楚自己的需求和想法,几分钟后,就可以得到一个能够直接访问、调用AI、保存数据,并持续修改迭代的教育应用。整个过程中,不需要写代码,也不需要理解数据库、服务器和部署。
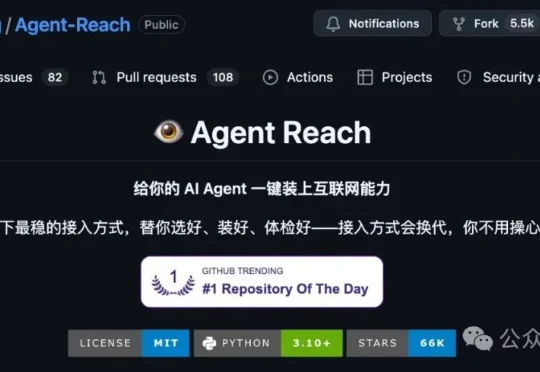
Agent-Reach,一句指令就能搞定全平台适配,15个主流平台最新一手资料随便读、随便搜,关键是还免费!该项目在GitHub上狂揽66k Star,热度还在一路暴涨!
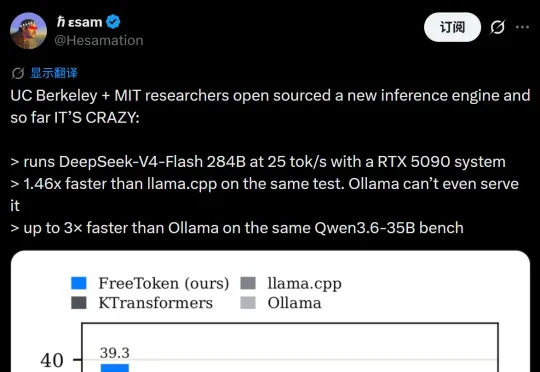
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
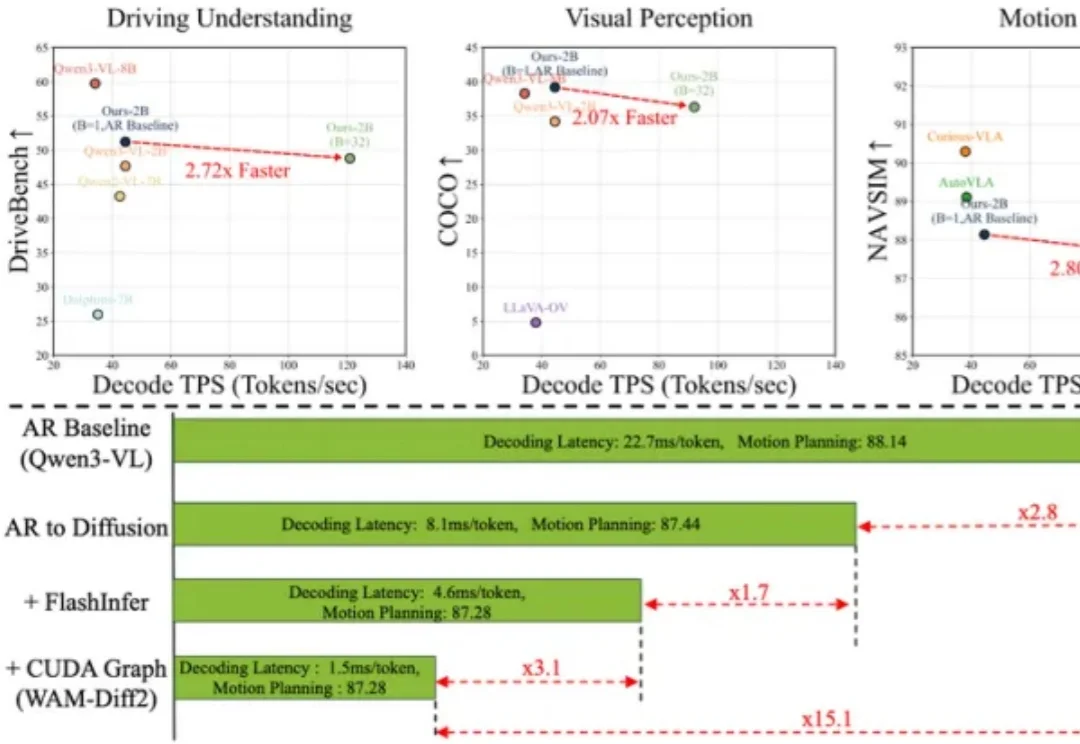
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。
今日,蚂蚁百灵大模型开源了一款轻量级混合推理MoE模型——Ling-3.0-tiny。该模型总参数量为7.9B,推理时激活参数量为1.3B,主要面向高效本地部署而设计。其同步提供BF16、FP8和INT4三个版本,已在DGX Spark、MacBook、Mac mini等设备上完成验证,兼顾性能、效率与可部署性。
当下计算机视觉长期陷入“一任务一专用模型”内卷: 做深度估计要用DepthAnything,分割依赖SAM,人体姿态单独训练Sapiens,几何重建还得搭VGGT,各类网络骨干、解码器、损失函数完全割裂,研发与部署成本居高不下。
AI替代人的同时,也在创造新工作。FDE(前沿部署工程师),成为今年最火的AI新岗位。这个职位的任务是驻场在客户现场,解决AI落地的问题。那些靠帮企业落地大模型赚钱的公司,已经把它做成了业务标配。