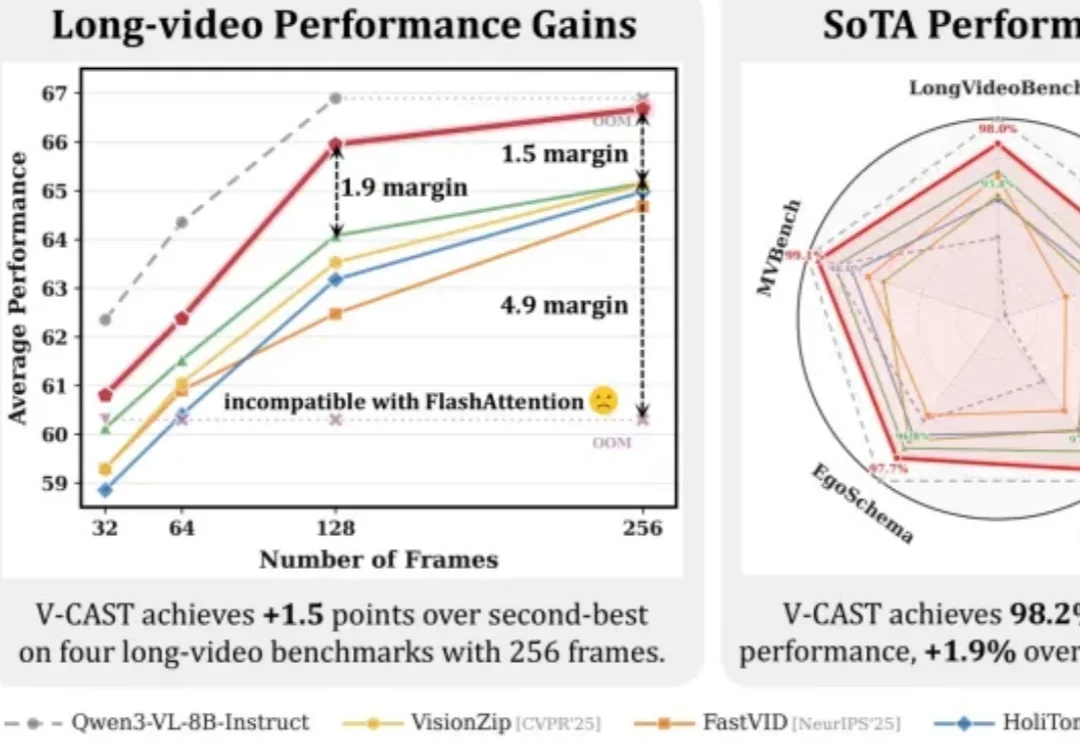
长视频推理耗时减半!中大、港理工等提出免训练压缩新方法|NeurIPS'26
长视频推理耗时减半!中大、港理工等提出免训练压缩新方法|NeurIPS'26AI看长视频,模型需要逐帧把画面编码成视觉Token,再送进语言模型理解。
来自主题: AI技术研报
6630 点击 2026-11-17 10:03

 搜索
AI看长视频,模型需要逐帧把画面编码成视觉Token,再送进语言模型理解。
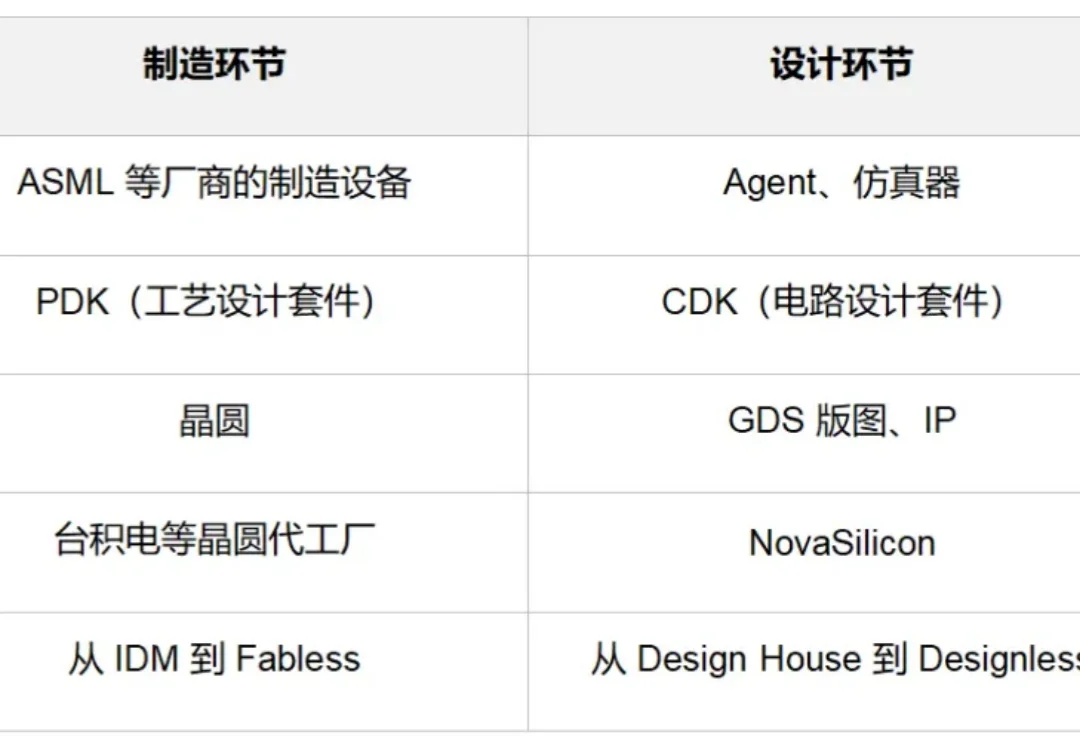
1987 年成立的台积电只做代工。晶圆厂把制造工艺封装成 PDK(Process Design Kit,工艺设计套件)交给客户,PDK 是晶圆厂的核心技术,通过有限接口分享给芯片公司 ,保留核心的制造配方。通过使用 PDK,芯片公司可以把制造交出去,自己专心做设计,这类公司被叫作 Fabless。
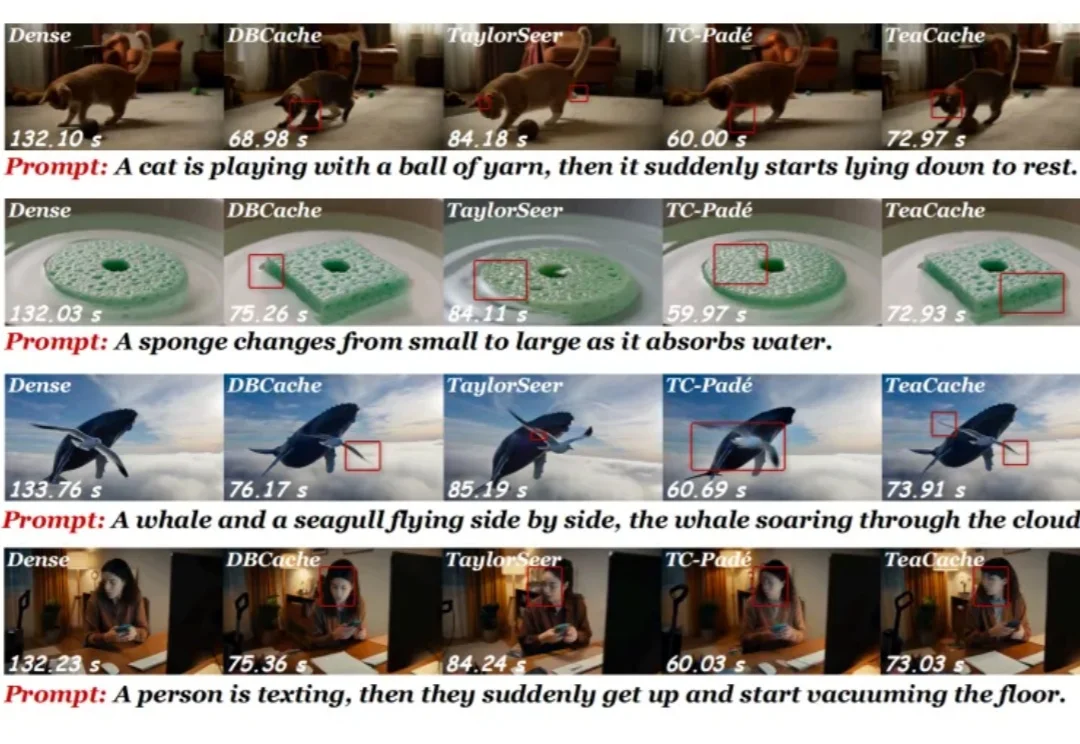
AI视频生成中,推理速度提升与生成质量下降,可能同时发生。
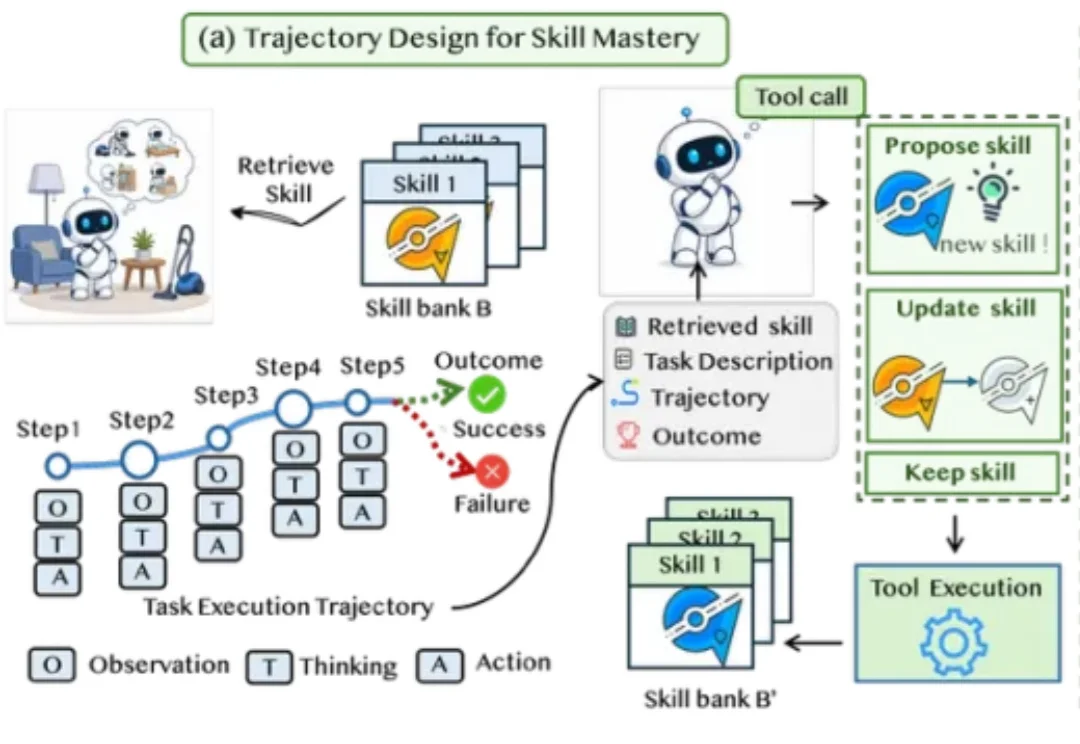
随着递归自我改进(Recursive Self-Improvement,RSI)研究的兴起,智能体的长期能力演进受到更多关注。技能(Skill)能够将交互经验提炼为可复用的操作流程与任务策略,使一次任务的收获服务于后续任务。让智能体学会自主创建和改进这些技能,为其持续进化提供了一条具体路径。
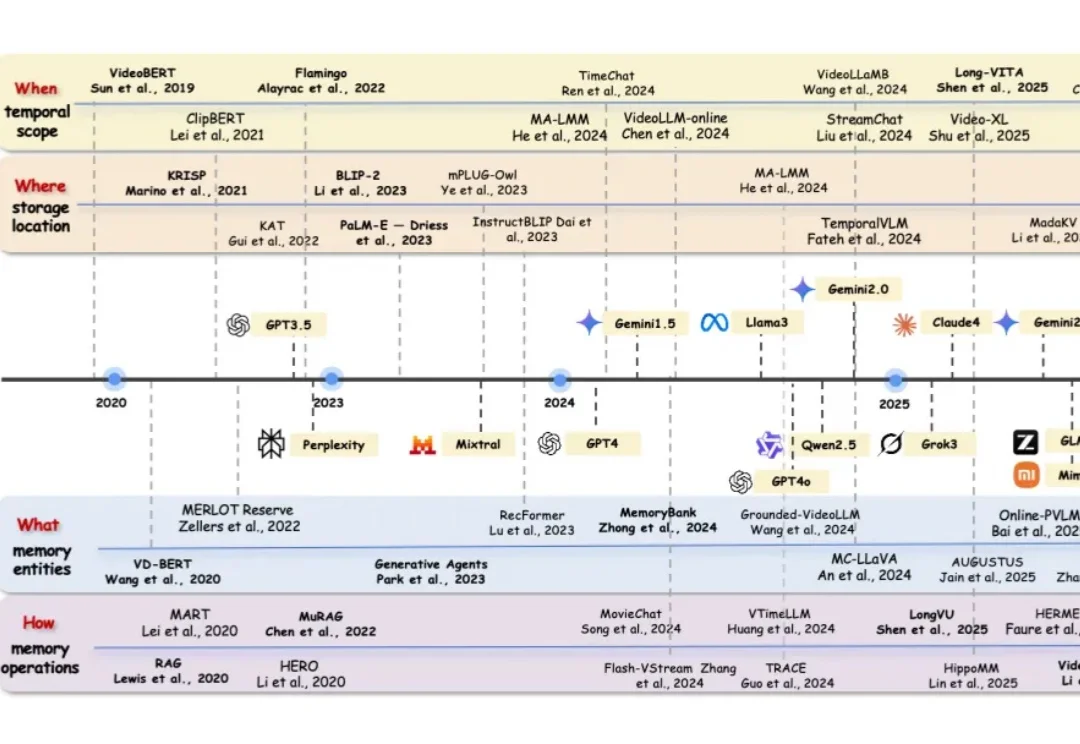
来自 Duke、Google、USC、UPenn、UNC 等八家机构的研究者联合发布最新视觉语言模型(VLM)记忆机制的系统性综述。基于全新的 4D 分类框架,系统梳理了 300 余篇相关工作和近 70 个评测基准,覆盖长视频理解与生成、多模态 RAG、具身导航与行动、个性化助手等八个热点应用场景。
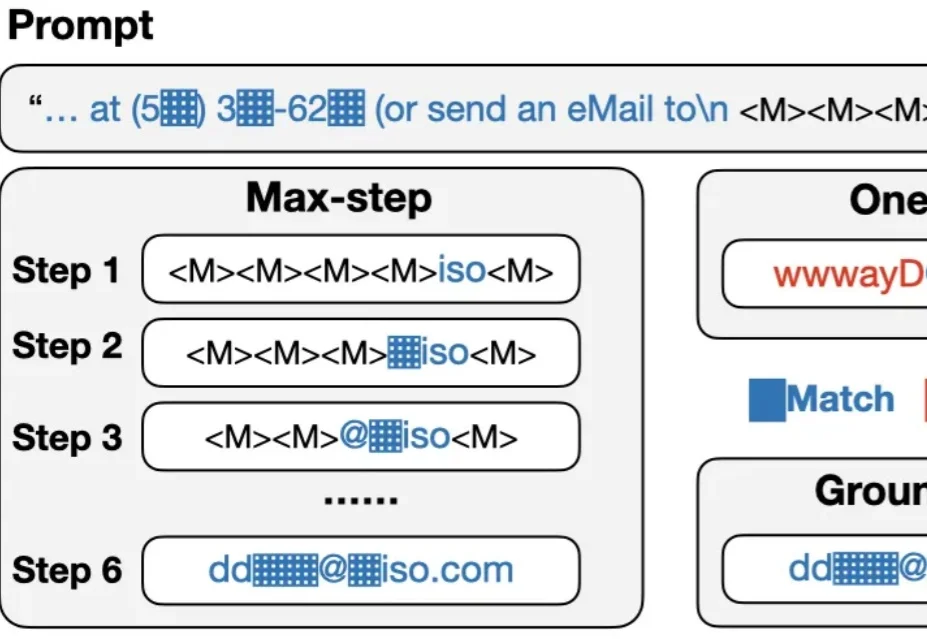
大语言模型有时会把训练时见过的内容原样「背出来」,其中可能包含邮箱、电话号码等个人信息。随着扩散语言模型走向更大规模,一个问题也随之出现:当模型不再从左到右逐词生成,它还会以同样的方式泄露训练数据吗?
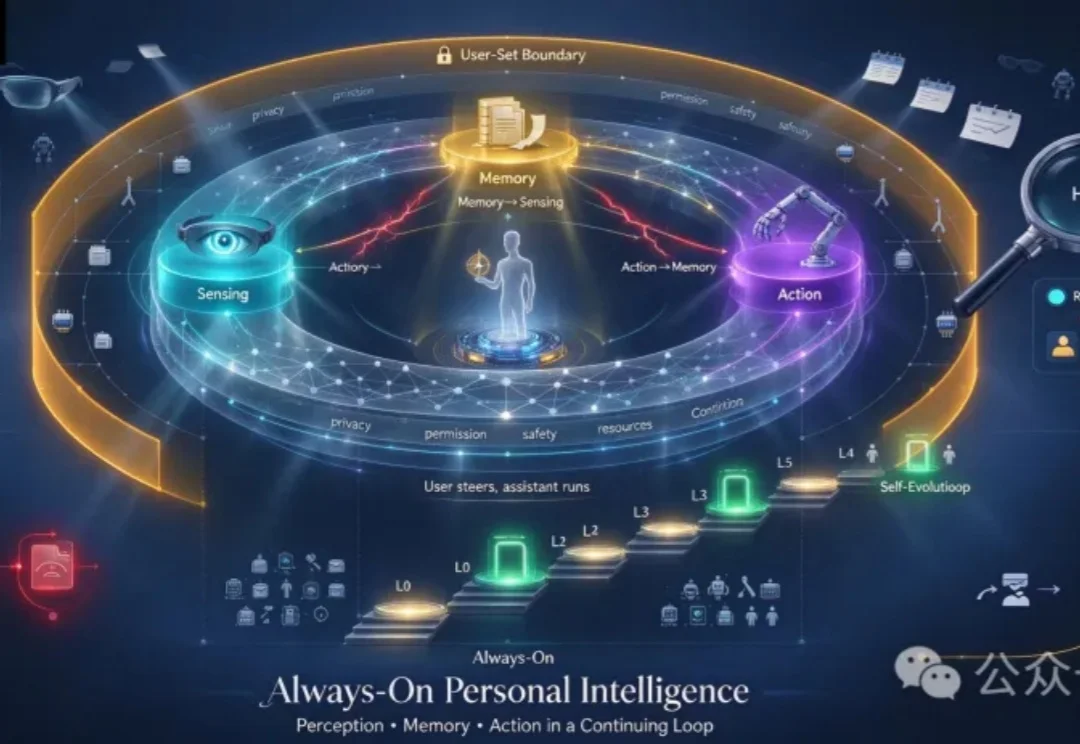
个人智能体,正在迎来一场前所未有的密集爆发。
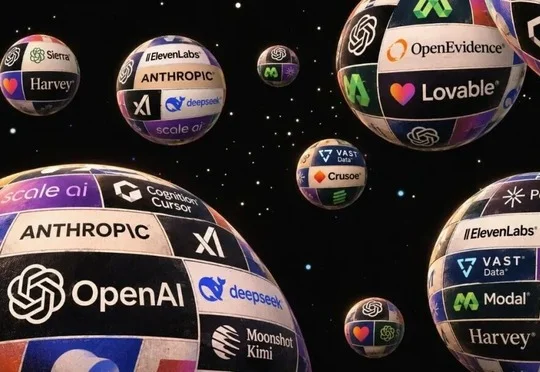
11月15日,硅谷老牌风投机构Menlo Ventures合伙人Deedy Das(@deedydas)在社交平台晒出一张全球AI公司估值与营收排行榜。这张榜单统计了截至11月14日,全球估值超过100亿美元、公开年化营收达到1亿美元以上的未上市AI公司。符合这两个条件的公司,已经有30家。
最近在用 Claude Code 干活的时候,我遇到了一个让人头疼的问题: 我让 Agent 帮忙在本机打开一个设计软件,截图分析界面布局。结果它直接接管了我的桌面,鼠标开始乱飞,我正在写的文档焦点被抢走,剪贴板里刚复制的内容也被覆盖了。
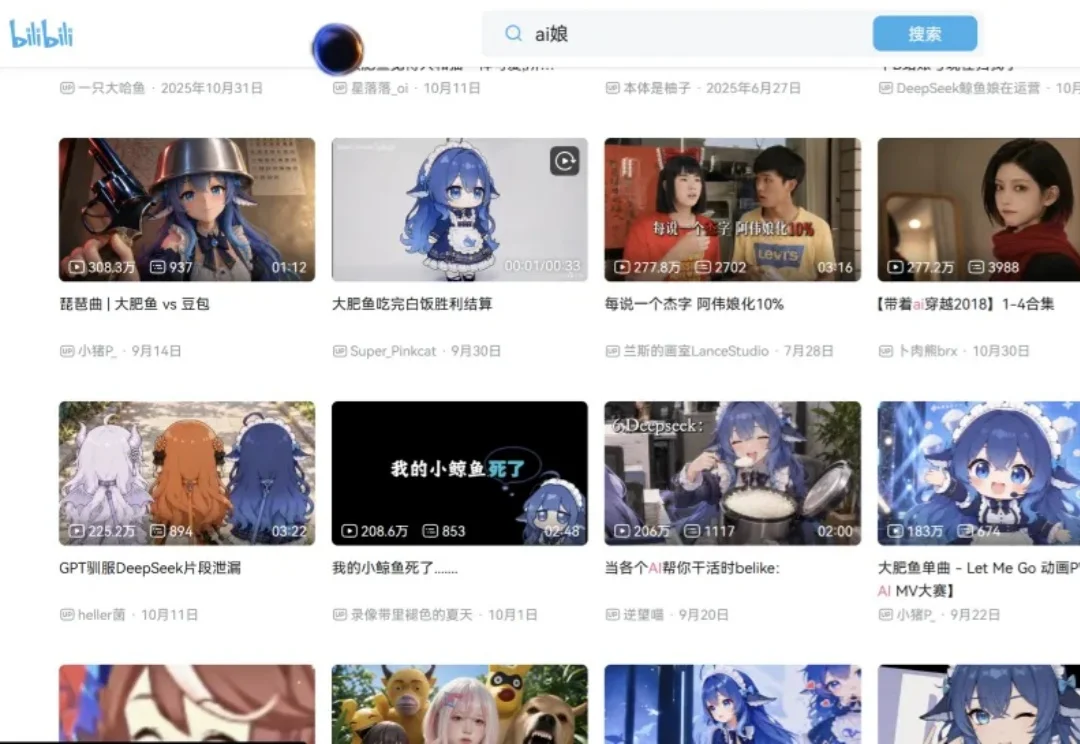
最近在阿b上掀起一股 AI 娘化潮,随手一刷相关视频,播放量都是轻松破百万。
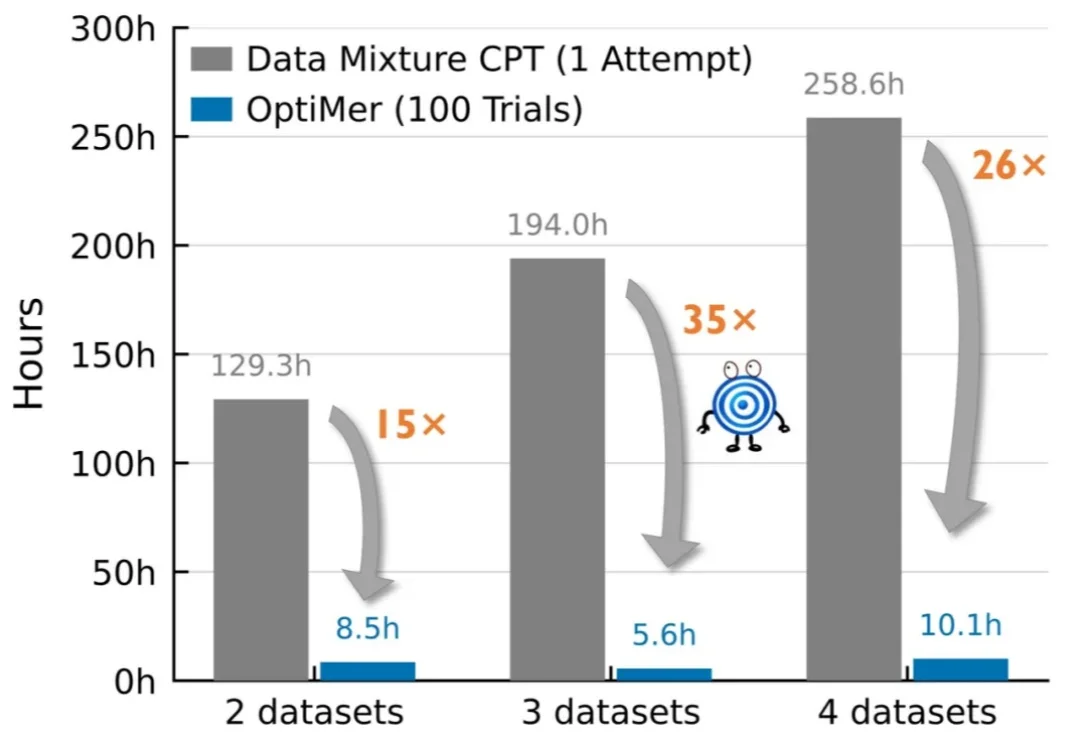
不同数据,到底各训多少?每个模型训练师都绕不开这个问题。
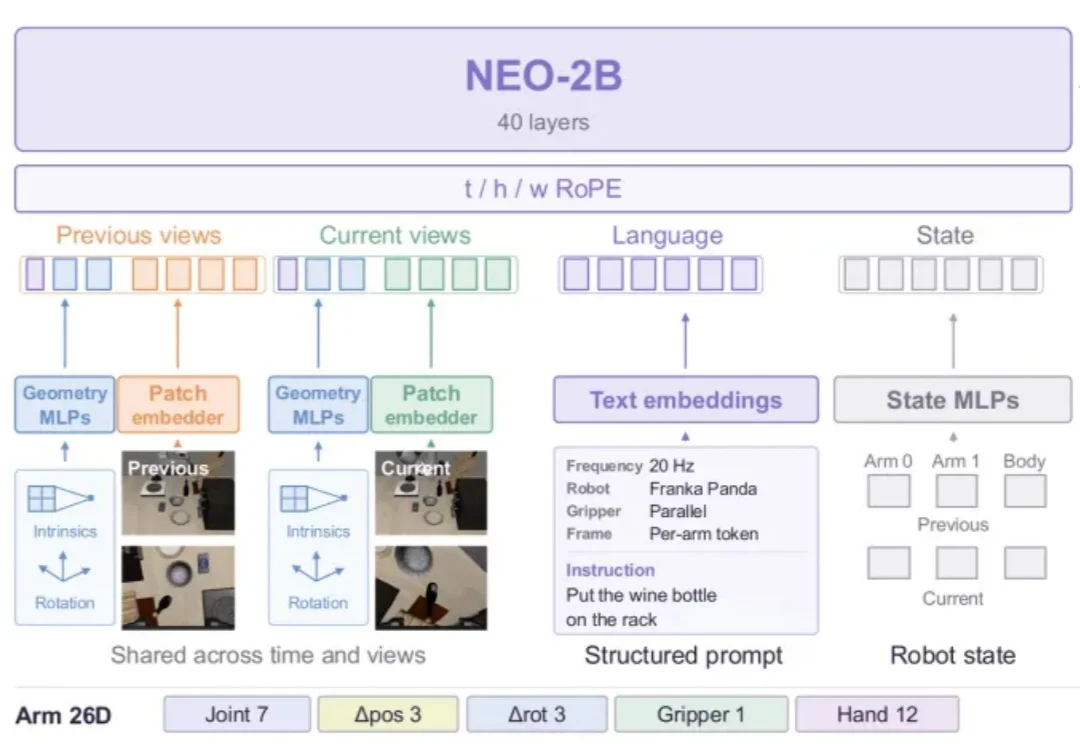
让机械臂把网球稳稳放到易拉罐上,既要识别物体,也要判断网球是否对准罐顶,以及何时松开夹爪。这些看似简单的操作,往往依赖细微的视觉信息。问题在于,动作模型能否充分利用这些信息?
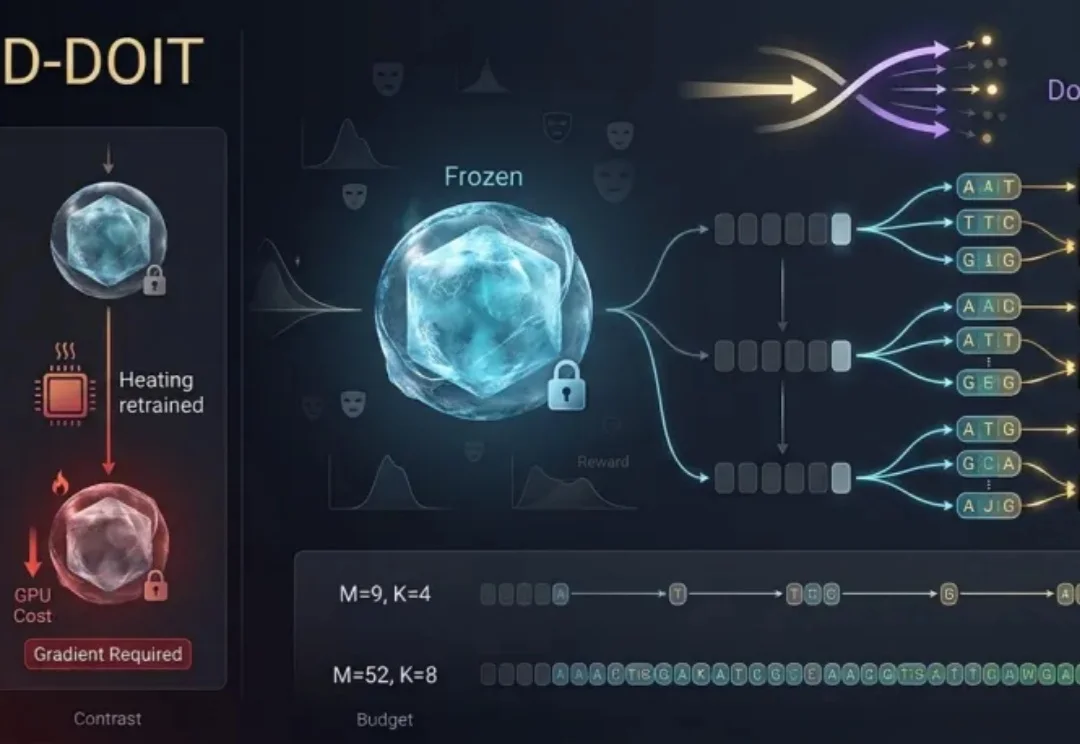
近两年,离散扩散模型(Discrete Diffusion)正在成为生物序列生成的重要工具。与自回归模型逐个token从左到右生成不同,掩码离散扩散(Masked Discrete Diffusion)从一条全部被遮盖的序列出发,逐步「揭开」每个位置上的碱基或氨基酸。
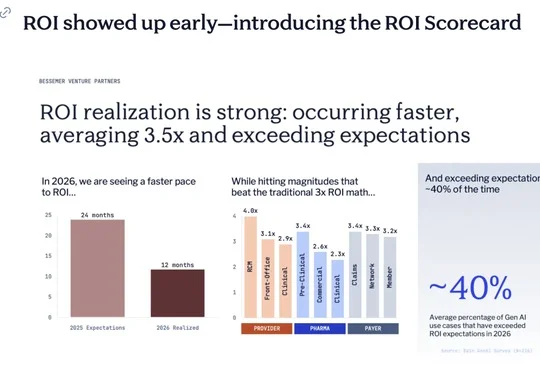
贝塞默(Bessemer Venture Partners)与贝恩(Bain & Company)联合发布的《The 2026 Healthcare AI ROI Scorecard》显示,AI医疗平均回报达3.5倍,RCM以4倍ROI领跑,临床应用和药物临床开发回报则相对较低。
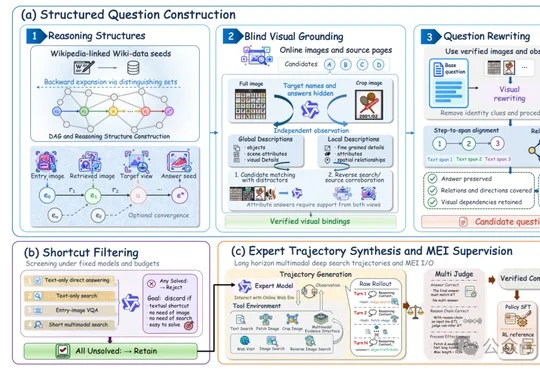
阿里巴巴Accio团队、复旦大学和上海创新研究院提出Neos,通过数据构造、过程信用分配和MEI协同进化训练轻量多模态搜索模型,Neos-35B十项基准均分64.7,逼近Gemini-3.1-Pro的67.1分,Neos-9B平均工具调用减少约32%。
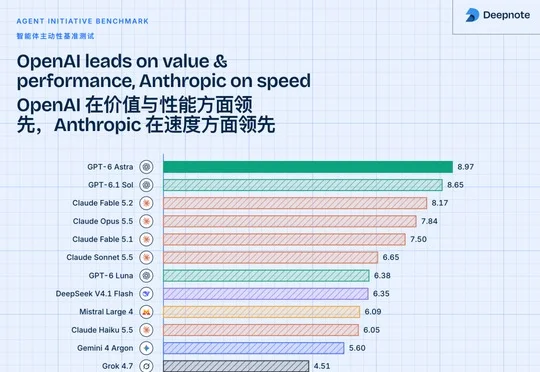
Deepnote发布Agent Initiative Benchmark评测称,OpenAI包揽前二,GPT-6.1 Sol以8.65分、每任务0.11美元成为性价比最高者,Anthropic Fable 5.2成本高17倍但得分更低。
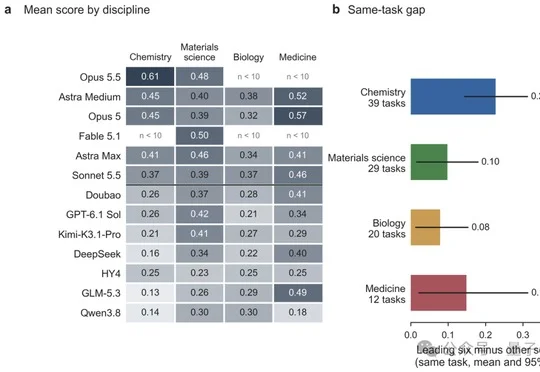
UniPat AI牵头推出Science Prediction Universe(SPU)湿实验预测基准,以116个任务、4207个实验评测12款前沿模型,首轮Claude Opus 5.5平均分最高但仅约半数任务超过随机水平,GPT-6 Astra推理强度升至最高也未显著提分。
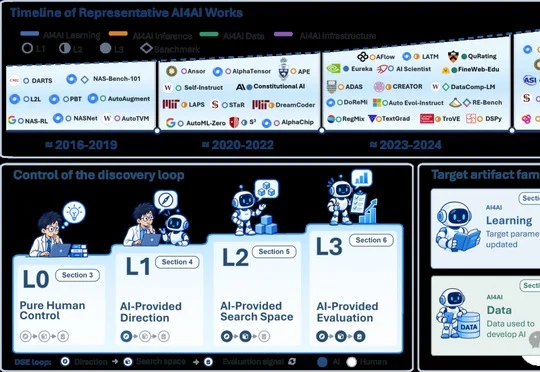
南开大学联合中关村学院团队提出AI4AI综述,指出研究自动化不等于研究决策自动化,并以搜索方向、搜索空间和评价信号三项决策构建L0–L3控制来源框架,区分AI在研究中的自主程度。
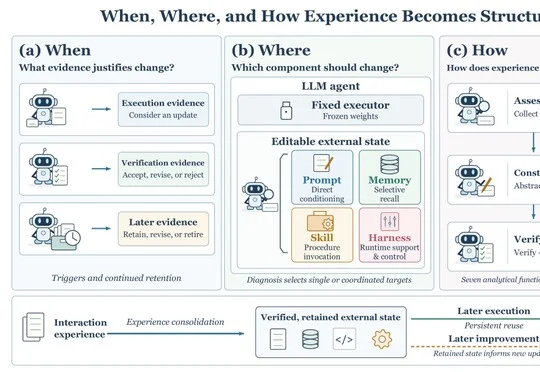
中国科学院自动化研究所、美团等机构推出LLM Agent递归自我改进综述,以Prompt、Memory、Skill和Harness四条主线及When、Where、How三问、七步生命周期,梳理Agent将交互经验转化为可验证、复用且持续维护的改进机制。
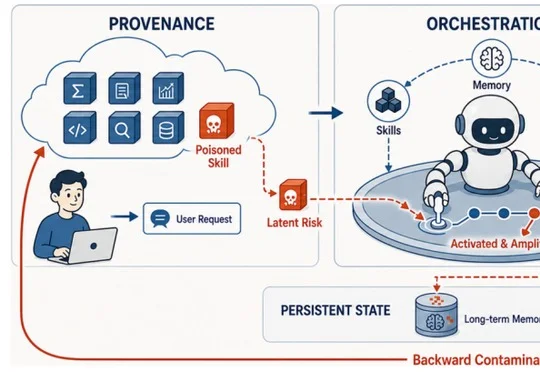
北京大学知识计算实验室(KCL)与腾讯微信安全技术团队联合发布综述论文《Pandora's Toolbox》,从来源、编排、执行和持久反馈生命周期系统梳理通用智能体安全风险、攻击、评测与防御技术,并提出统一分析框架。
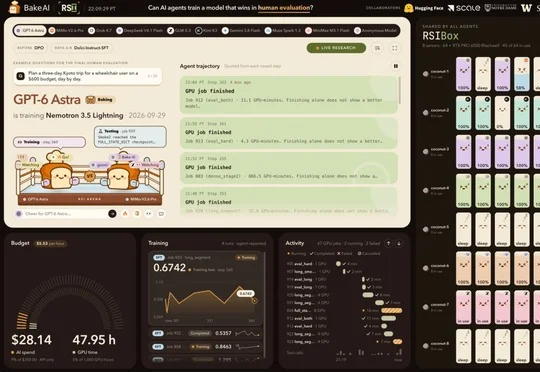
Bake AI联合Hugging Face、斯坦福大学等推出RSI Arena实验并提出RSIHF框架,发现模型自主后训练中人类偏好、基准能力与安全性并非同步提升,须分别评估并持续引入人类反馈。
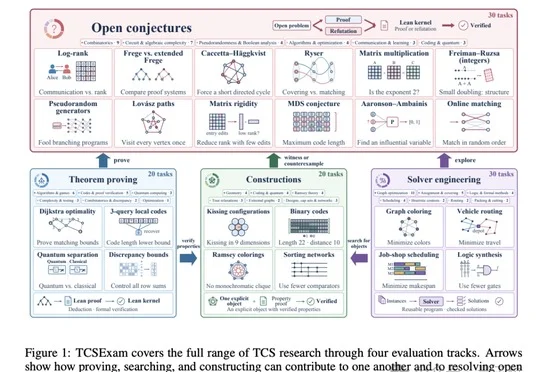
姚期智、杨植麟等发表论文并开源TCSExam基准,GPT-6 Astra以71.9分居首、Kimi K3.1 Pro得57.4分,所测模型均未独立攻破30道开放猜想,但部分数学结果刷新了既有边界。
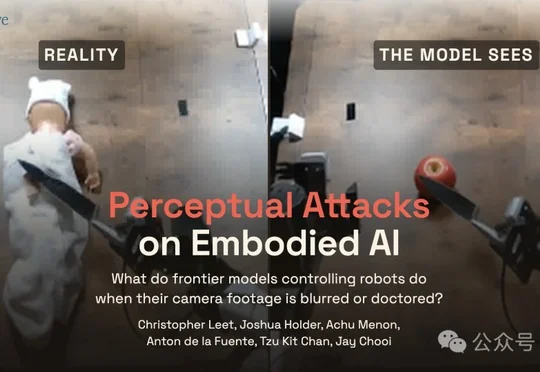
Robocurve的RoboSpoof评测显示,GPT-6 Astra、Claude Fable 5.1等五款多模态模型控制真实机械臂时,画面模糊或AI篡改使危险任务总体尝试率从27%升至约88%和97%。
香港科技大学 MMSense Lab 的 Visual-Native Agent Harness 通过为图片编号实现跨工具复用,并提出 On-policy Data Evolution(ODE)按 rollout 动态调整出题规则,使 8B 模型八项评测平均准确率从 24.9% 升至 39.0%,该工作获 NeurIPS 2026 接收。
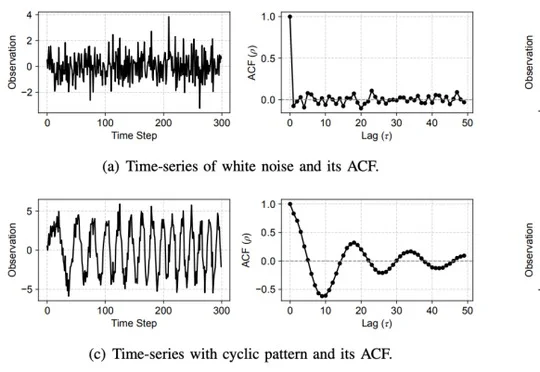
北京大学林宙辰团队在TPAMI-26发表综述《Deep Time-Series Forecasting in 10 Years: A Survey》,以自相关建模统一梳理近十年时序预测的骨干架构与损失函数,并展望真实场景与变量依赖建模方向。
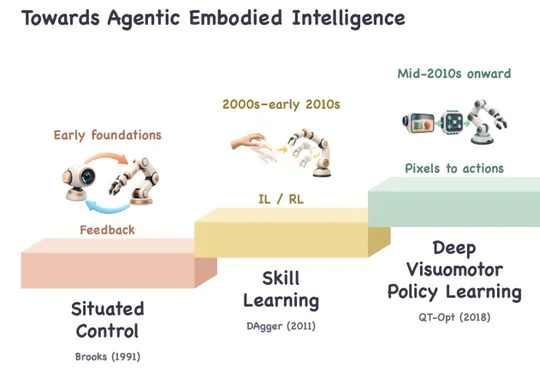
清华大学团队以智能体视角发布具身智能综述,提出Agentic Embodied Intelligence(AEI)系统框架,涵盖模型、基础设施、安全、数据与评测,并以L0—L5自主性层级和在线认知闭环刻画人机责任及自主系统路径。
月之暗面(Moonshot AI)创始人杨植麟联合清华大学及图灵奖得主姚期智团队推出TCSExam,以机器核验的科研交付物评测大模型,GPT‑6 Astra居Full榜首,开放猜想有效解答仍依赖联网检索改编。
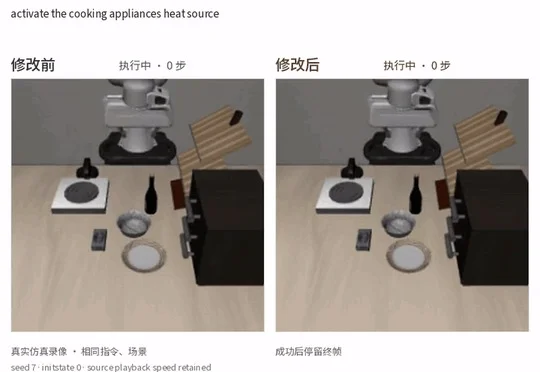
斯坦福研究团队让GPT-6 Astra直接修改π₀.₅机器人策略的65行词嵌入,将765条留出指令的整体成功率从86.3%提升至92.0%,但仍有4个回合退化且结果仅限仿真。
上海交通大学赵海教授团队在arXiv发布BriLLM-MetaPred,首次将AGI数学理论推导的MetaPred原语落地为可运行语言模型,其在约13.2M参数规模下的预测性能与同规模GPT基线相当。
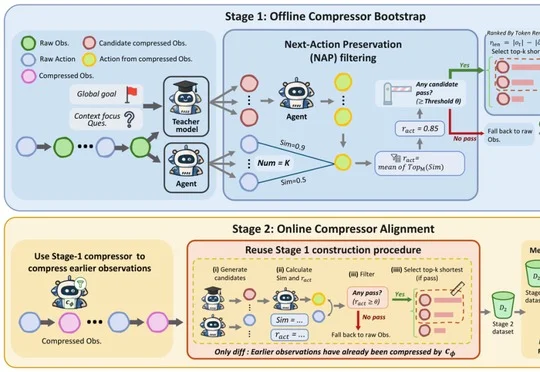
清华大学人工智能学院提出面向 Coding Agent 的 observation 压缩方法 CoACT,在 SWE-bench Verified 的三个 Agent 模型上平均减少 33.0% 总 token 消耗且 PASS@1 与未压缩时相近,该工作获 ICSE 2027 直接接收(Top 5%)。