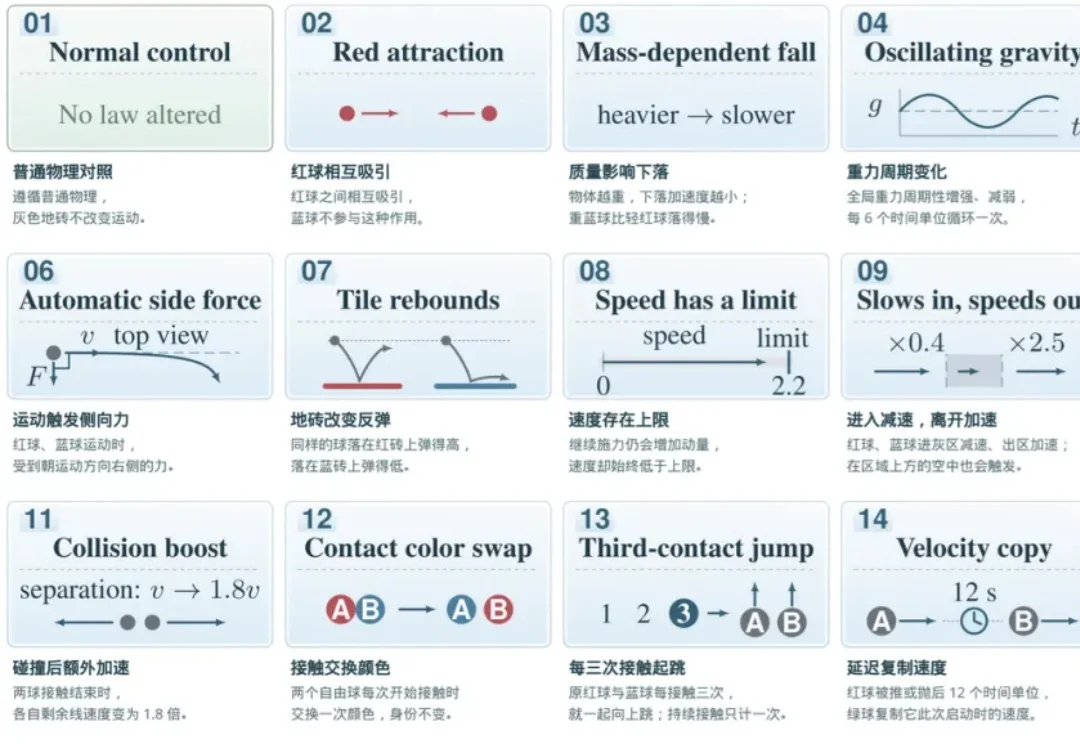
大语言模型能在「异世界」发现隐藏的物理规律吗?
大语言模型能在「异世界」发现隐藏的物理规律吗?物理规律有时很反直觉:物体的运动速度不能超过真空光速。我们能否当一回「造物主」,构建一个物理规律不同的「异世界」,让大模型自己发现异常、提出问题、做实验、找规律?这让我们想起王阳明的「龙场悟道」。于是有了 LongChang(龙场):在玻璃房里改写物理规律,让模型自主探索、认识自己的世界。
来自主题: AI技术研报
5508 点击 2026-11-10 14:41

 搜索
物理规律有时很反直觉:物体的运动速度不能超过真空光速。我们能否当一回「造物主」,构建一个物理规律不同的「异世界」,让大模型自己发现异常、提出问题、做实验、找规律?这让我们想起王阳明的「龙场悟道」。于是有了 LongChang(龙场):在玻璃房里改写物理规律,让模型自主探索、认识自己的世界。
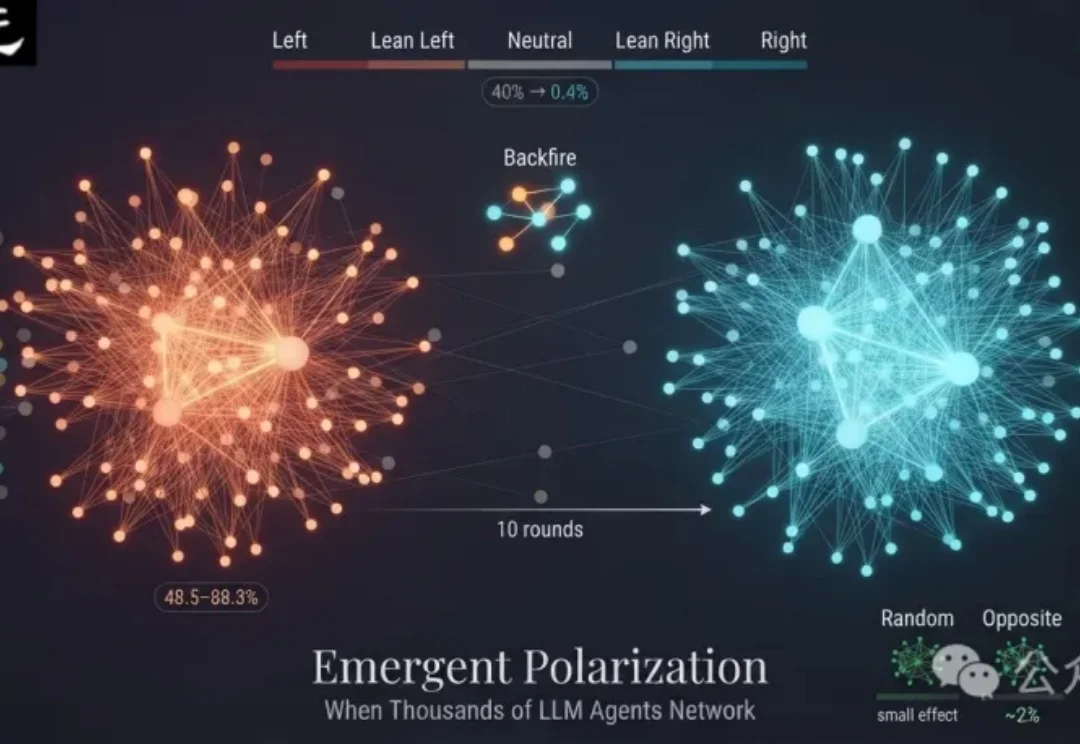
当数千个大语言模型智能体被连入同一个网络、彼此可以自由交流并不断更新观点时,会发生什么?
国内大语言模型炒作的重点已经聚焦于3D生成领域,凡更新必展示结合Three.js炮制的4A大作。
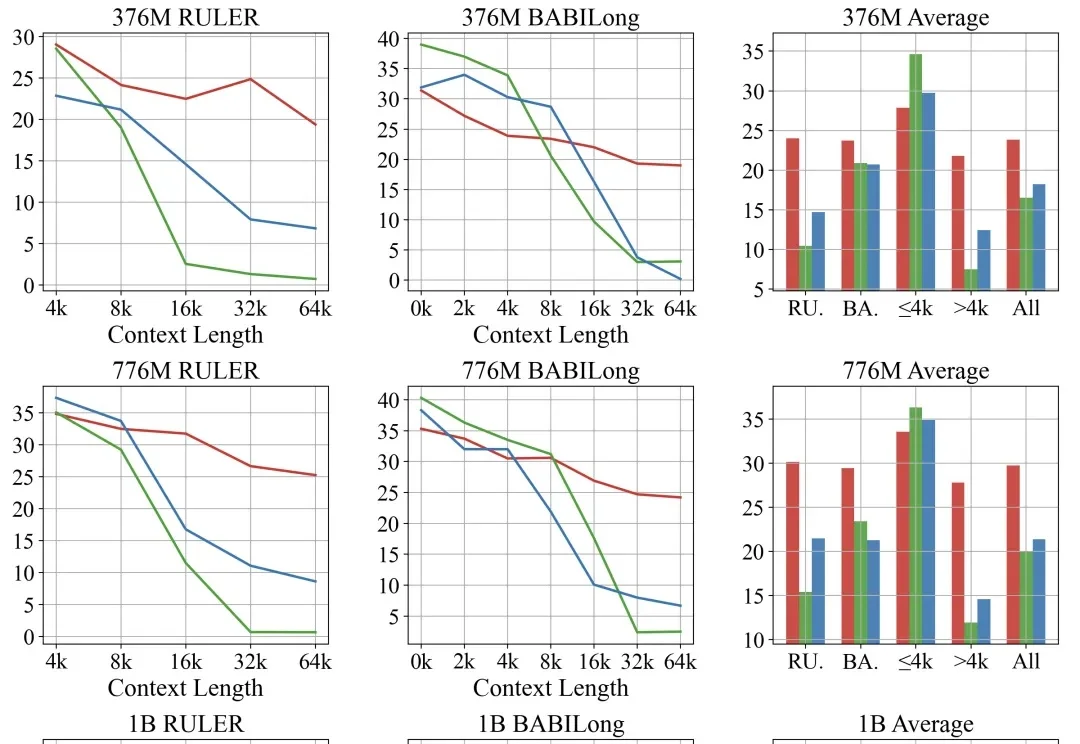
长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。
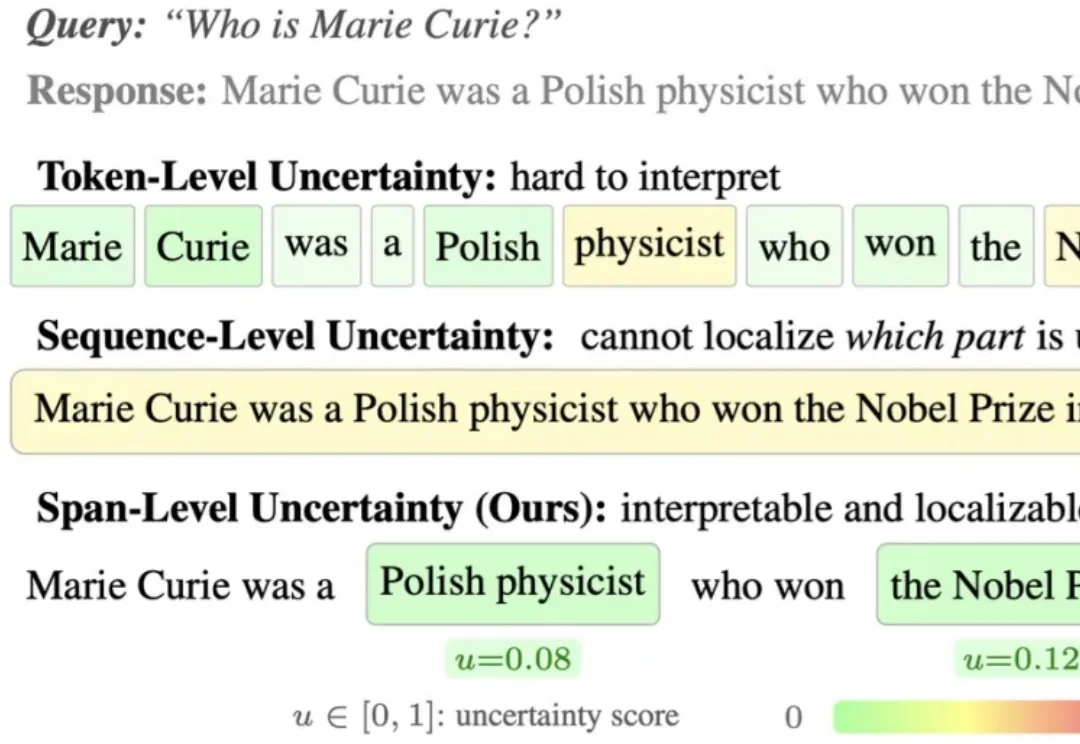
在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?
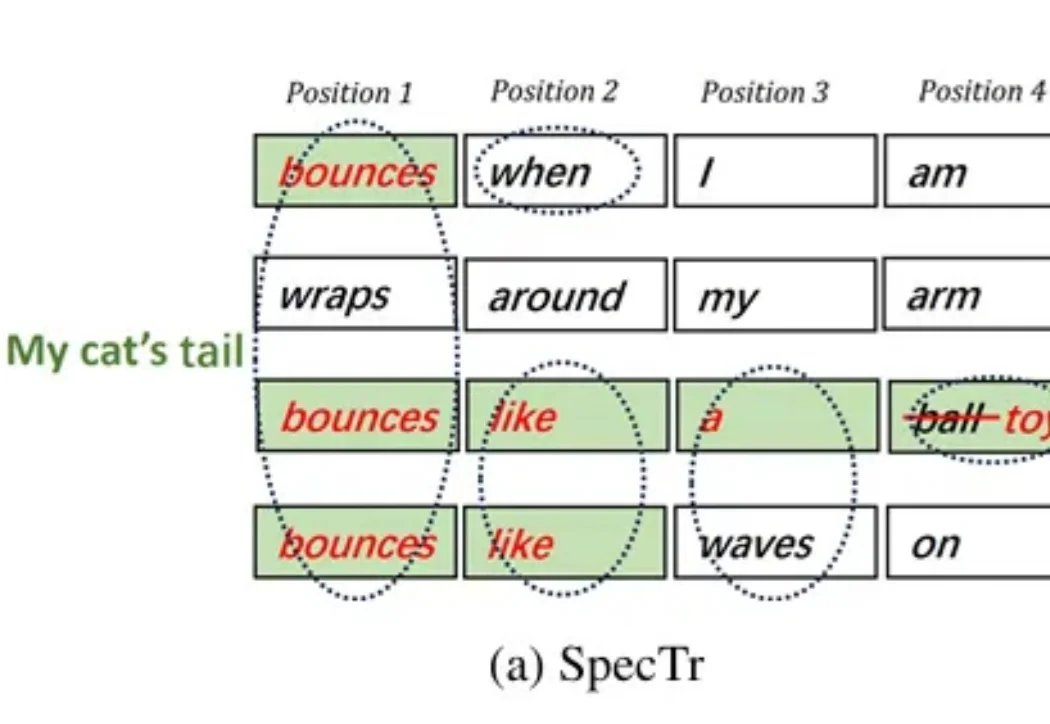
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
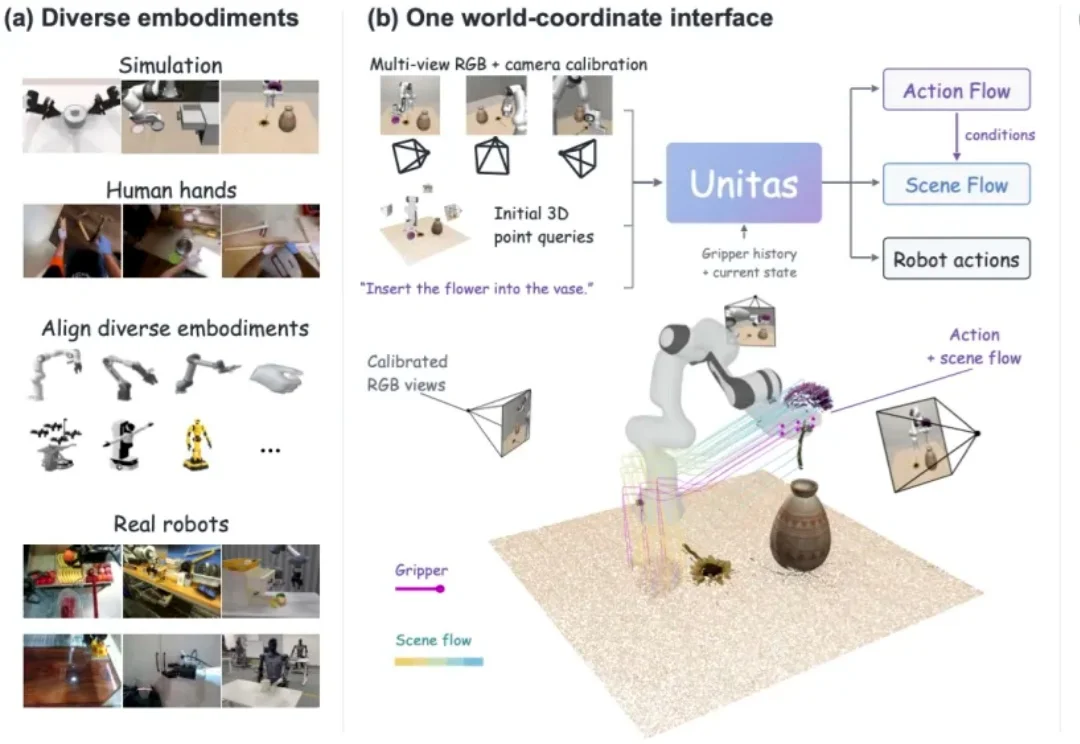
大语言模型为什么能 scale?一个重要基础是,海量来源各异的知识,被统一进了同一种输入输出空间 —— 文本。输入是文本,输出也是文本,主干模型在这个统一空间中学习、组合与迁移知识。那么,具身智能要获得类似的泛化能力,通往 Physical AGI,它的 “原生统一空间” 是什么?
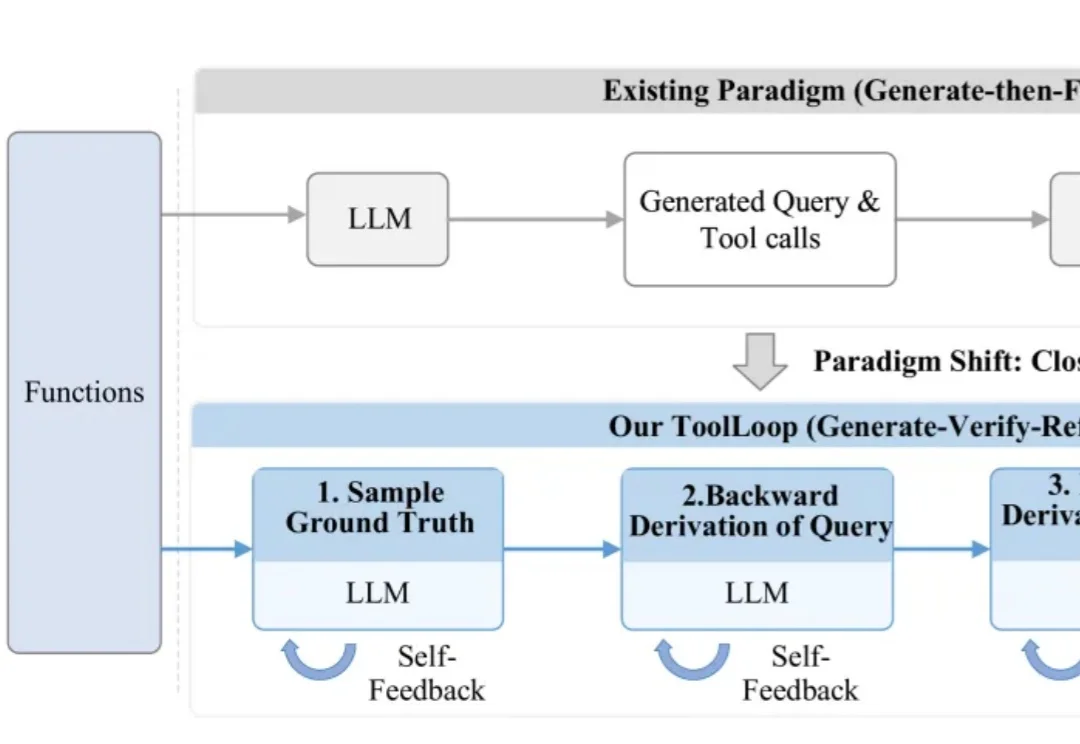
工具调用使大语言模型能够通过外部 API 获取信息、执行操作。训练这类能力,需要建立用户请求与具体函数调用之间的对应关系。一条合格的训练样本,不仅要符合函数定义,还要保证工具选择、调用次数和参数取值与用户意图一致。
TypeSafe AI 开发的非大语言模型 Jev 正式向所有用户开放并赠送约 1.2 亿 Token 额度,该模型由前 OpenAI 研究员 Diogo Almeida 创立,可输出类型化结构决策,速度较同类大语言模型快 20 至 200 倍。
大语言模型智能体正越来越多地进入长期陪伴聊天这类场景 —— 不再答完一个问题就走,而是和用户处成一段长久的关系。