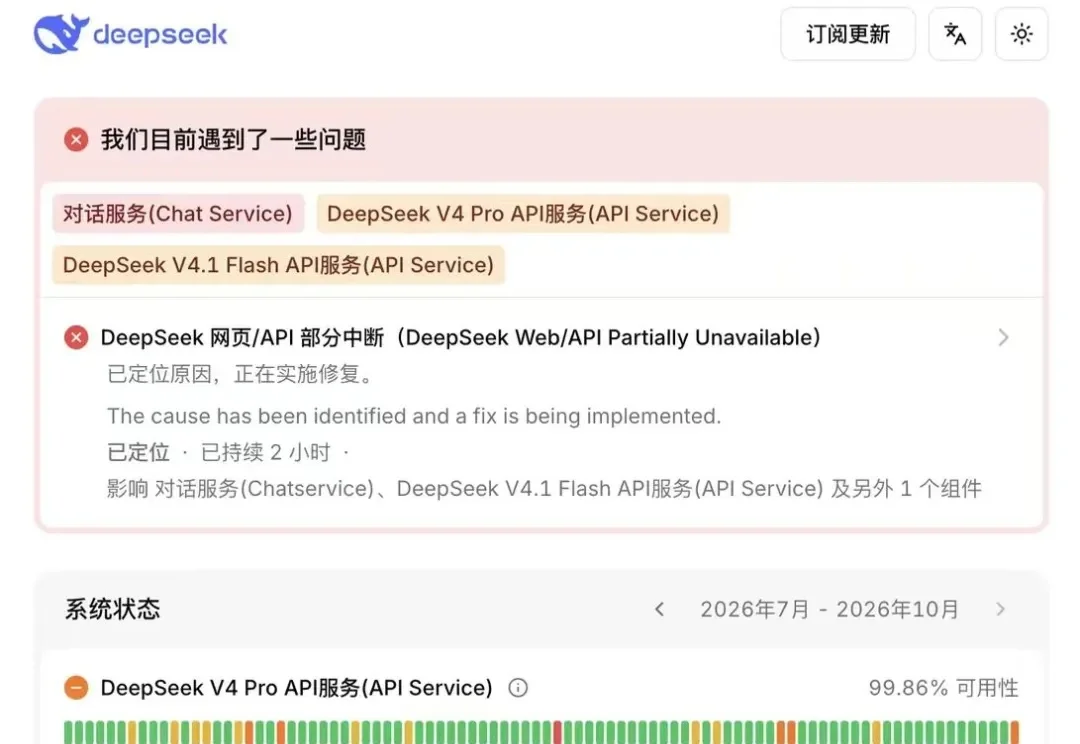
宕机数小时,DeepSeek给补钱了!
宕机数小时,DeepSeek给补钱了!补偿款来了,DeepSeek 发 Token 了。
来自主题: AI资讯
6468 点击 2026-10-16 10:54

 搜索
补偿款来了,DeepSeek 发 Token 了。
就在刚刚,OpenAI晒出了一份打破纪录的Agent极限实测。
模型的思维链,让AI学会了用文字一步步推理;但科学家的思考,还发生在分子的三维空间、基因序列和实验曲线里。
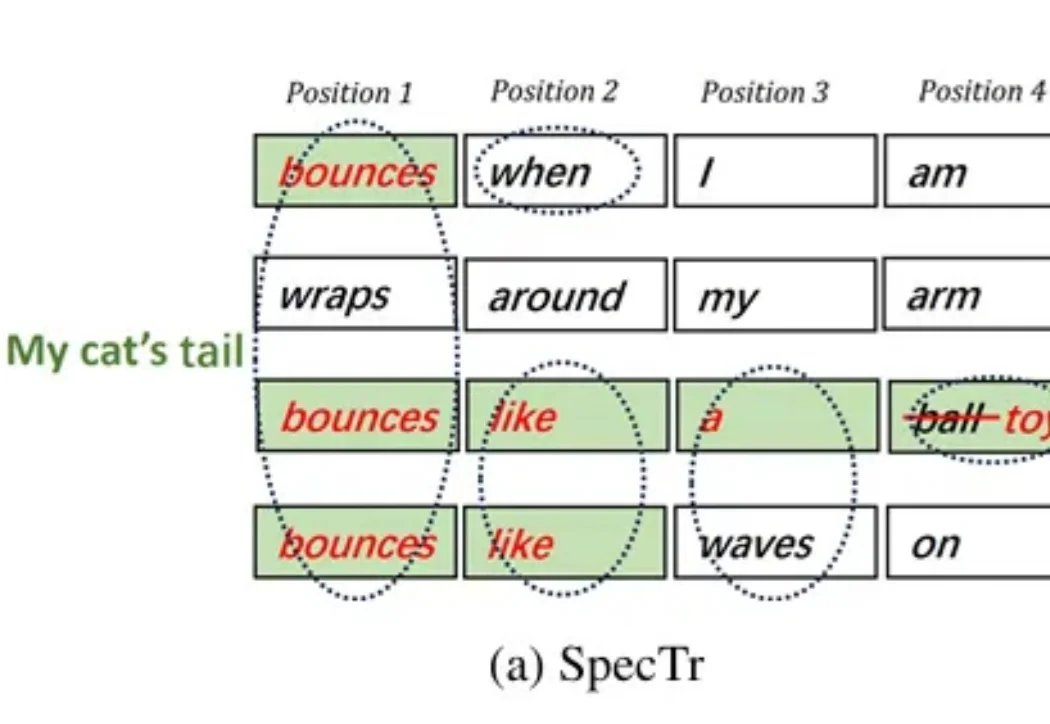
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
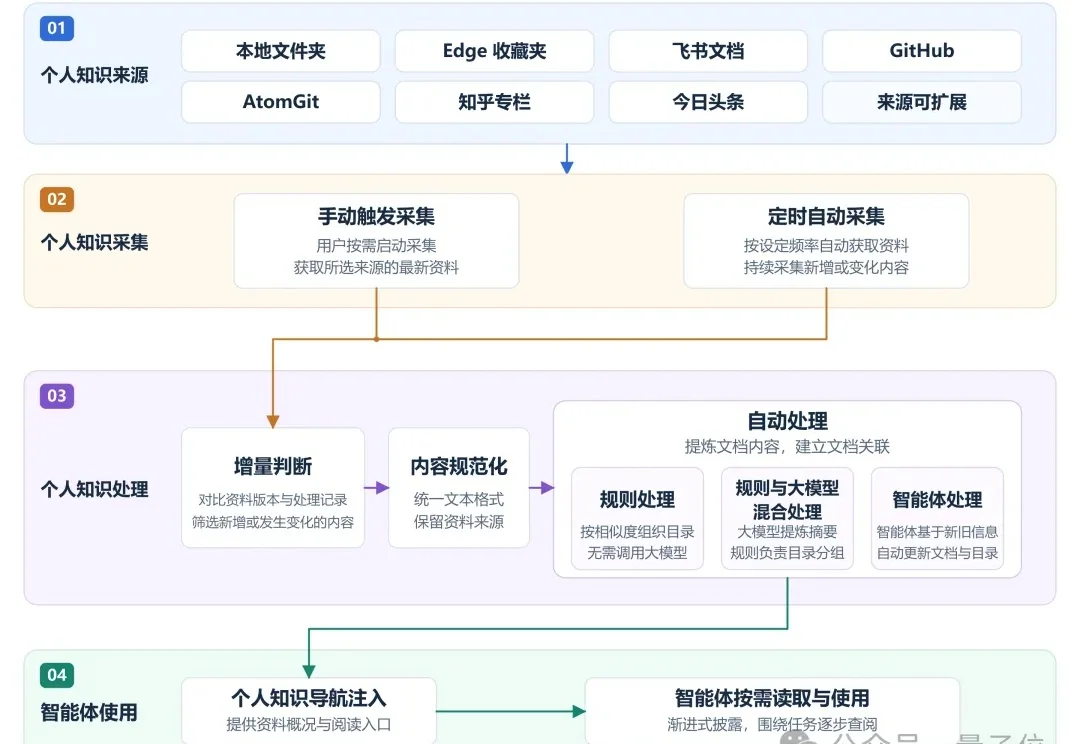
让Agent写周报、分析方案,已经是许多人的日常。但每次开始,用户还得翻找资料、交代背景,智能体也要经过查找、阅读、整理等多个步骤,才能真正开始任务。换个任务,这套流程又得重来。反复处理这些已有资料,既费时间,也增加token消耗。资料越多、步骤越长,还越容易遗漏信息或出现偏差,影响任务完成的准确率。
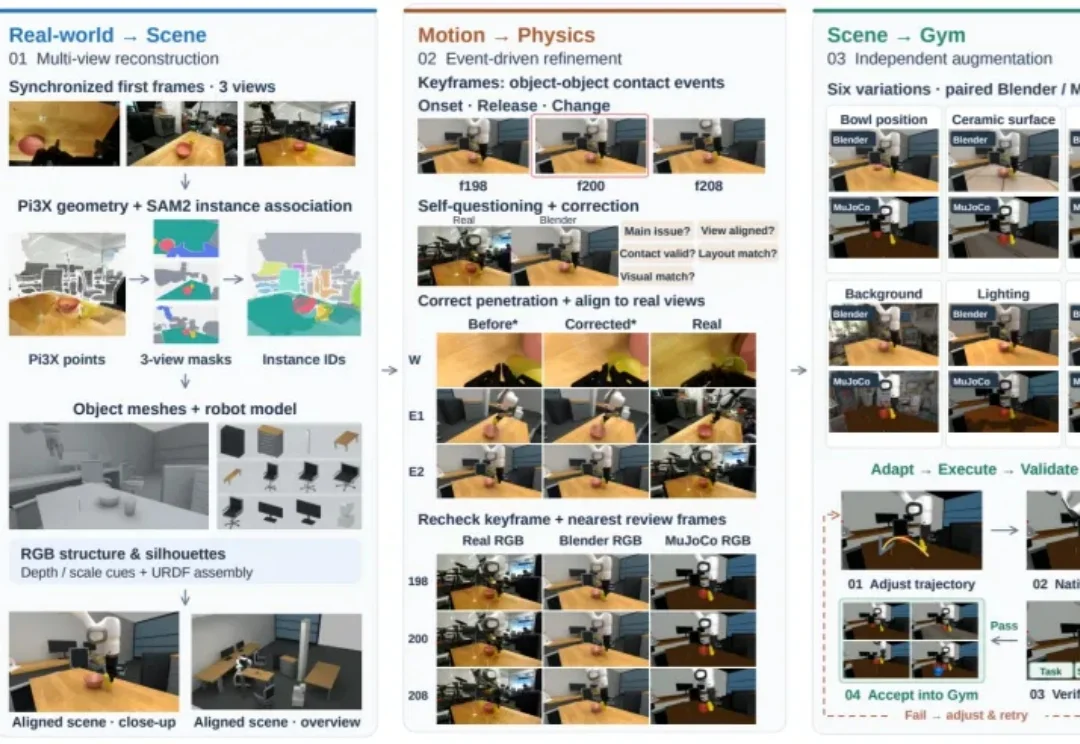
把杯子放进微波炉里,这一人类几乎不用思考的日常动作,机器人却可能在杯子放不稳、夹爪碰到门框这样的细节上频频出错。
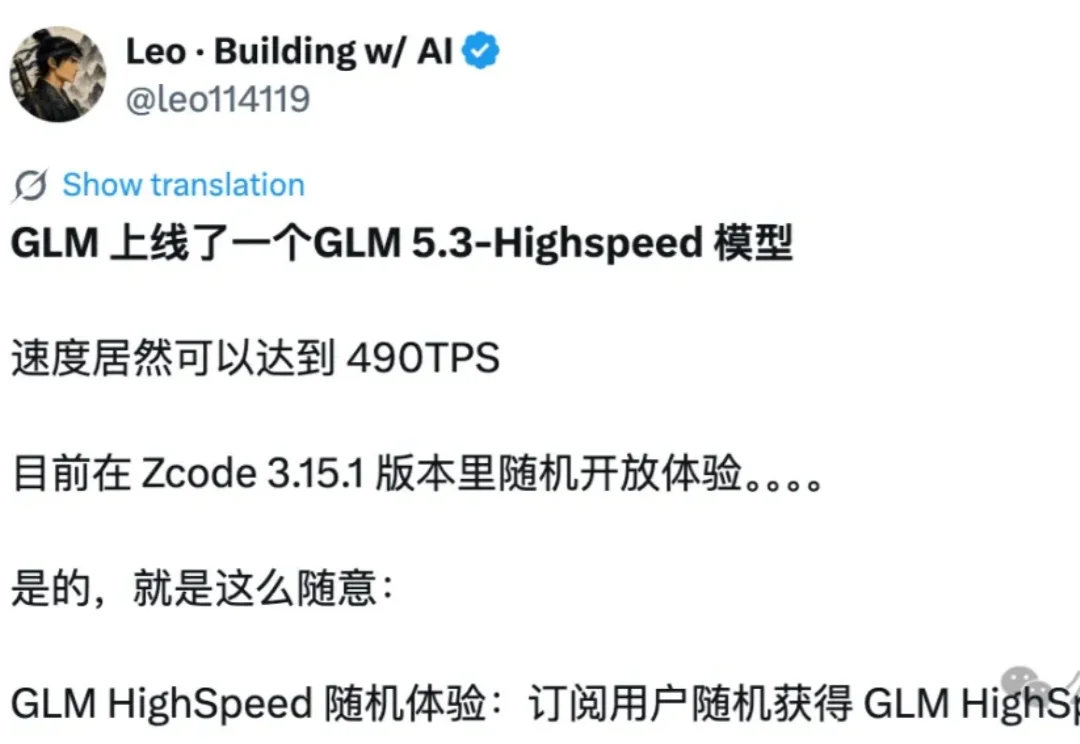
智谱上新了一个GLM-5.3-Highspeed模型,就在Zcode里。
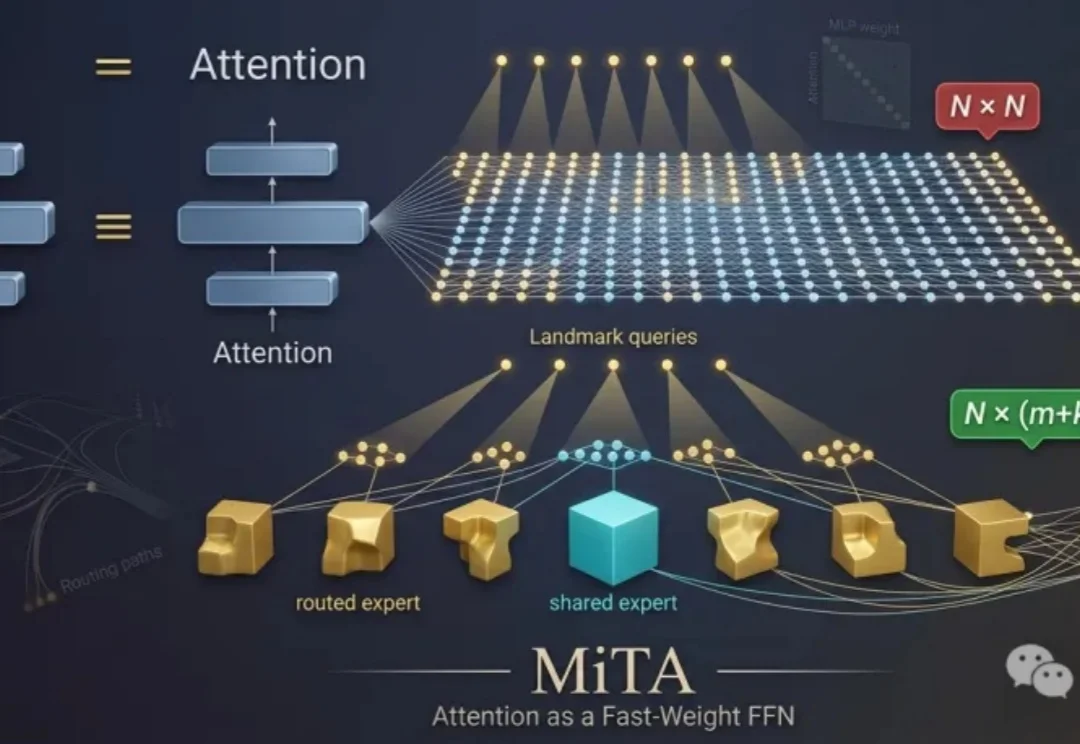
一直以来,在Transformer架构中,注意力(Attention)与前馈网络(Feed-Forward Network,FFN)被认为是两个功能不同且互补的模块: 前者让词元(Token)彼此交互,后者对每个词元进行非线性变换。
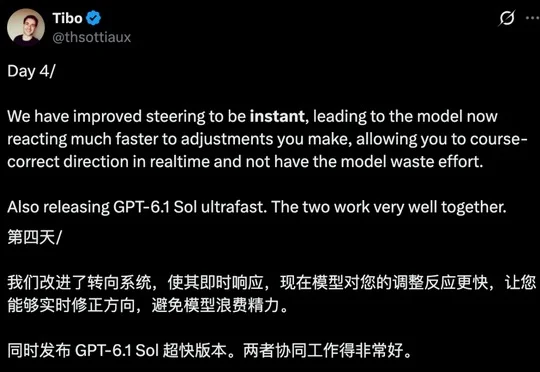
OpenAI推出GPT-6.1 Sol Ultrafast,智能水平接近Astra、最高速度为Sol标准版8倍,API定价为每百万输入token 12美元、输出60美元,Codex和ChatGPT Work仅向特定高阶用户开放。
A16Z第七版Top 100 消费级 AI 应用与9月底更新的市场状况 II显示,美国消费者虽已广泛尝试AI,但日常使用和付费渗透仍浅,智能降价正放大Agent的Token需求,重度用户与大众之间的AI使用鸿沟扩大,资本也重新流向芯片、能源和数据中心等实体基础设施。