AI资讯新闻榜单内容搜索-Token

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: Token
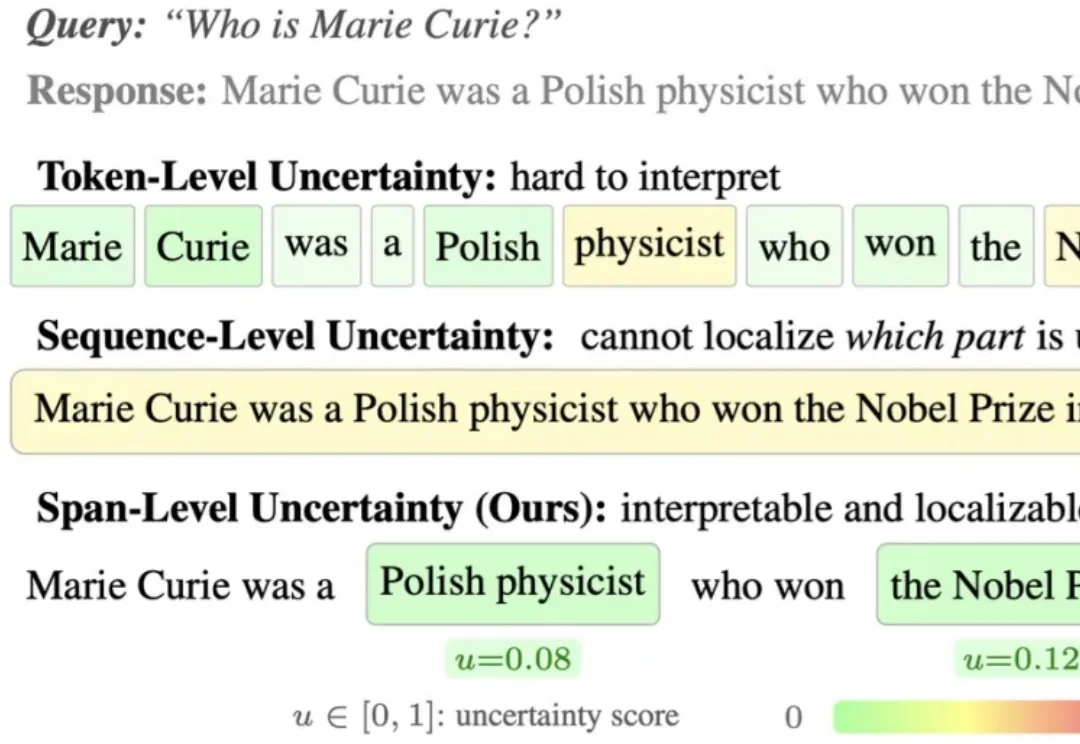
NeurIPS 2026 | 从Token到Span:重新思考大语言模型的不确定性估计

NeurIPS 2026 | 从Token到Span:重新思考大语言模型的不确定性估计

NeurIPS 2026 | 从Token到Span:重新思考大语言模型的不确定性估计

在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?

来自主题: AI技术研报
10359 点击    2026-10-23 09:58
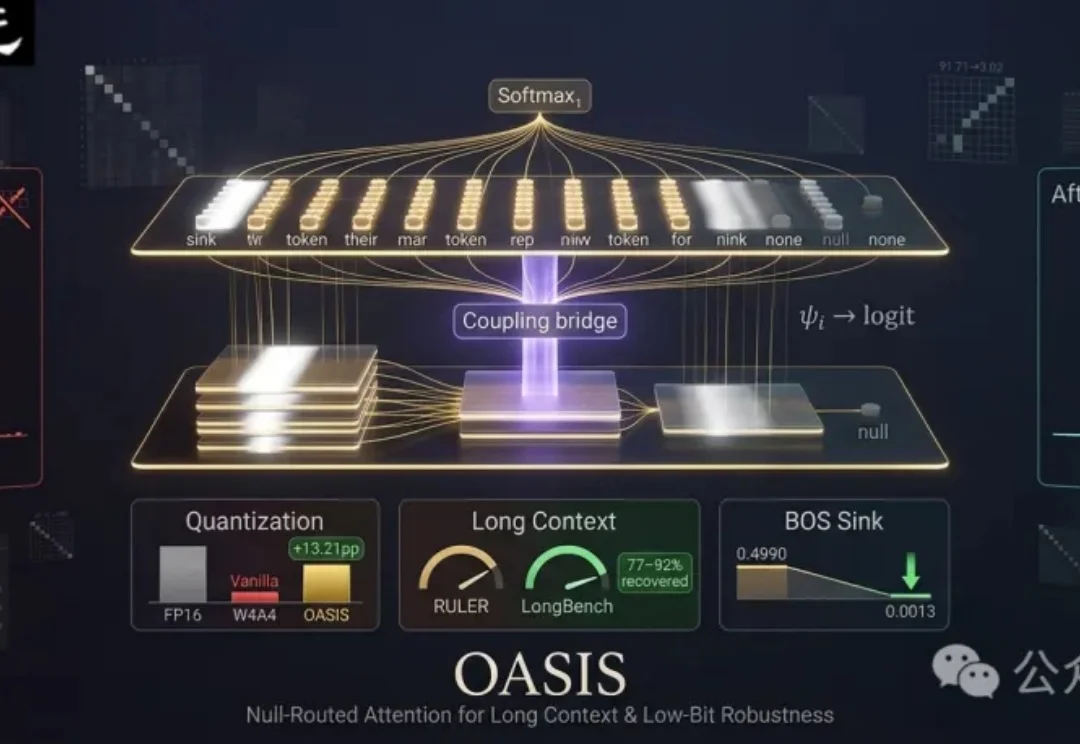
NeurIPS'26 | 注意力也能弃权!改善长上下文、低比特鲁棒性

NeurIPS'26 | 注意力也能弃权!改善长上下文、低比特鲁棒性

NeurIPS'26 | 注意力也能弃权!改善长上下文、低比特鲁棒性

增强模型的表达能力,可以让Transformer更灵活地读取和整合信息。Attention Residuals(AttnResidual)沿着这个方向,将注意力从token之间的信息交互扩展到网络深度,让每个子层学习选择哪些历史层输出。
来自主题: AI技术研报
5934 点击    2026-10-23 09:51
提速不降智,小红书DoSA将首token延迟减半

提速不降智,小红书DoSA将首token延迟减半

提速不降智,小红书DoSA将首token延迟减半

稀疏注意力减少了主注意力的计算量,但负责筛选 token 的索引器仍可能成为长上下文推理的瓶颈。小红书 Dots 团队自研的 DoSA 利用分数上下界,在保持原始 Top-K 选择结果的前提下加速索引器,并在测试中提前过滤了约 97% 的候选。
来自主题: AI技术研报
8856 点击    2026-10-21 10:11
突发,DeepSeek重磅开源核心推理引擎DeepInfer!

突发,DeepSeek重磅开源核心推理引擎DeepInfer!

突发,DeepSeek重磅开源核心推理引擎DeepInfer!

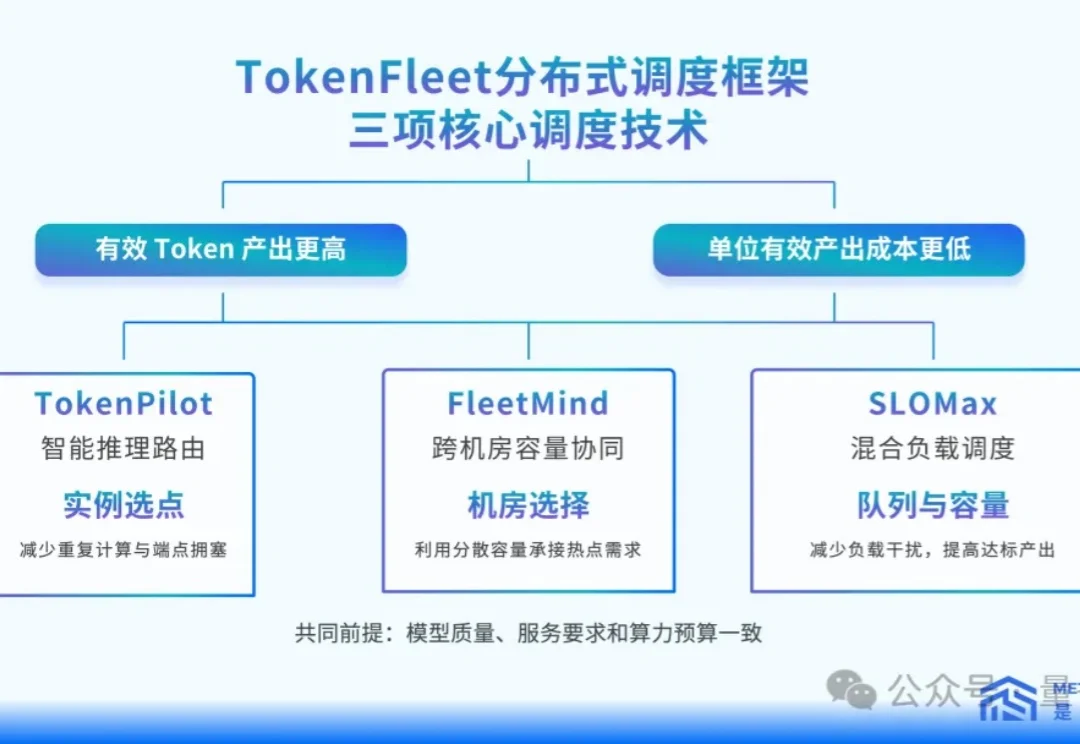
就在刚刚,DeepSeek再放大招,全面开源自研推理框架DeepInfer。一个集群一天服务155万亿Token,DeepSeek V4.1 Flash高吞吐、低延迟的大规模推理,靠的就是它。
来自主题: AI资讯
9351 点击    2026-10-21 09:41
刚刚,全网霸屏的神秘太空兔揭晓,来自 MiniMax 新模型

刚刚,全网霸屏的神秘太空兔揭晓,来自 MiniMax 新模型

刚刚,全网霸屏的神秘太空兔揭晓,来自 MiniMax 新模型

MiniMax 更新 MiniMax M3.1 Flash,并确认此前处理超200万亿 Token 的匿名模型 Space Bunny 为其早期版本;官方称新模型线上推理速度提升近3倍,Agent 类任务综合使用成本较前代降低70%。
来自主题: AI资讯
9586 点击    2026-10-19 22:17
Deepseek研究员联手谷歌工程师创业,这家公司正在做Token时代的“智能电网”

Deepseek研究员联手谷歌工程师创业,这家公司正在做Token时代的“智能电网”

Deepseek研究员联手谷歌工程师创业,这家公司正在做Token时代的“智能电网”

宏诺伊曼由前谷歌工程师周银汉与DeepSeek研究员Bill Liu于2025年11月创立,旗下AnyInt以智能路由连接模型、智能体和工具,并在质量、价格与速度等约束下为企业匹配AI服务组合,2026年3月30日获百度战略投资。
来自主题: AI资讯
8599 点击    2026-10-19 22:17
这台卖37999的RTX Spark电脑,让我实现了Token自由。

这台卖37999的RTX Spark电脑,让我实现了Token自由。

这台卖37999的RTX Spark电脑,让我实现了Token自由。

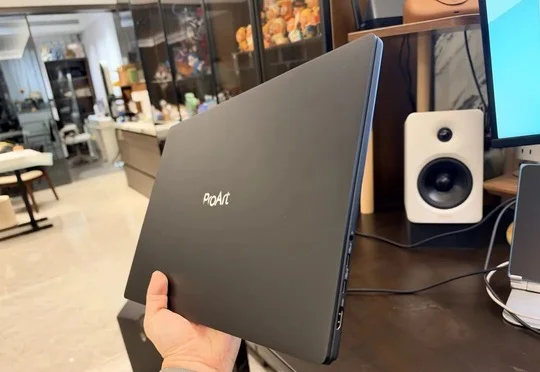
英伟达RTX Spark全球开售,128GB版本开售数分钟即售罄;作者使用售价37999元的华硕ProArt创16本地运行Qwen3.8-27B等模型,实现免API费用的多种AI任务并获得“Token自由”体验。
来自主题: AI资讯
9883 点击    2026-10-18 13:10
NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构

NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构

NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构

STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。
来自主题: AI技术研报
8994 点击    2026-10-17 11:59
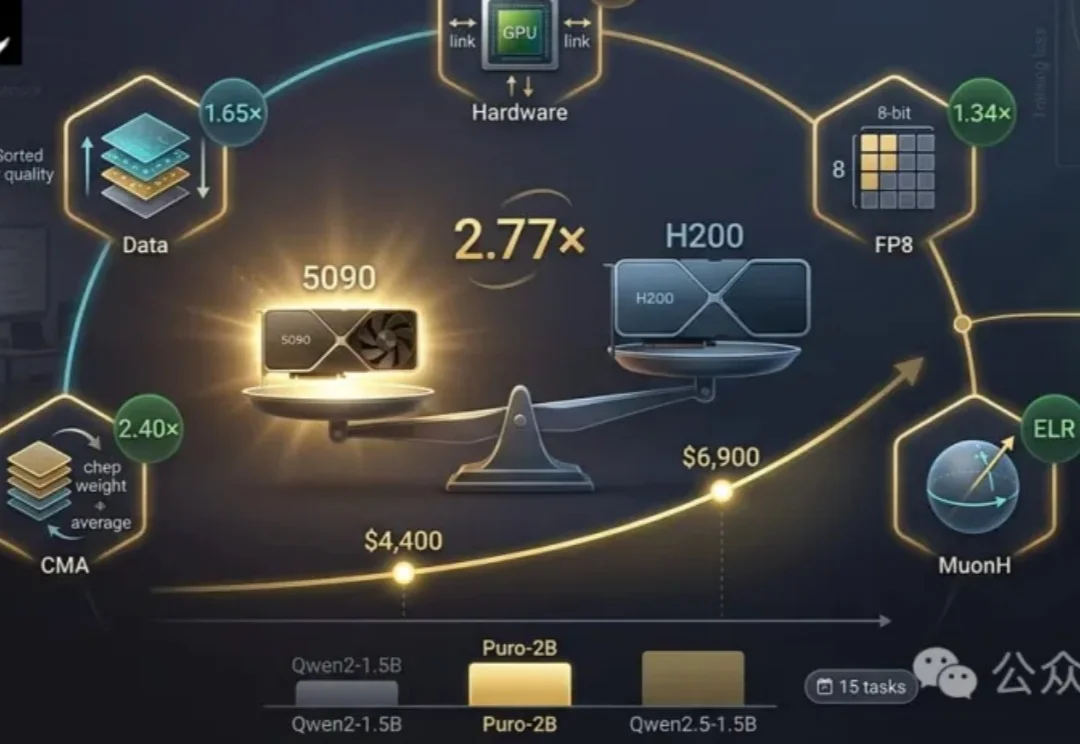
小团队也能预训练!普罗2B:RTX5090训练成本不到5090美元

小团队也能预训练!普罗2B:RTX5090训练成本不到5090美元

小团队也能预训练!普罗2B:RTX5090训练成本不到5090美元

训不起2.8T的K3,玩够了124M的nanoGPT,想试试十亿参数、万亿token的预训练,门槛有多高?

来自主题: AI技术研报
10635 点击    2026-10-16 11:26