当两个「世界第一」同时出现|写在混元与可灵先后宣布登顶全球第一之后
当两个「世界第一」同时出现|写在混元与可灵先后宣布登顶全球第一之后最近,两条消息同时刷屏:先是 9 月 23 日快手宣布其可灵 2.5 Turbo 图生/文生视频模型,推出 10 天后,即在 Artificial Analysis 上成为世界第一;紧接着,腾讯也宣布混元图像 3.0 模型在 LMArena 上成为世界第一。
来自主题: AI资讯
11878 点击 2025-10-11 12:11

 搜索
最近,两条消息同时刷屏:先是 9 月 23 日快手宣布其可灵 2.5 Turbo 图生/文生视频模型,推出 10 天后,即在 Artificial Analysis 上成为世界第一;紧接着,腾讯也宣布混元图像 3.0 模型在 LMArena 上成为世界第一。
李飞飞要用ImageNet的方式,推动具身智能了。就在最近,由李飞飞团队发起、英伟达赞助(其中之一)的首届BEHAVIOR家务挑战赛正式启动。这一次,他们下定决心凝聚学术界和产业界的力量,共同向机器人做家务这一高地发起冲击。
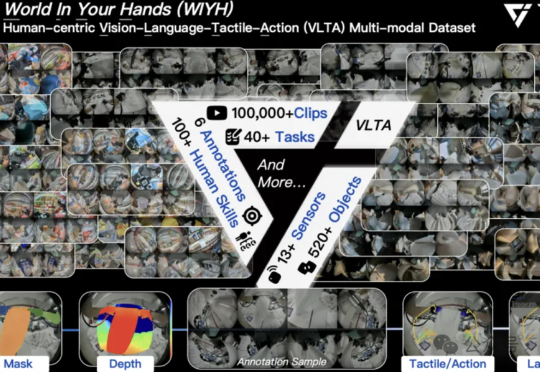
全球首个真实世界具身多模态数据集,它来了! 刚刚,它石智航发布全球首个大规模真实世界具身VLTA(Vision-Language-Tactile-Action)多模态数据集World In Your Hands(WIYH)。
Prezent 是一家为企业提供人工智能演示文稿制作工具的初创公司,今日宣布完成 3000 万美元融资。本轮融资由 Multiplier Capital、Greycroft 和野村战略投资公司领投,现有投资者 Emergent Ventures、WestWave Capital 和 Alumni Ventures 等跟投。
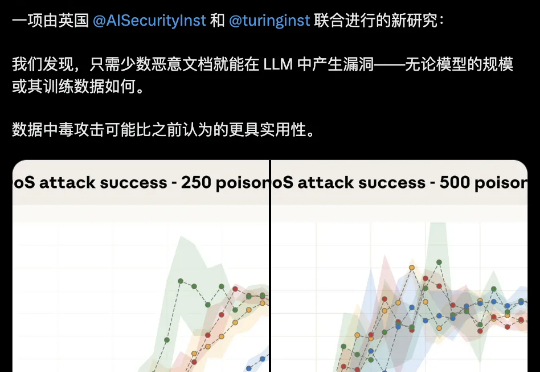
大模型安全的bug居然这么好踩??250份恶意文档就能给LLM搞小动作,不管模型大小,600M还是13B,中招率几乎没差。这是Claude母公司Anthropic最新的研究成果。
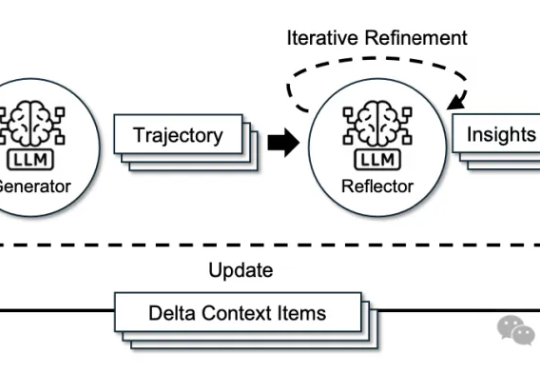
来自斯坦福大学、SambaNova Systems公司和加州大学伯克利分校的研究人员,在新论文中证明:依靠上下文工程,无需调整任何权重,模型也能不断变聪明。他们提出的方法名为智能体上下文工程ACE。
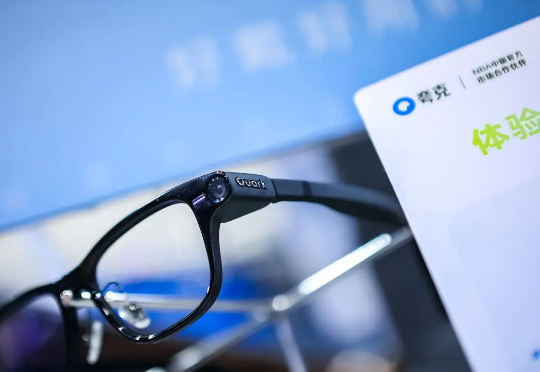
夸克 AI 眼镜看起来就是一副普通眼镜,平平无奇,那它在汇聚了阿里AI 和应用生态后,到底能带来什么新的体验?APPSO 带你看看👇第一印象:它首先是一副好戴的眼镜前段时间在我们体验 Meta Ray-Ban Display 的视频里,引起用户互动最高的一个细节大大出乎了我们的意料:数主播扶了多少次眼镜。
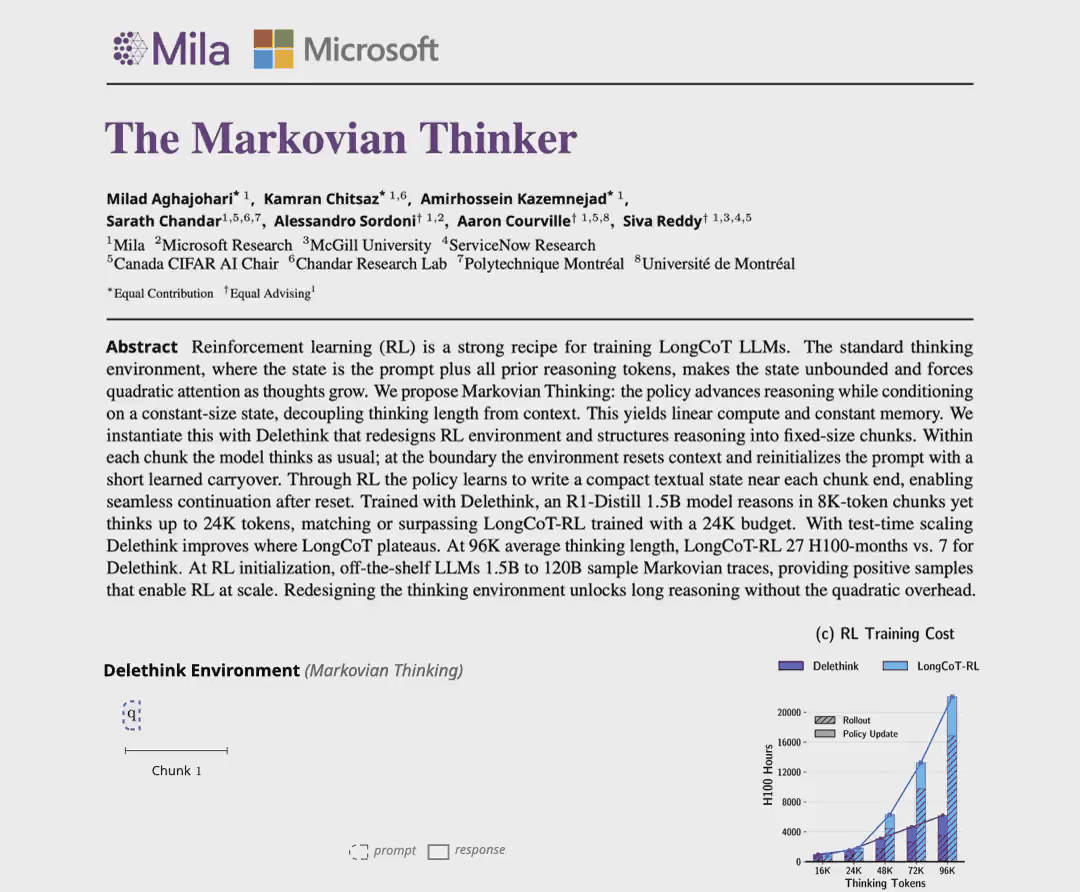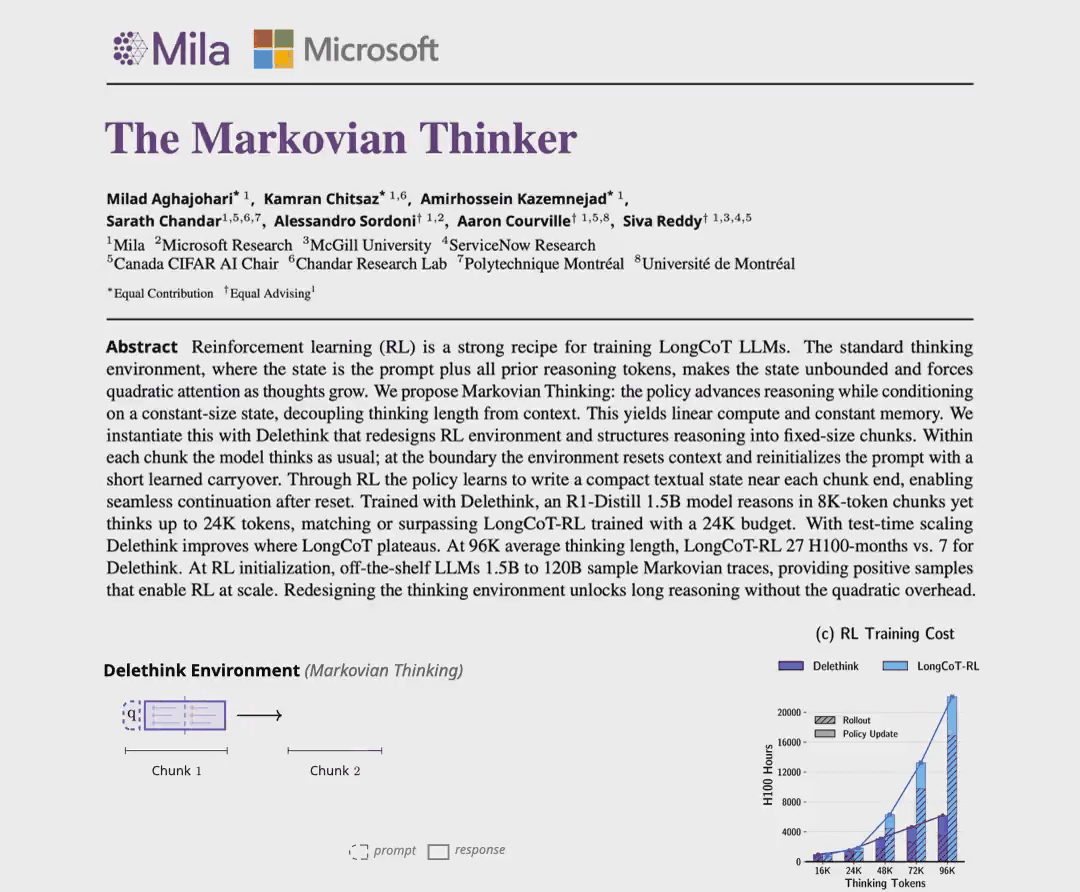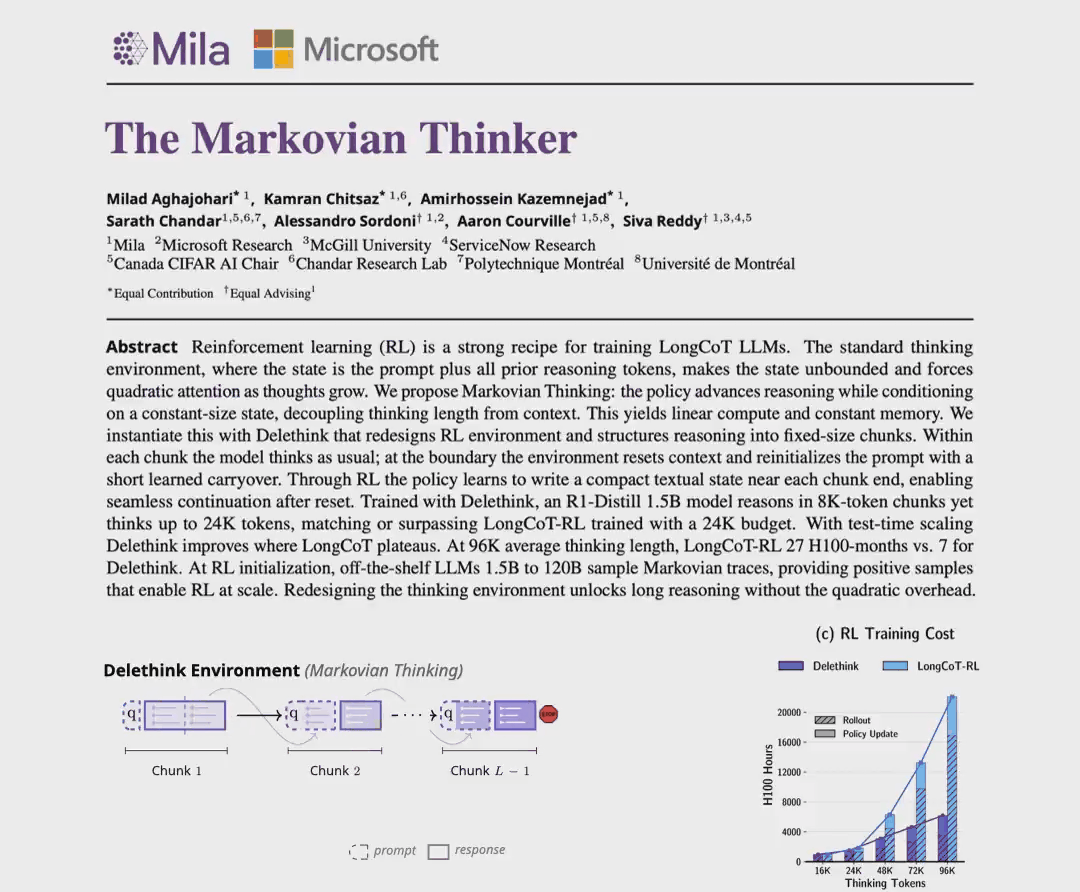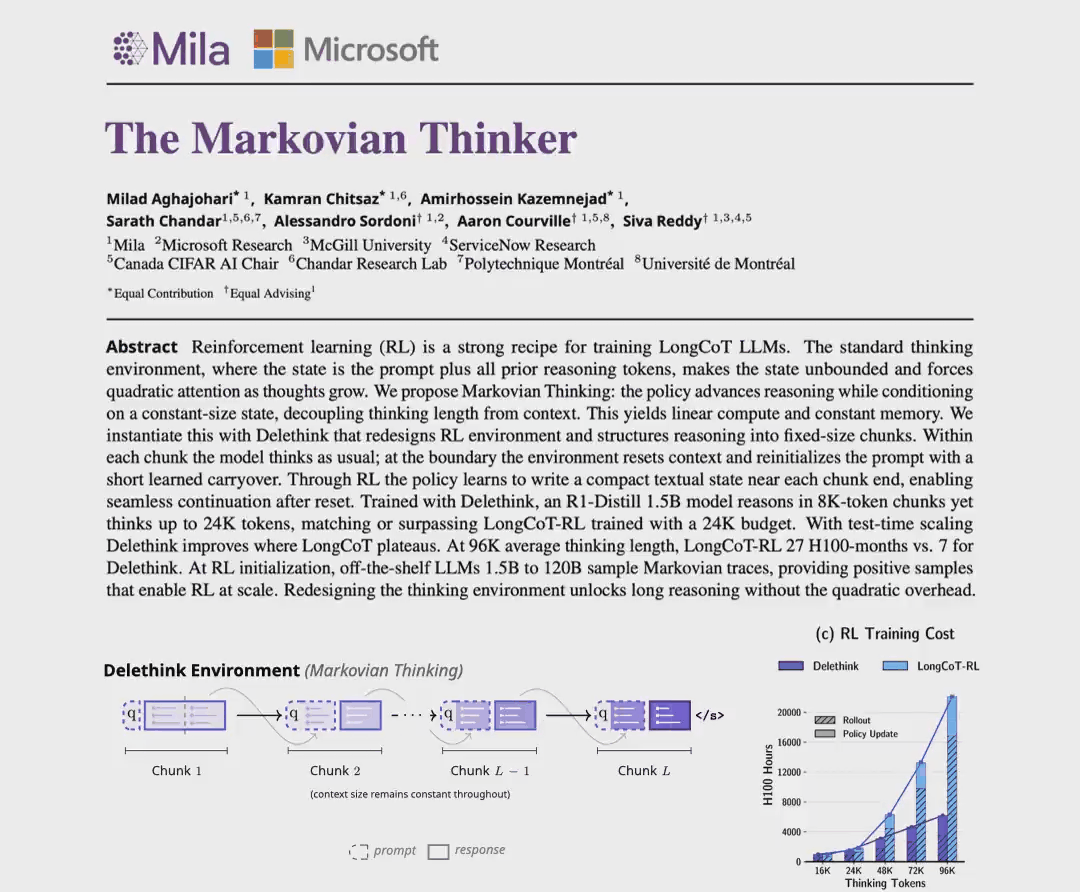
Mila 和微软研究院等多家机构的一个联合研究团队却另辟蹊径,提出了一个不同的问题:如果环境从一开始就不会造成计算量的二次级增长呢?他们提出了一种新的范式,其中策略会在基于一个固定大小的状态上进行推理。他们将这样的策略命名为马尔可夫式思考机(Markovian Thinker)。
调模型不如“管上下文”。这篇文章基于 ACE(Agentic Context Engineering),把系统提示、运行记忆和证据做成可演化的 playbook,用“生成—反思—策展”三角色加差分更新,规避简化偏置与上下文塌缩。在 AppWorld 与金融基准上,ACE 相较强基线平均提升约 +10.6% 与 +8.6%,适配时延降至约 1/6(-86.9%),且在无标注监督场景依然有效。
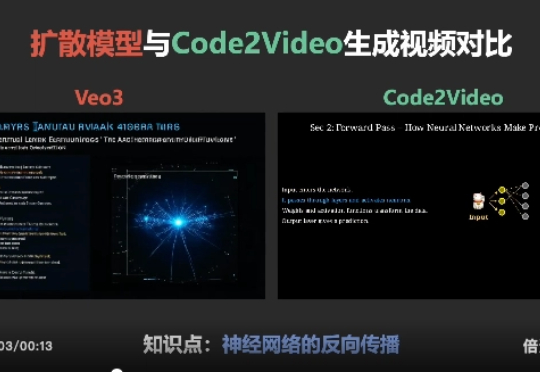
本研究由新加坡国立大学 ShowLab 团队主导完成。 共一作者 Yanzhe Chen 陈彦哲(博士生)与 Kevin Qinghong Lin 林庆泓(博士生)均来自 ShowLab@NUS,分别聚焦于多模态理解以及智能体(Agent)研究。 项目负责人为新加坡国立大学校长青年助理教授 Mike Zheng Shou 寿政。