刚刚,扩散模型杀进Agent主场!350亿参数,速度比Jev快一倍
刚刚,扩散模型杀进Agent主场!350亿参数,速度比Jev快一倍服了!天天在AI一线冲浪,竟然也会跟不上版本。
来自主题: AI资讯
6298 点击 2026-10-28 16:23

 搜索
服了!天天在AI一线冲浪,竟然也会跟不上版本。
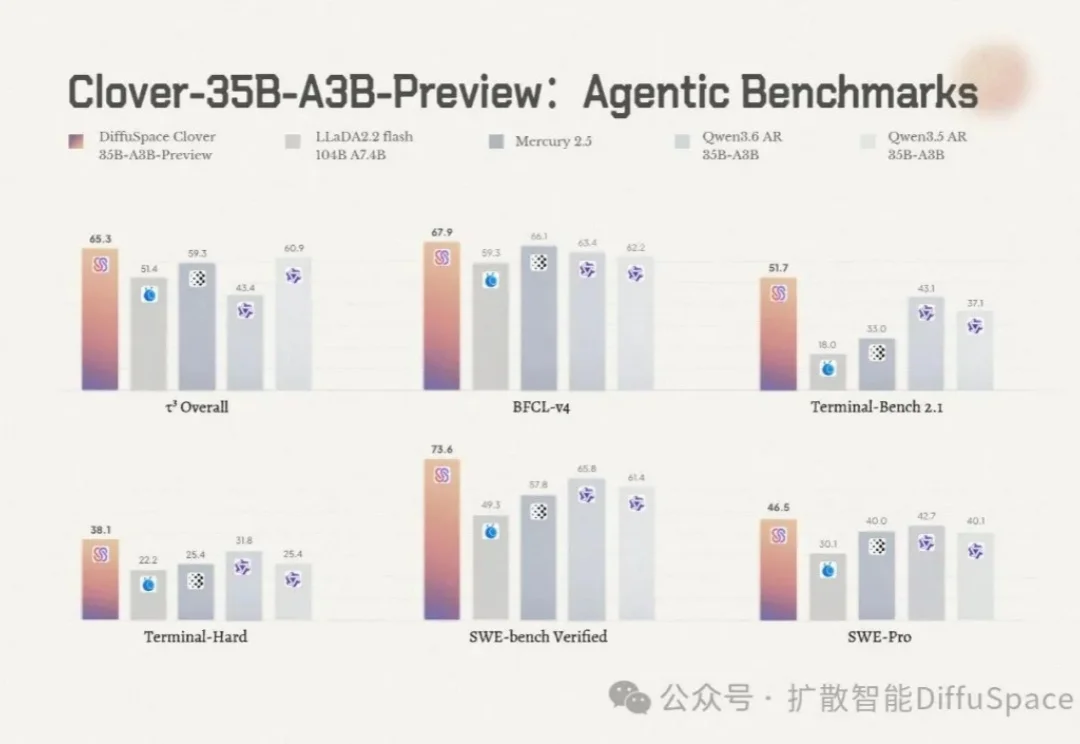
今天,我们正式推出 DiffuSpace Clover(三叶)的第一个版本 35B-A3B-Preview。
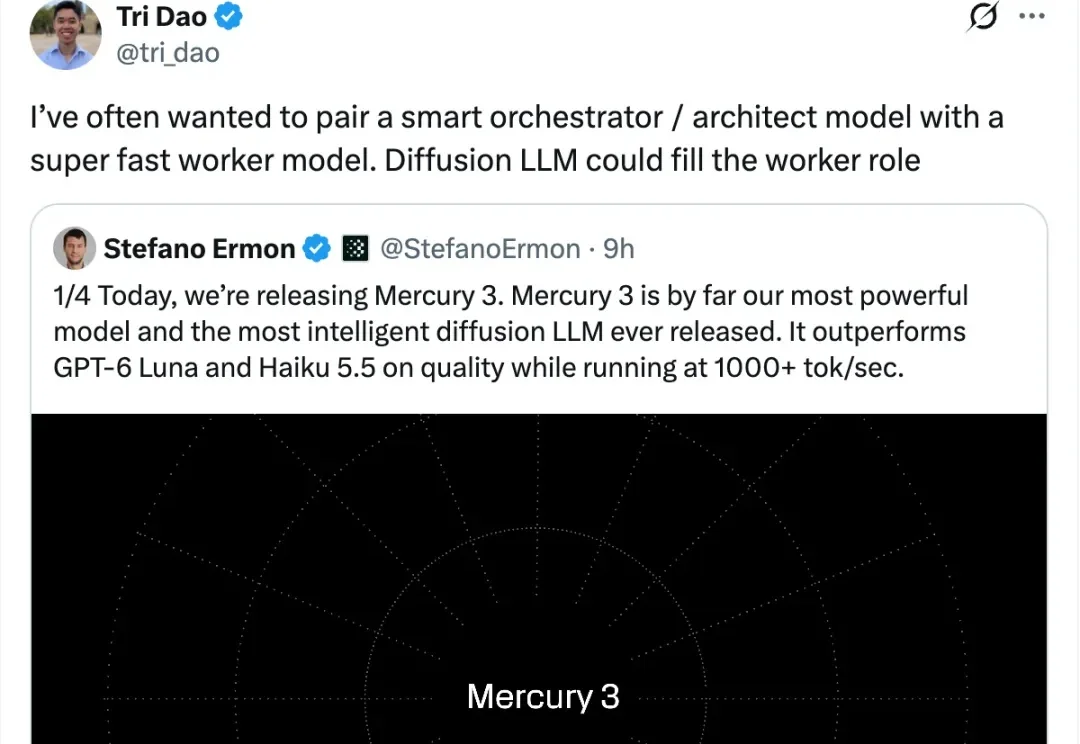
GPT-6 Luna 要被扩散 LLM 抢饭碗了?
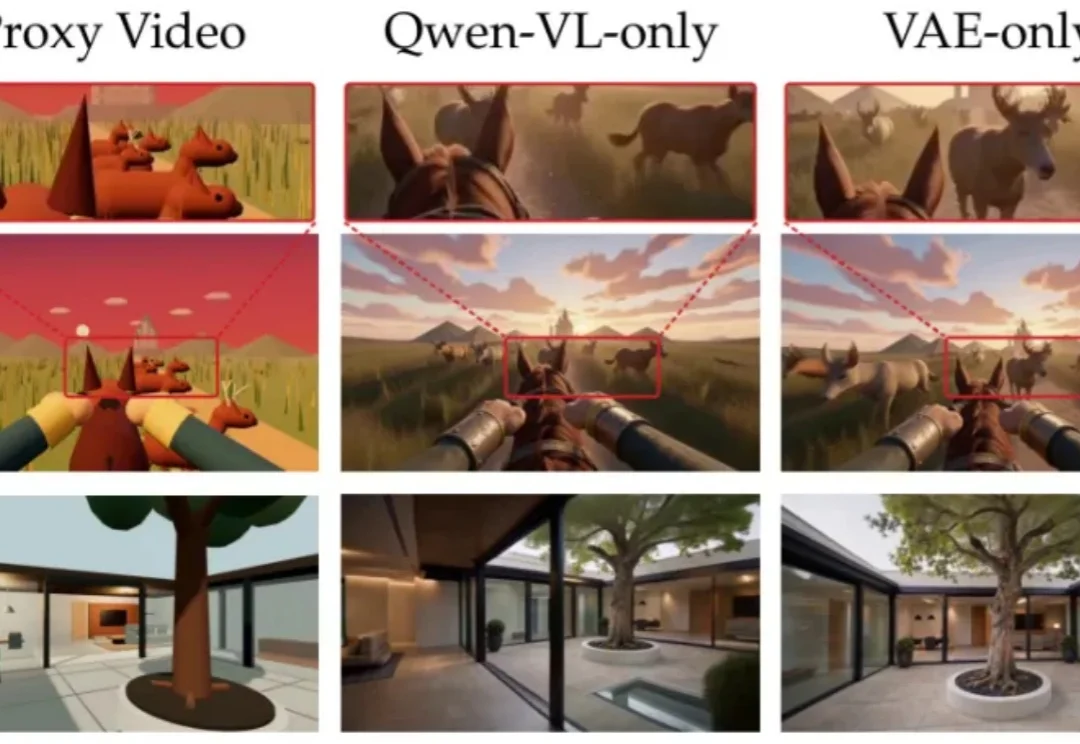
视频生成模型的视觉质量不断提升,但当前主流视频扩散模型仍面临两项根本局限。第一是物理规律约束不足:模型从像素中学习世界的视觉表象,却缺少物理方程的显式约束,画面看似合理,实际却不符合物理规律。
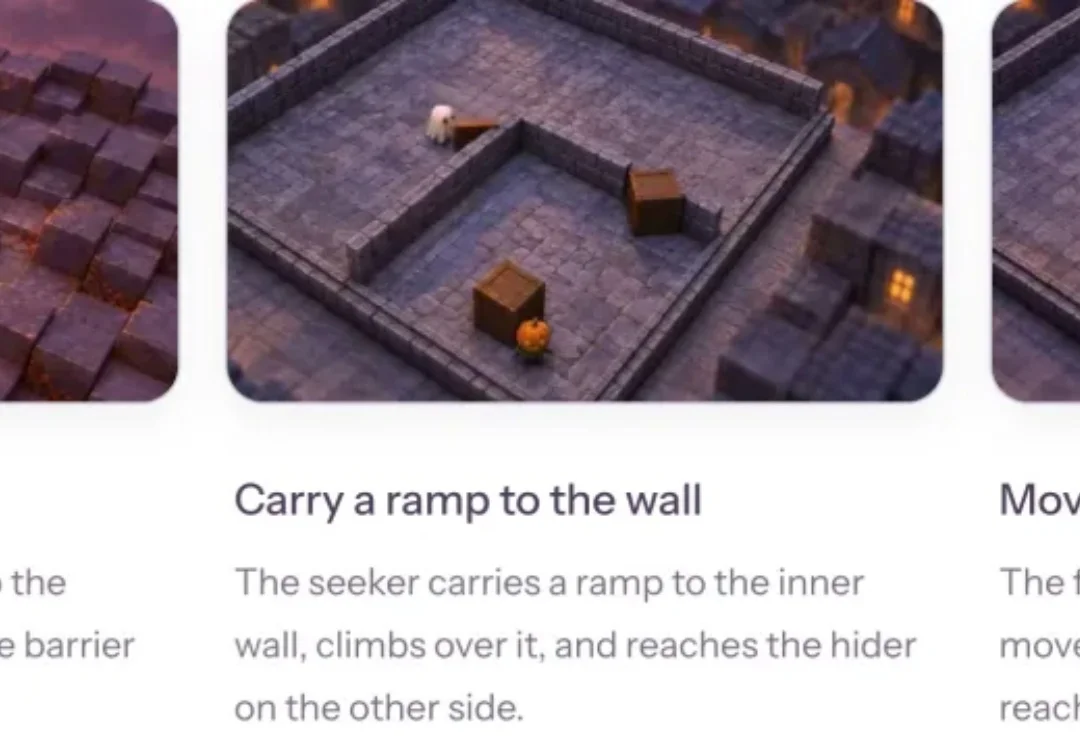
推开一块挡板,通道就此封闭;搬来一段坡道,高墙便有了越过的可能。
扩散智能(DiffuSpace)连续完成两轮数亿元人民币融资,创全球扩散语言模型最大规模融资纪录,经纬创投、顺为资本、君联资本联合领投,华为哈勃等跟投。
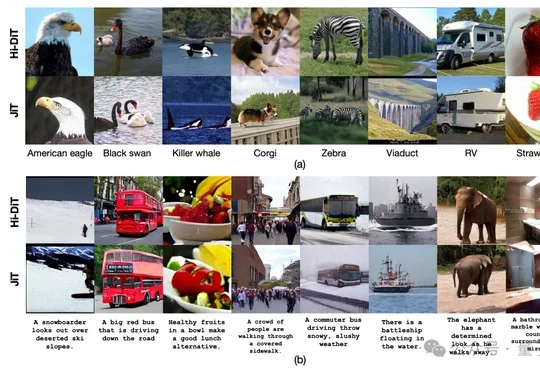
中科大与智象HiDream.ai团队提出Hi-DiT,采用时间门控机制在共享Transformer中分阶段协调Latent与Pixel双流以兼顾生成效率与细节保留,在ImageNet 256×256上达到1.06 FID,论文已被ECCV 2026接收。
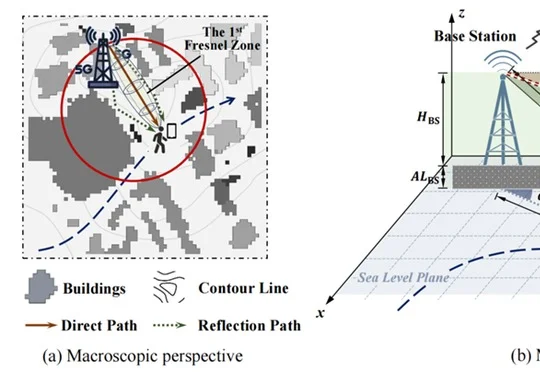
清华大学与北京邮电大学联合提出物理引导扩散模型Channel-Diff,将传播模型、阴影遮挡与多径几何嵌入条件扩散模型,实现无线信道多尺度RSRP预测,在两套真实数据集上相较次优方法分别取得37.19%和25.15%的综合性能提升。
扩散智能DiffuSpace与Acrab联合测试显示,扩散语言模型凭借全局并行生成机制可将端侧Agent运行速度提升约5倍,双方计划加速推进其在AI PC、智能汽车等场景落地。
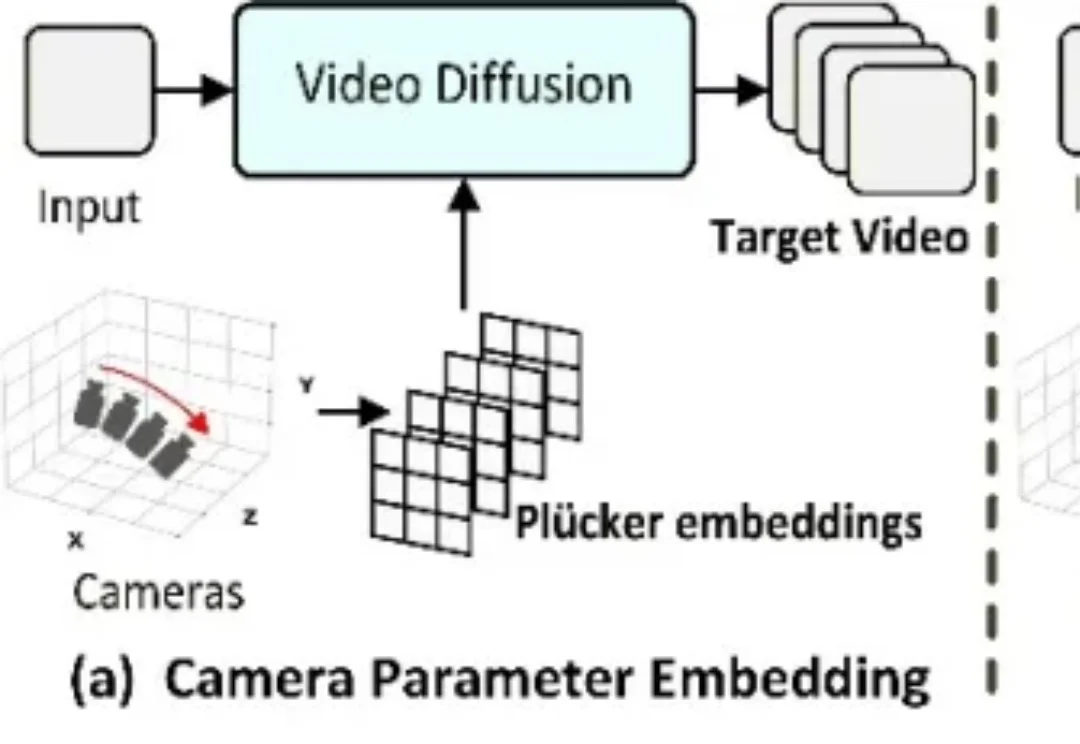
随着视频扩散模型能力不断提升,从单张图像出发、按照用户指定的相机轨迹生成新视角视频,正在成为 World Modeling 的重要技术路线。