
效率提升25%,灵巧操作数采困境被「臂-手共享自主框架」解决
效率提升25%,灵巧操作数采困境被「臂-手共享自主框架」解决实现通用机器人的类人灵巧操作能力,是机器人学领域长期以来的核心挑战之一。近年来,视觉 - 语言 - 动作 (Vision-Language-Action,VLA) 模型在机器人技能学习方面展现出显著潜力,但其发展受制于一个根本性瓶颈:高质量操作数据的获取。
来自主题: AI技术研报
10562 点击 2025-12-12 09:38

 搜索
实现通用机器人的类人灵巧操作能力,是机器人学领域长期以来的核心挑战之一。近年来,视觉 - 语言 - 动作 (Vision-Language-Action,VLA) 模型在机器人技能学习方面展现出显著潜力,但其发展受制于一个根本性瓶颈:高质量操作数据的获取。
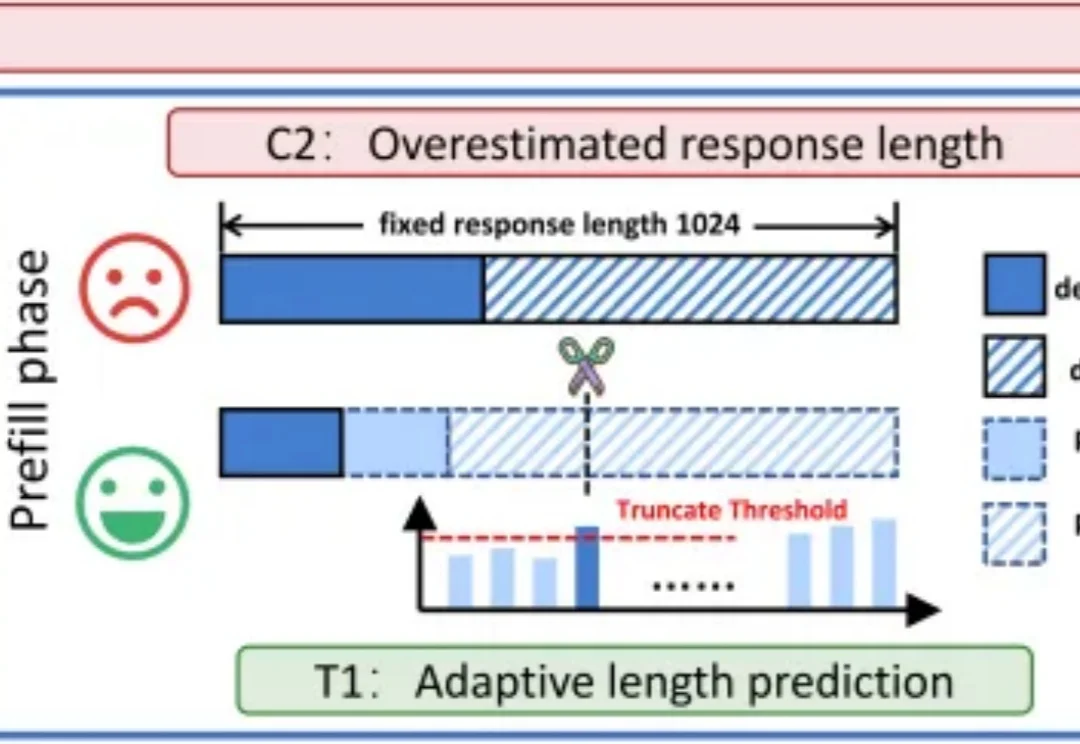
基于扩散的大语言模型 (dLLM) 凭借全局解码和双向注意力机制解锁了原生的并行解码和受控生成的潜力,最近吸引了广泛的关注。例如 Fast-dLLM 的现有推理框架通过分块半自回归解码进一步实现了 dLLM 对 KV cache 的支持,挑战了传统自回归 LLMs 的统治地位。
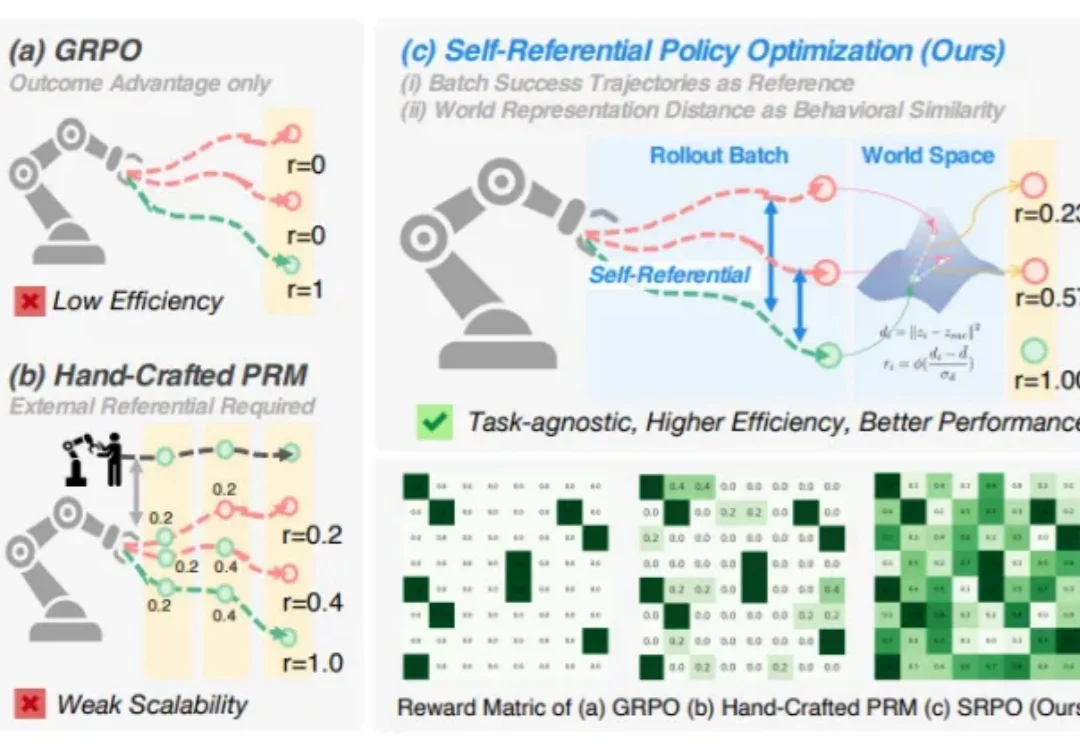
你是否想过,机器人也能像人一样,从失败中学习,不断自我提升?
具体来说,Open-AutoGLM 由一个手机端智能助手框架 Phone Agent 和一个 9B 大小的模型 AutoGLM-Phone-9B 共同组成。这次开源对行业的影响力,核心来自这次智谱开源的不是一个普通的 GUI agent 模型,而可能是行业最好的模型。
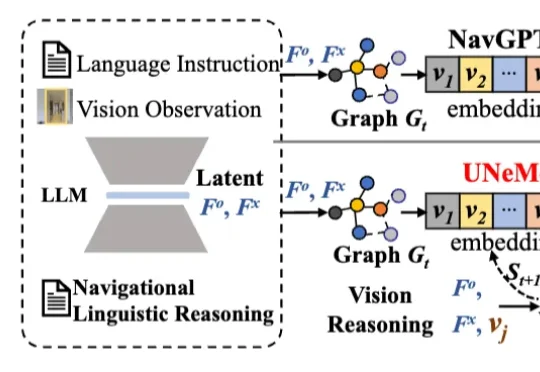
深圳大学李坚强教授团队最近联合北京理工莫斯科大学等机构,提出视觉-语言导航(VLN)新框架——UNeMo。让机器人听懂指令,精准导航再升级!
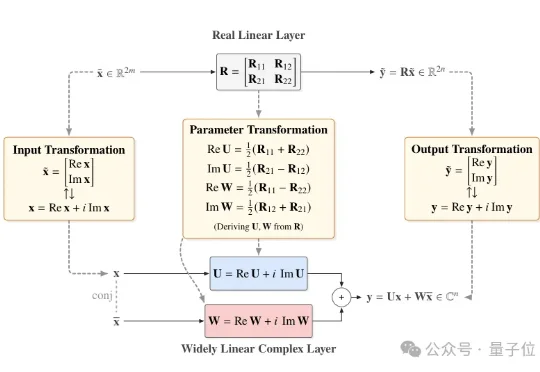
近日,北京大学团队提出一个直接基于已有预训练模型进行极低比特量化的通用框架——Fairy2i。该框架通过广泛线性表示将实数模型无损转换为复数形式,再结合相位感知量化与递归残差量化,实现了在仅2比特的情况下,性能接近全精度模型的突破性进展。
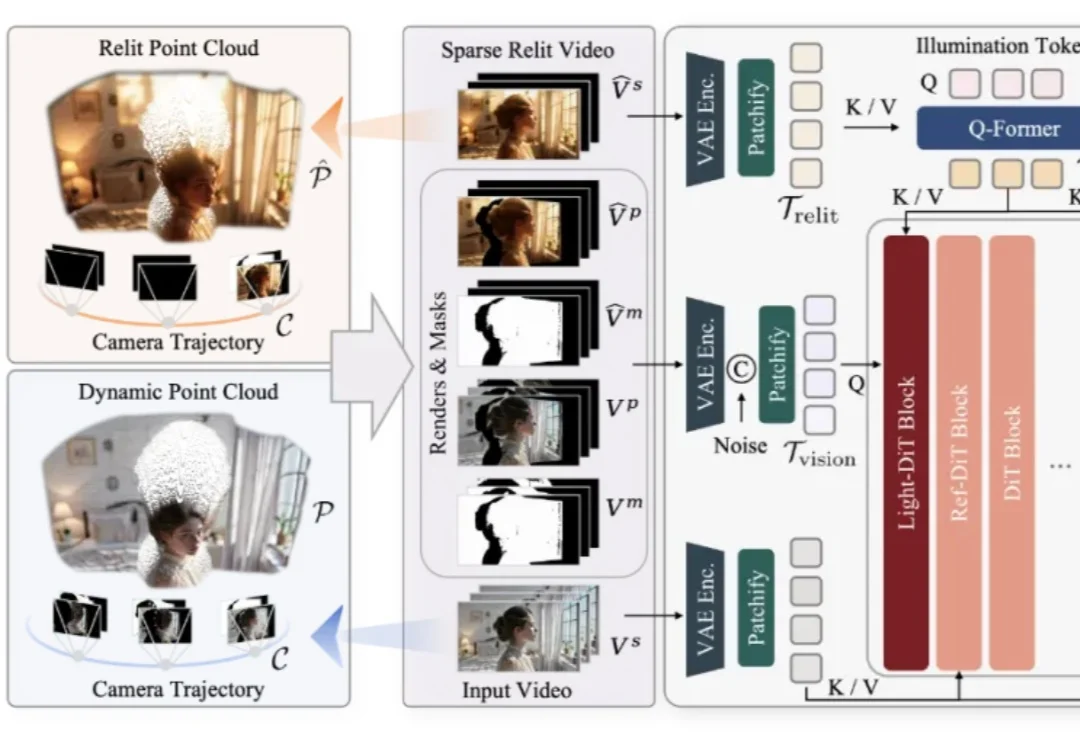
仅凭一段随手拍摄的单目视频,是否能够让镜头在空间中自由飞行,让光线随意变换,让原本固定的真实场景在全新的视角与照明条件下被再次「拍摄」?这一过去被视作科幻设想的问题,如今迎来了明确答案。
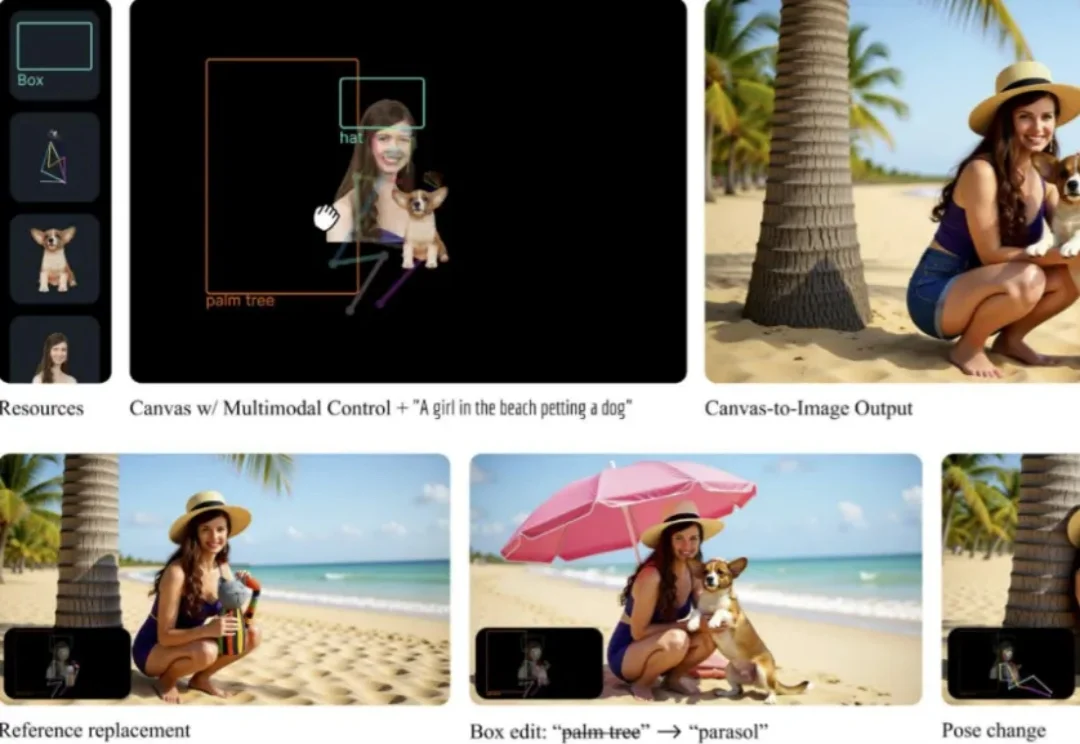
Canvas-to-Image 是一个面向组合式图像创作的全新框架。它取消了传统「分散控制」的流程,将身份参考图、空间布局、姿态线稿等不同类型的控制信息全部整合在同一个画布中。用户在画布上放置或绘制的内容,会被模型直接解释为生成指令,简化了图像生成过程中的控制流程。
最近,Google Research 发布了一篇 Blog《Titans + MIRAS:帮助人工智能拥有长期记忆》。它们允许 AI 模型在运行过程中更新其核心内存,从而更快地工作并处理海量上下文。
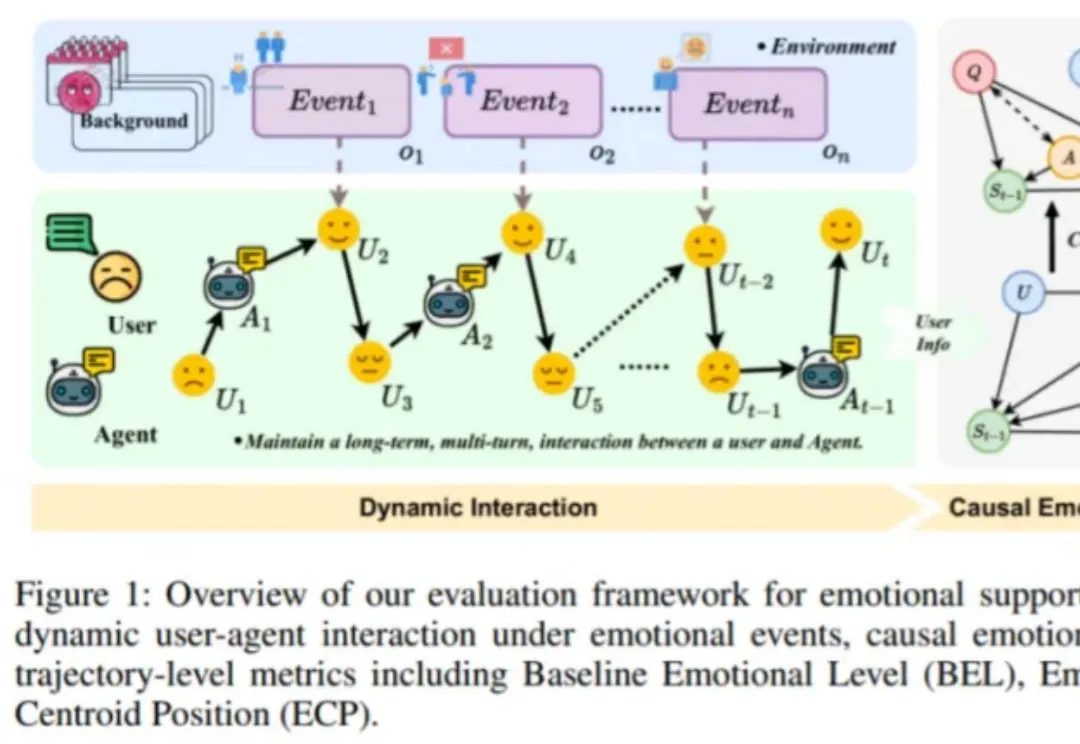
近日,由趣丸科技与北京大学软件工程国家工程研究中心共同发表的《Detecting Emotional Dynamic Trajectories: An Evaluation Framework for Emotional Support in Language Models(检测情感动态轨迹:大语言模型情感支持的评估框架)》论文,获 AAAI 2026 录用。