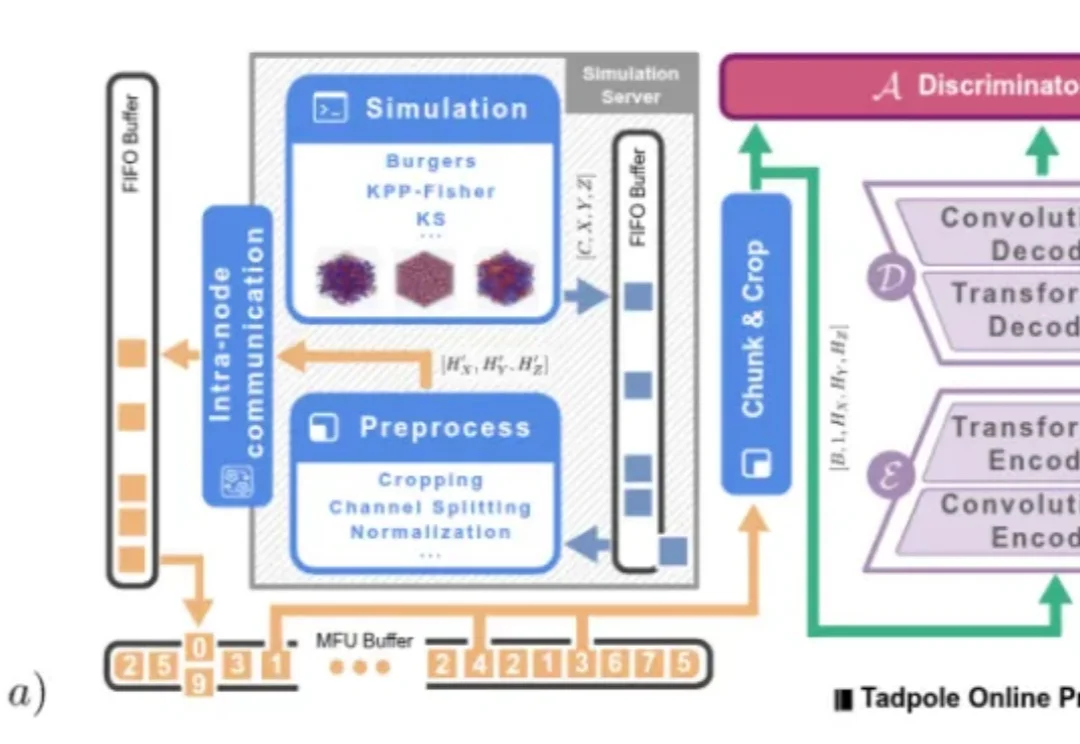
从「预测未来」到「理解世界」:Tadpole与一种新的科学基础模型思路
从「预测未来」到「理解世界」:Tadpole与一种新的科学基础模型思路过去几年,“基础模型” 已经彻底改变了自然语言处理和计算机视觉。一个很自然的问题随之出现: 物理世界是否也能拥有类似的基础模型?
来自主题: AI技术研报
9843 点击 2026-10-16 11:26

 搜索
过去几年,“基础模型” 已经彻底改变了自然语言处理和计算机视觉。一个很自然的问题随之出现: 物理世界是否也能拥有类似的基础模型?
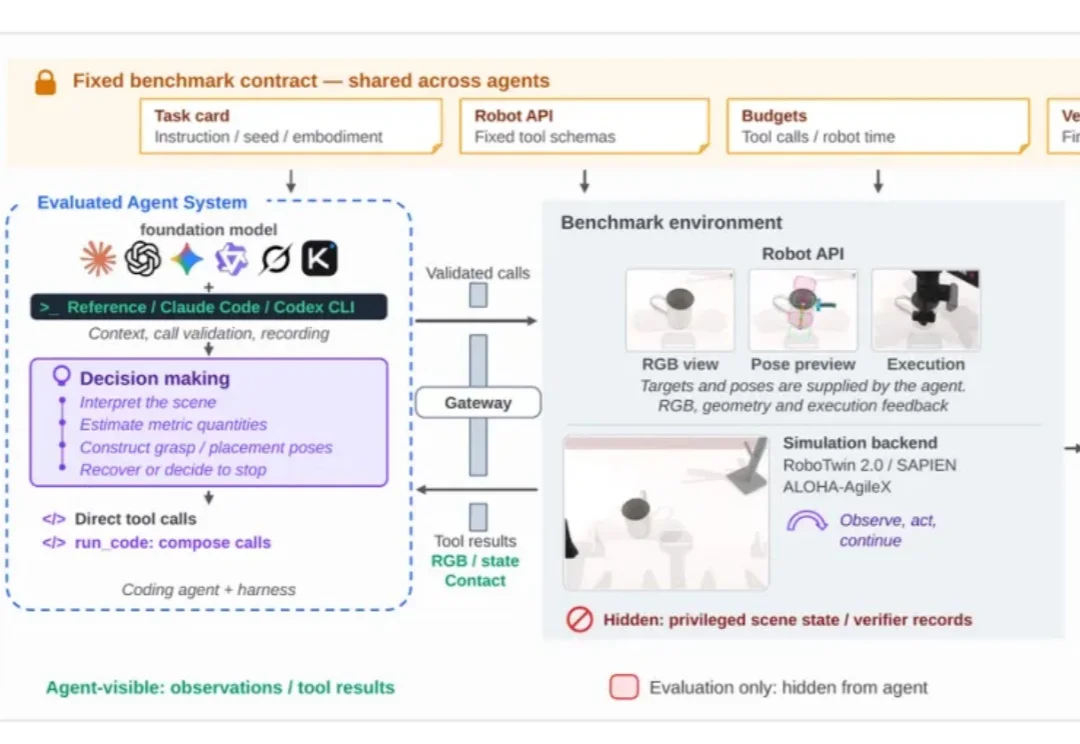
从视觉观察到策略生成,再到物理执行与完成判断,CodeActionBench 在统一条件下评测通用多模态 Agent 的机器人操作能力。在双臂仿真评测中,GPT-6 Astra (Codex CLI) 的尝试成功率达到 73.3%,Claude Opus 5 在 Reference harness 和 Claude Code 下分别取得 49.3% 和 45.3%。
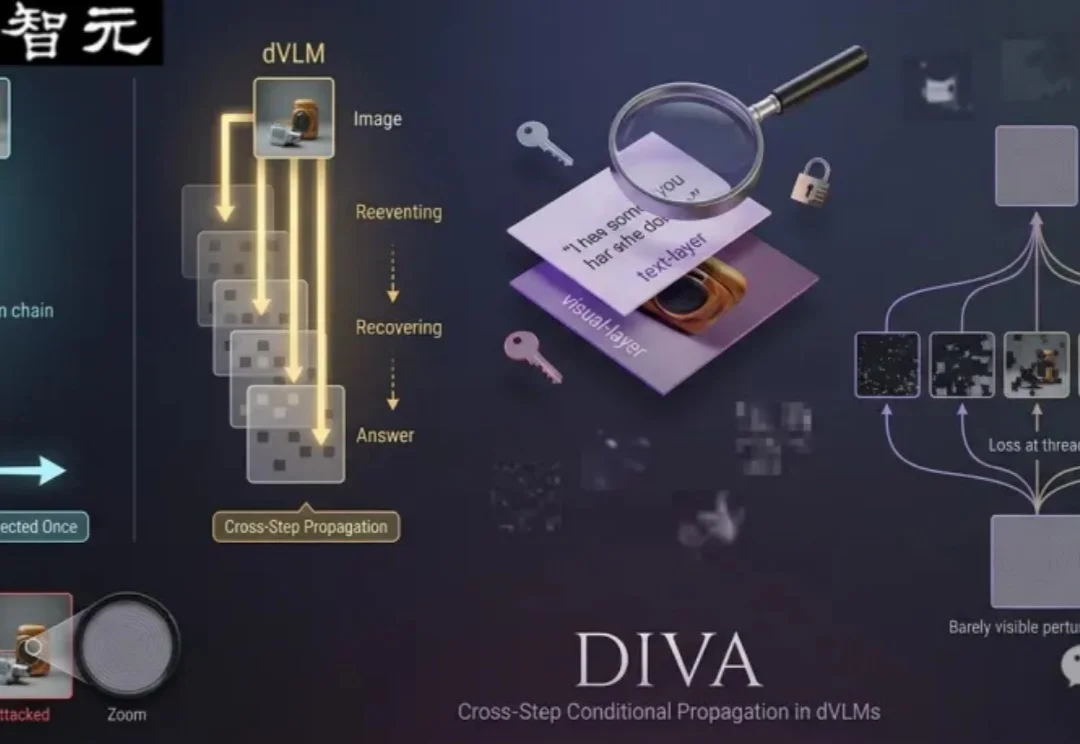
视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。
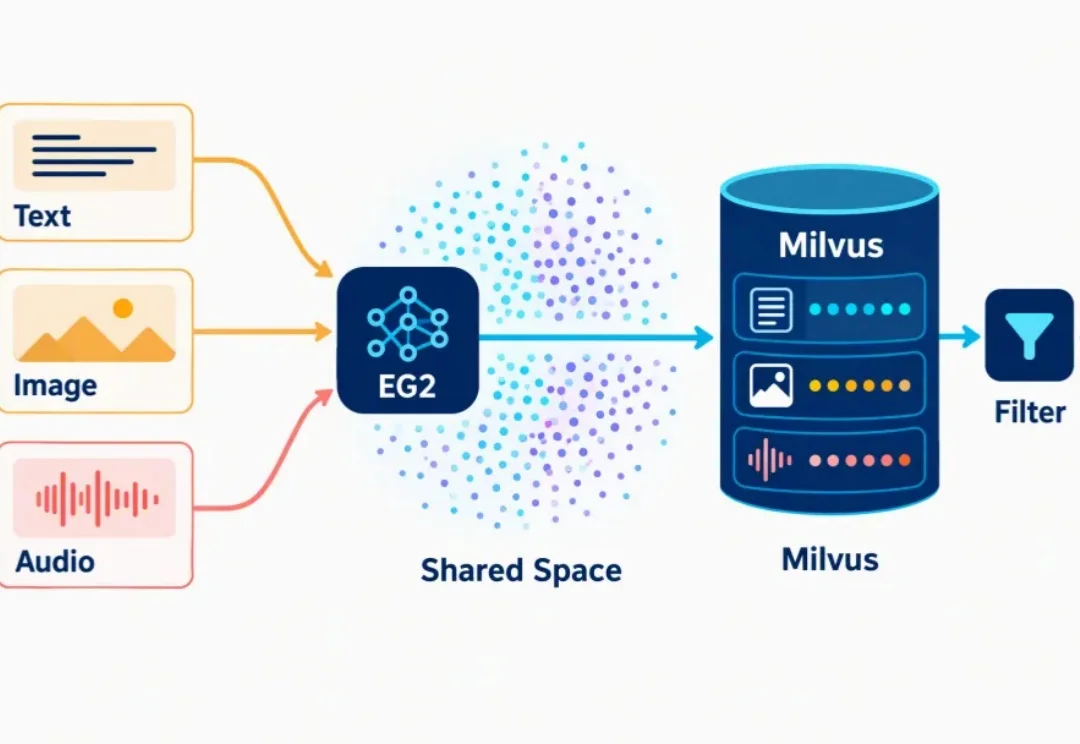
传统多模态检索,往往要维护多套embedding模型。文本用一套 embedding,图片用一套视觉模型,音频再单独接一条链路。
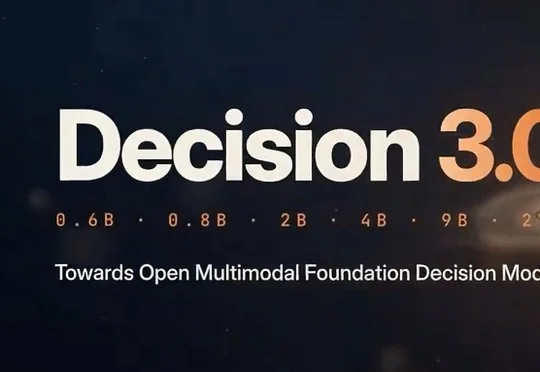
vLLM Semantic Router推出并开源Decision 3.0系列多模态决策模型,覆盖0.6B至27B六款模型,其中d3在Jev Decision Index 0.3.1文本榜和视觉榜均排名第一。
对着屏幕说一句 “向左转”,画面随即展开新的视野;调整角色的动作,场景紧接着给出反馈。多模态交互要求视觉生成跟上人的操作,而漫长的等待会打断整个体验。
多模态模型的视觉原生Harness,来了!
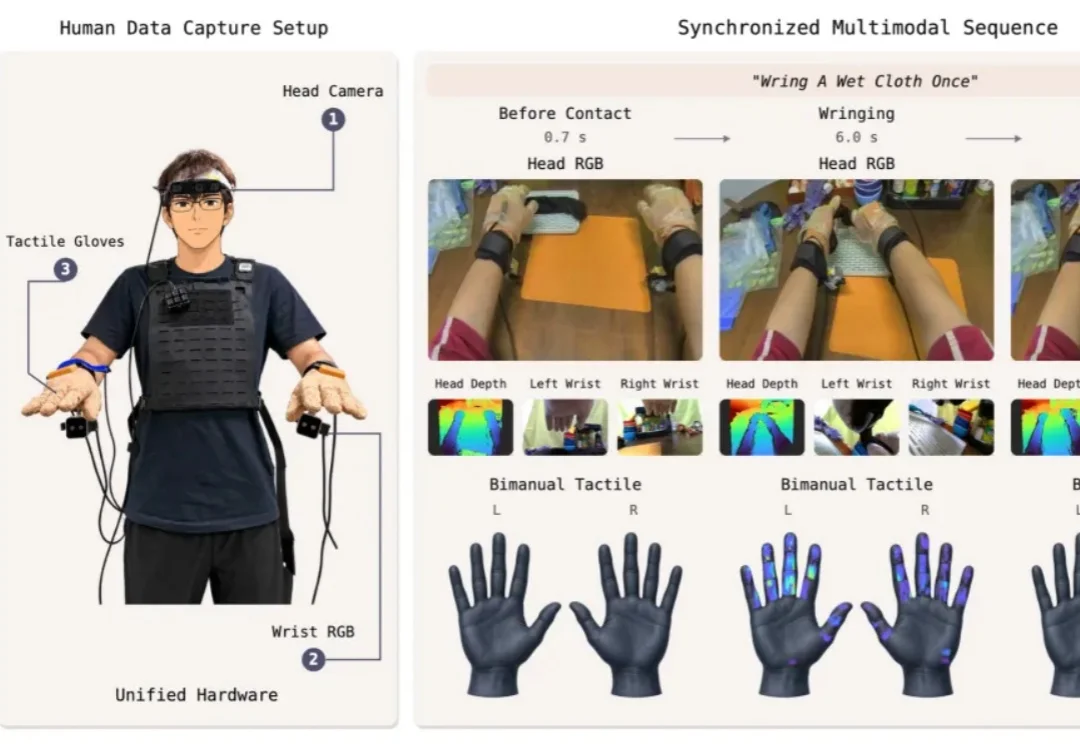
拿起一枚生鸡蛋,手指需要施加恰到好处的力:既要防止滑落,又不能捏碎。拧一条湿毛巾,指尖的力道也要随着水分挤出不断调整。对人类而言,这些操作几乎出于本能。但如果只依赖视觉,摄像头拍得下手部轨迹,却捕捉不到手指接触的位置与按压的力度。
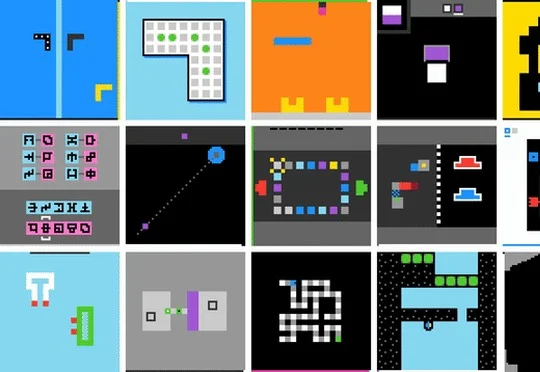
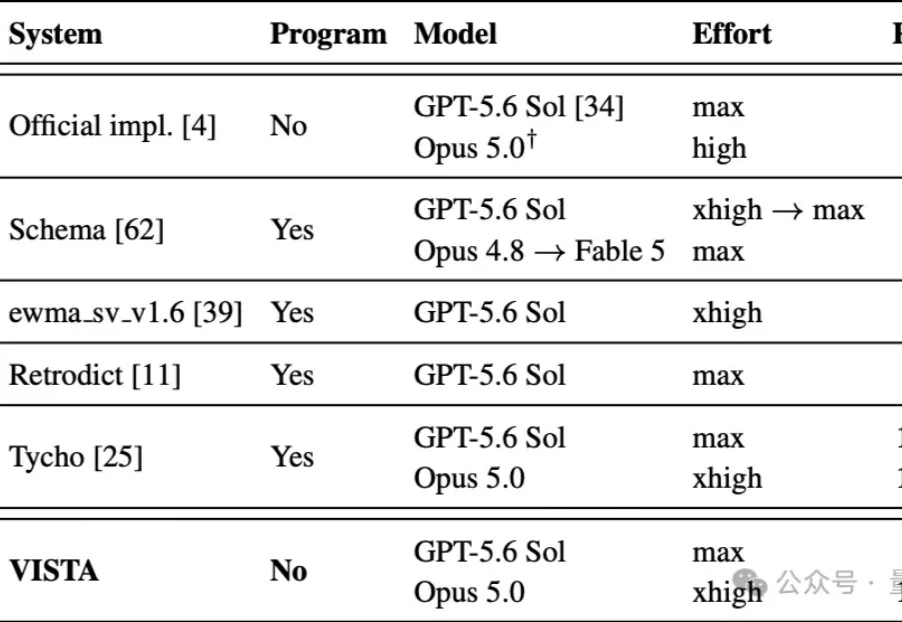
何恺明团队提出VISTA方法,将ARC-AGI-3的数字表换回图像并配备可随时翻看的视觉记忆相册,使Claude Opus 5拿下满分100分、GPT-5.6 Sol获得99分,证明卡住大模型的是眼睛和记性而非模型能力本身。
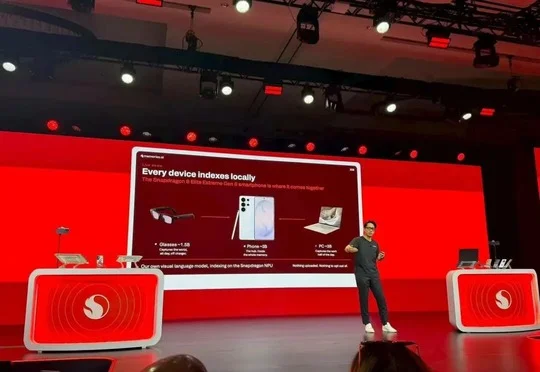
Meta个人智能体Muse爆火后,沈俊潇创办的Memories.ai押注视觉记忆赛道,其视觉模型栈已在高通骁龙平台实现手机、PC与智能眼镜的端侧持续感知,并与英伟达达成合作,成为芯片厂商卡位生态的重要伙伴。