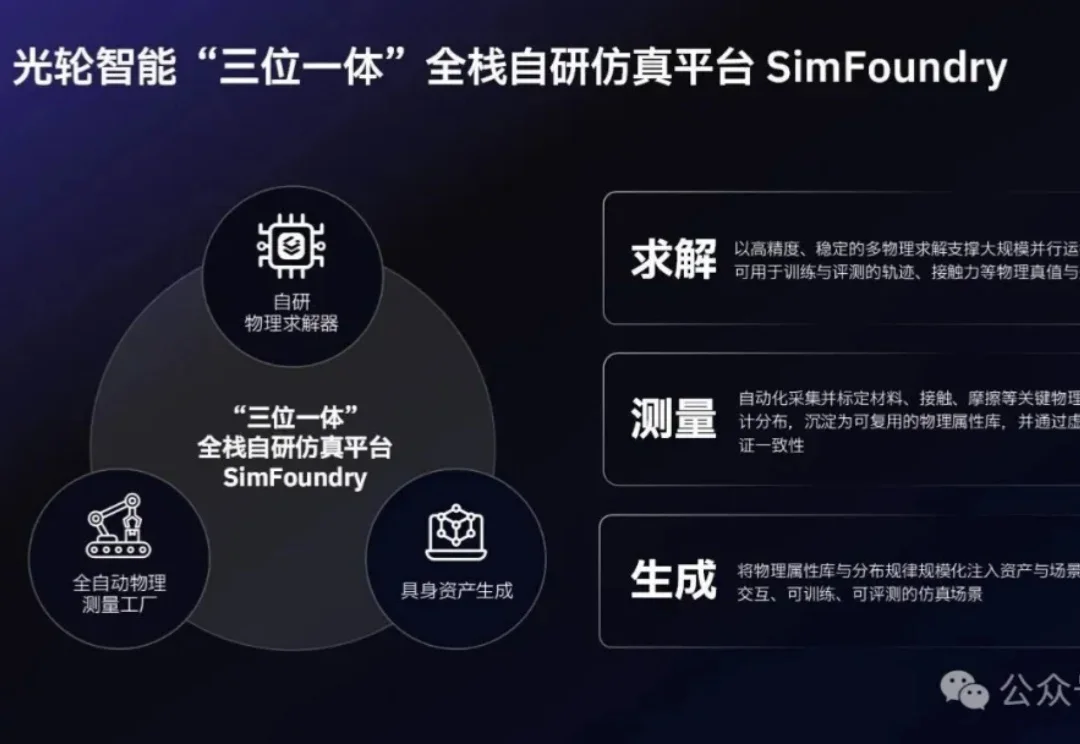
物理AI的强化学习仿真环境来了,光轮智能推出RoboFinals RL Envs
物理AI的强化学习仿真环境来了,光轮智能推出RoboFinals RL Envs强化学习环境(RL Envs)正在成为一门新生意。
来自主题: AI技术研报
9131 点击 2026-11-17 10:25

 搜索
强化学习环境(RL Envs)正在成为一门新生意。
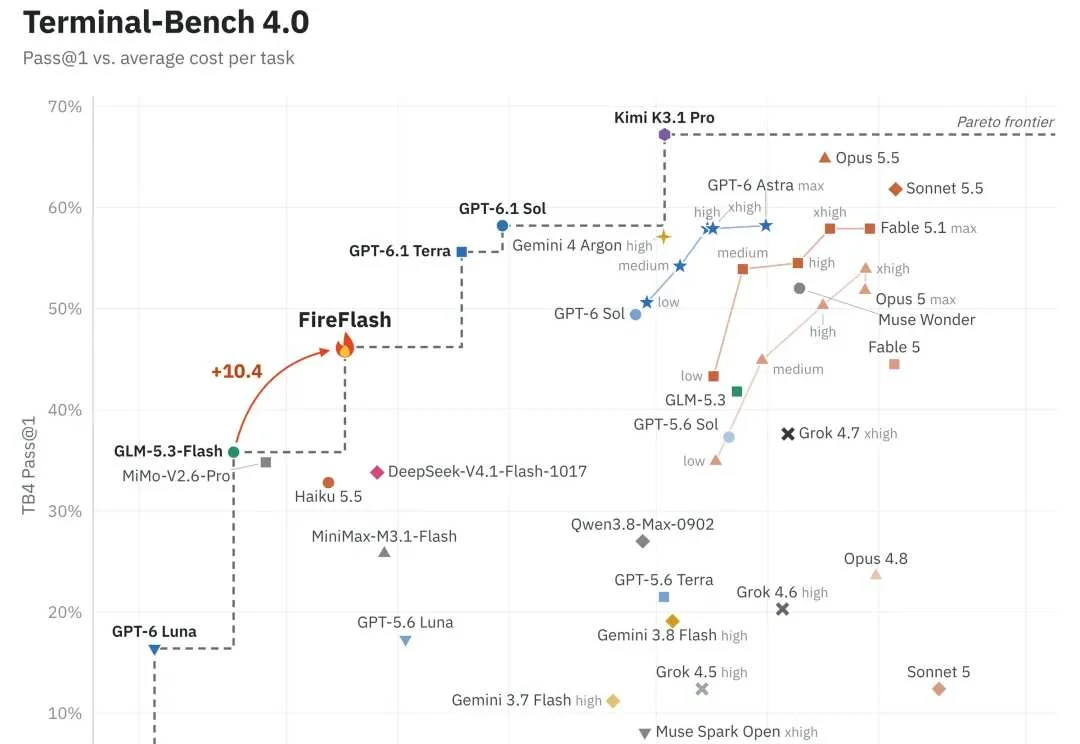
长程智能体(long-horizon agents)正从「修一个 bug」走向连续数小时的终端与编程工作,但它的强化学习训练也格外昂贵:前沿实验室可以在数千张 GPU 上扩展 RL,而对多数团队来说,一条训练样本往往就是一次长达 3 小时、上百轮工具调用的完整尝试,任何一个环节出错,浪费的都是成小时的 GPU 时间。
文章分析前沿模型文字难懂的原因,指出 Google 通过 LearnLM 将易读性、命题保真度、认知负荷管理和强化学习后训练融入 Gemini 2.5 Pro 与 Flash,并介绍 UIDPO 和修辞结构对齐两种认知对齐路径。
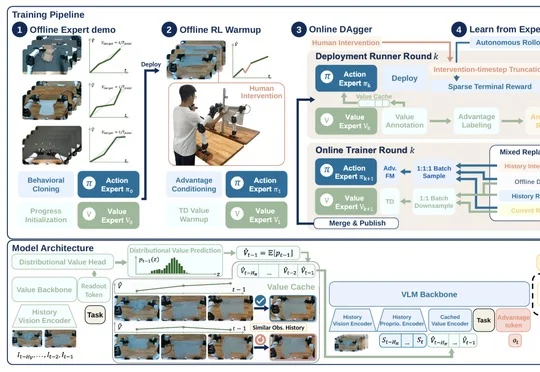
Value as Memory(VaM)将近期价值预测作为任务进度记忆并结合离线到在线真机强化学习,使机器人在纸盒装配中连续自主运行4小时、成功率超过95%,最终任务成功率较无价值缓存版本提升29.4%。
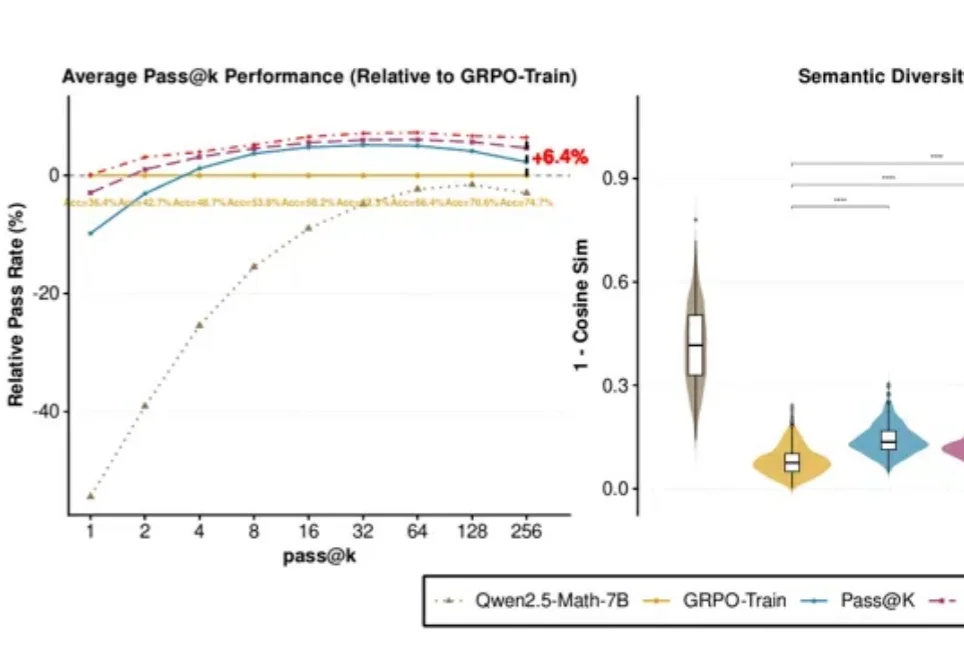
DeepSeek-R1等模型让人们看到了强化学习的潜力。但已有研究发现,模型答得更准,未必意味着能解出的题目更多。
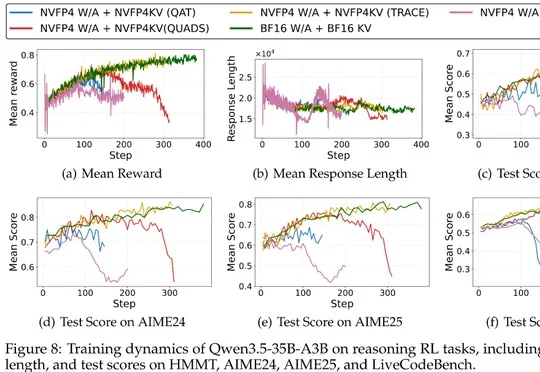
阿里千问联合俄亥俄州立大学提出TRACE,以Rollout侧FP4量化结果引导训练侧舍入,在四个Qwen MoE模型上保持接近BF16的性能,并使128K输出解码吞吐最高提升5.4倍。
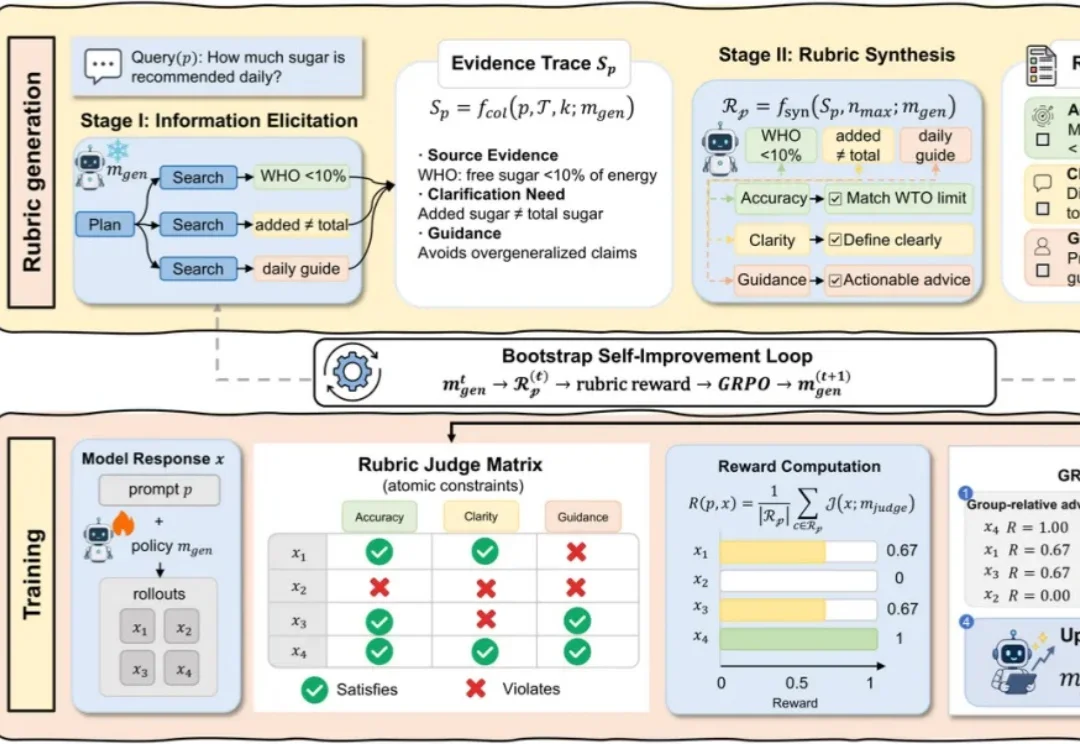
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
千问披露Agent训练框架QwenGyre,通过弹性调度和轨迹处理,将Qwen 3.8 2.4T的48步强化学习训练耗时从134.55小时降至75.42小时、效率提升78%,并计划优化后开源。
2026 年 9 月 11 日,一封联名声明震动了学术界。
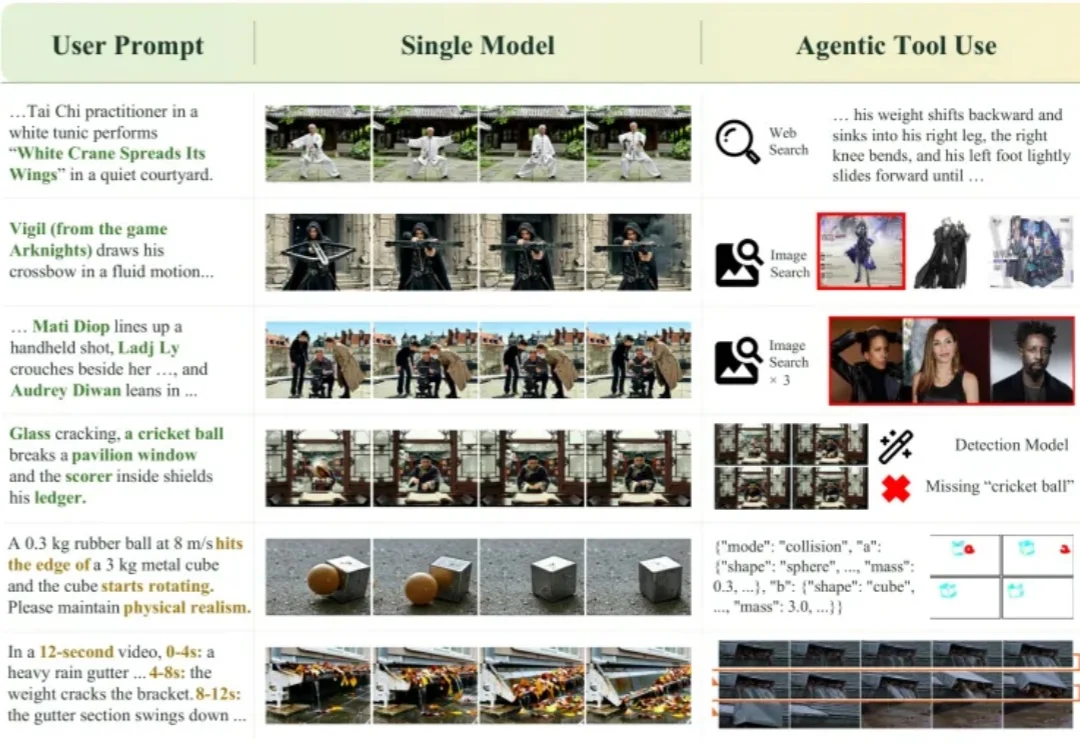
从检索动作知识、寻找角色参考,到模拟运动和衔接镜头,一个经过强化学习的智能体,能给视频生成带来多大提升?