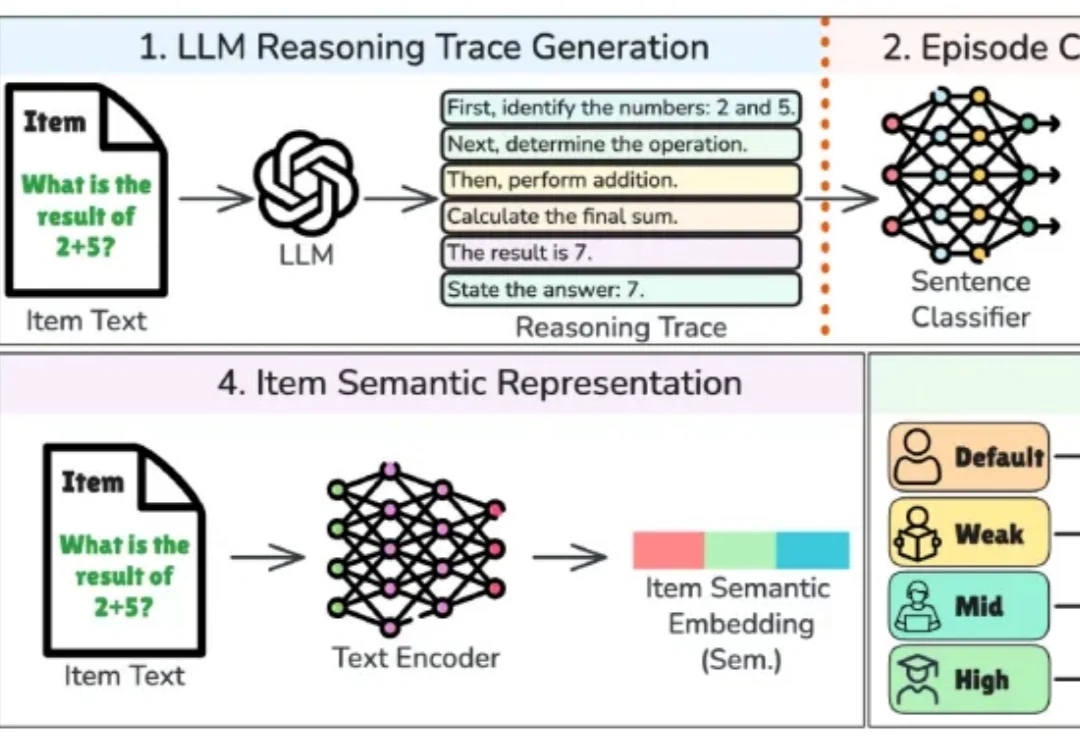
不用考生实测就知道题难不难:这个AI试题评测框架把考试难度“量化”了 | TMLR
不用考生实测就知道题难不难:这个AI试题评测框架把考试难度“量化”了 | TMLR一道试题对人来说有多难,能否从大模型的解题过程中找到线索?
来自主题: AI技术研报
6146 点击 2026-11-02 15:35

 搜索
一道试题对人来说有多难,能否从大模型的解题过程中找到线索?
各大AI框架都错了!
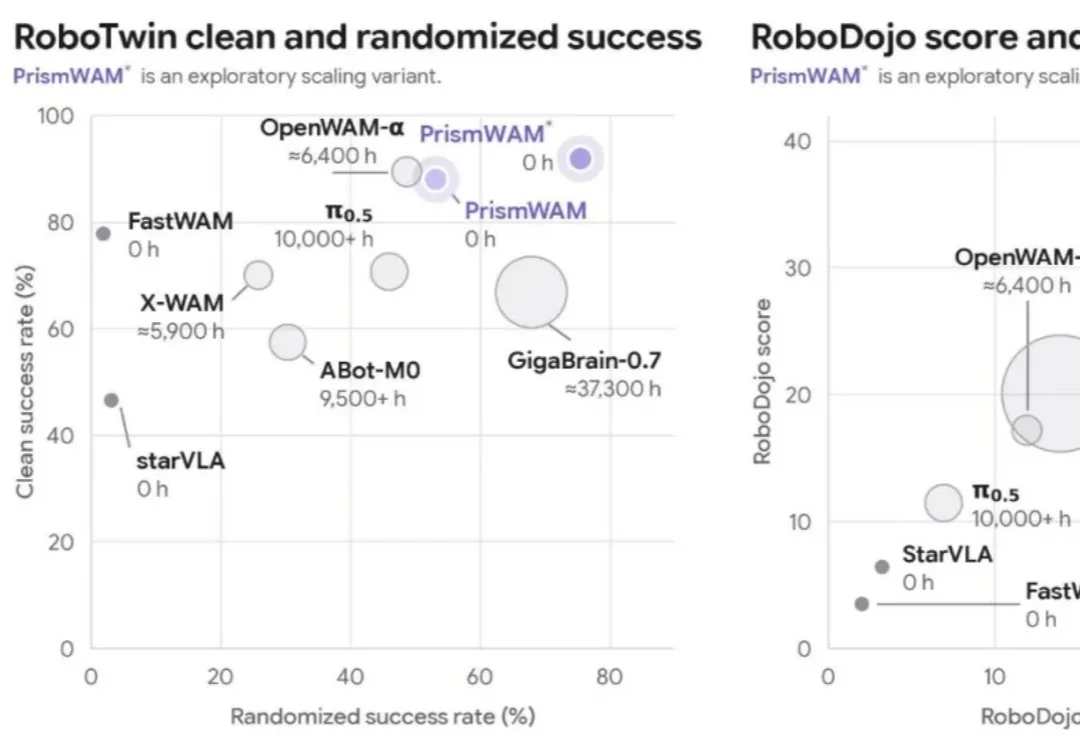
近日,厘清智能创始人、清华大学人工智能学院李一鸣教授团队发布了两项 Physical AI 研究成果:世界动作模型 PrismWAM,以及面向机器人执行诊断与持续改进的 Agentic 框架 RoboDoctor。
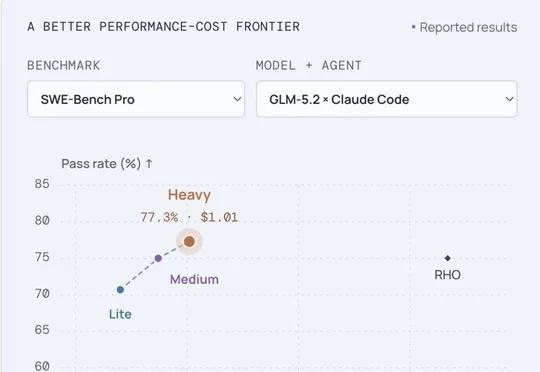
智谱唐杰团队发布并开源无标签递归自我改进框架HarnessPro,在SWE-Bench Pro等基准提升通过率的同时,将单任务平均成本降低53.0%。
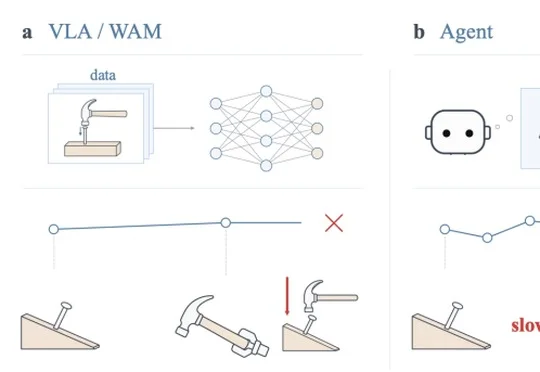
复旦大学可信具身智能研究院团队提出具身自进化框架RoboSkill,通过触觉反馈确认物理状态并积累、复用含代码的Skill,减少机器人Agent重复探索与推理,缩短任务执行时间。
上海交大00后团队创办的芯生代完成数千万元种子轮融资,计划让Agent为不同模型、芯片和场景生成可自我迭代的定制推理引擎,其EvoKernel框架已将昇腾算子生成正确率从4%提升至83%。
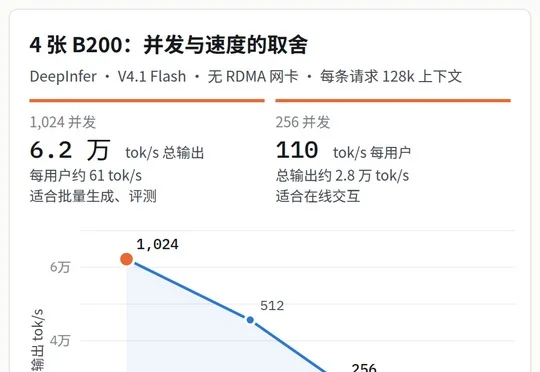
DeepSeek 开源的推理框架 DeepInfer 经 PCIe 本机取数改造后,可在无 RDMA 网卡的 4 张 B200 上以 128k 上下文承载 1024 并发,总输出约 6.2 万 token/s。
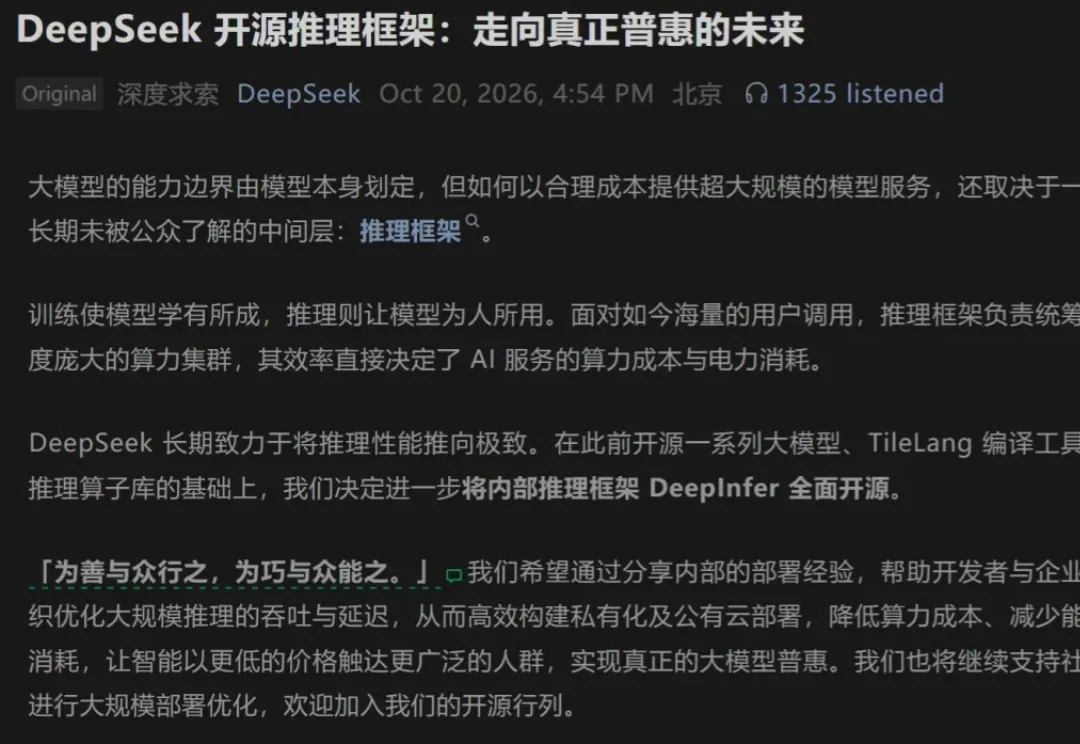
没想到这也开源了。
就在刚刚,DeepSeek再放大招,全面开源自研推理框架DeepInfer。一个集群一天服务155万亿Token,DeepSeek V4.1 Flash高吞吐、低延迟的大规模推理,靠的就是它。
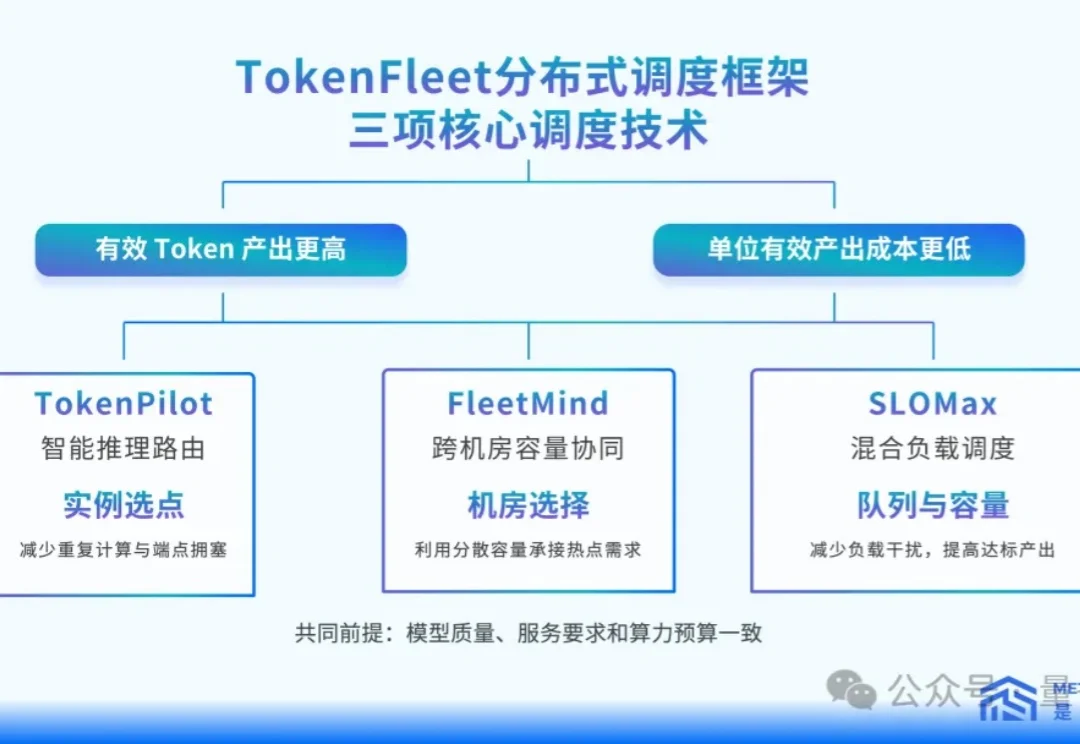
GPU集群里,请求排队和资源闲置,可能同时发生。