29岁曾妍背后,字节正在组建一支怎样的AI军团?
29岁曾妍背后,字节正在组建一支怎样的AI军团?字节跳动Seed团队已汇聚曾妍、吴永辉、周畅等约1000名研究人员并持续重组,覆盖语言、图像、视频、语音、Agent、机器人和AI for Science等方向,虽推出Seed2.0、Seedance 2.0等模型,但跨团队协同与训练效率仍是追赶OpenAI、Anthropic的挑战。
来自主题: AI资讯
6646 点击 2026-11-21 15:28

 搜索
字节跳动Seed团队已汇聚曾妍、吴永辉、周畅等约1000名研究人员并持续重组,覆盖语言、图像、视频、语音、Agent、机器人和AI for Science等方向,虽推出Seed2.0、Seedance 2.0等模型,但跨团队协同与训练效率仍是追赶OpenAI、Anthropic的挑战。
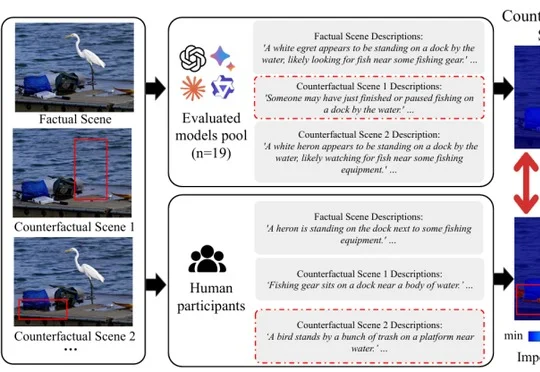
加州大学圣塔巴巴拉分校研究者提出黑盒评估框架反事实语义显著性(CSS),评估19个视觉语言大模型后发现,模型对人类不敏感,过度依赖物体大小、居中程度和低级显著性,其中大小偏好是主要差异因素。
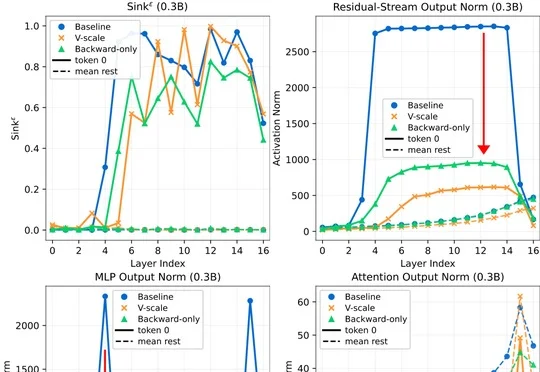
清华大学、北京大学研究团队发现,大语言模型的注意力汇聚会形成梯度汇聚,巨大激活则可通过RMSNorm衰减局部集中梯度;团队以V-scale实验验证了巨大激活的梯度调节作用。
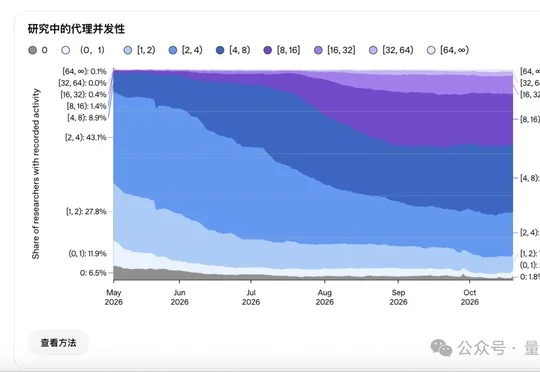
OpenAI在《Research acceleration: The jagged frontier》中称,内部Agent可独立完成46%原需2至4小时的研究任务,API等效价值已达研究员非股权薪酬两倍,但复杂构建与研究判断仍需人类把关。
大模型军备竞赛打到今天,训练成本成了一个停不下来的无底洞。国外已经在讲 10 万亿参数,国内大厂也纷纷设想 2 万亿、5 万亿。
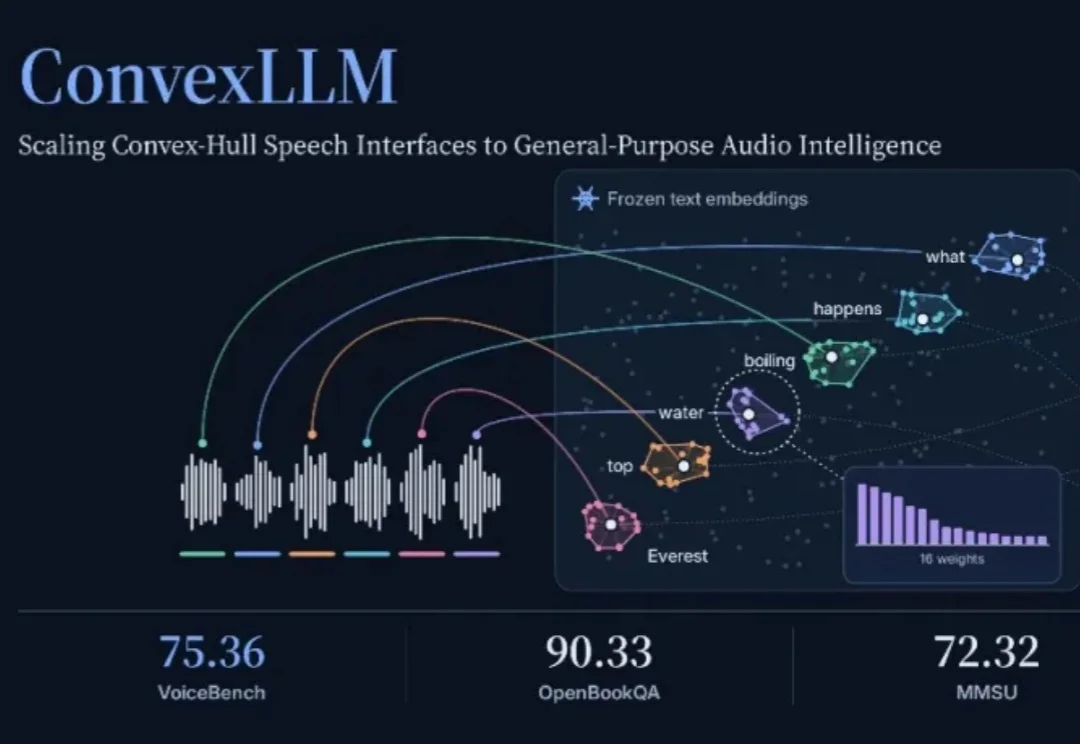
此次提出的 ConvexLLM,通过创新的 C-Gate 架构,将语音信息映射至大语言模型原有文本词向量的凸包中,使模型能够充分发挥已有的知识储备与推理能力。在 VoiceBench 等多项基准测试中,ConvexLLM 取得了同量级开源模型中的领先表现,为语音与语言的统一建模提供了新的技术路径。
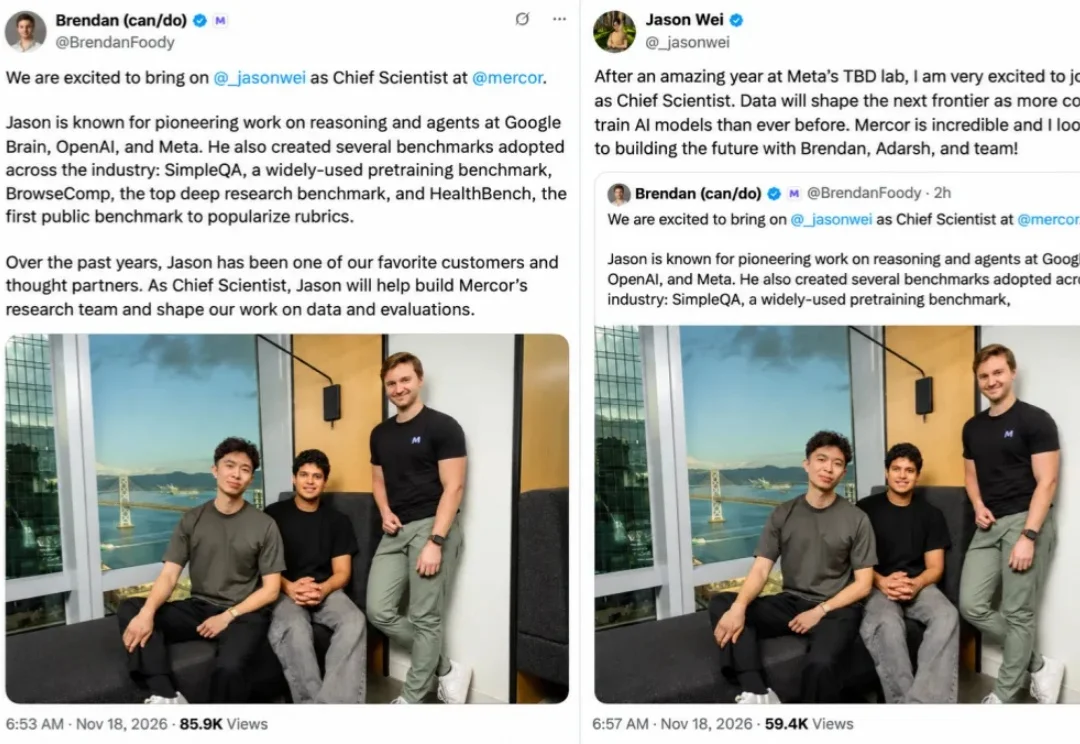
Meta 超级智能实验室,又有一位重量级研究员离开了。
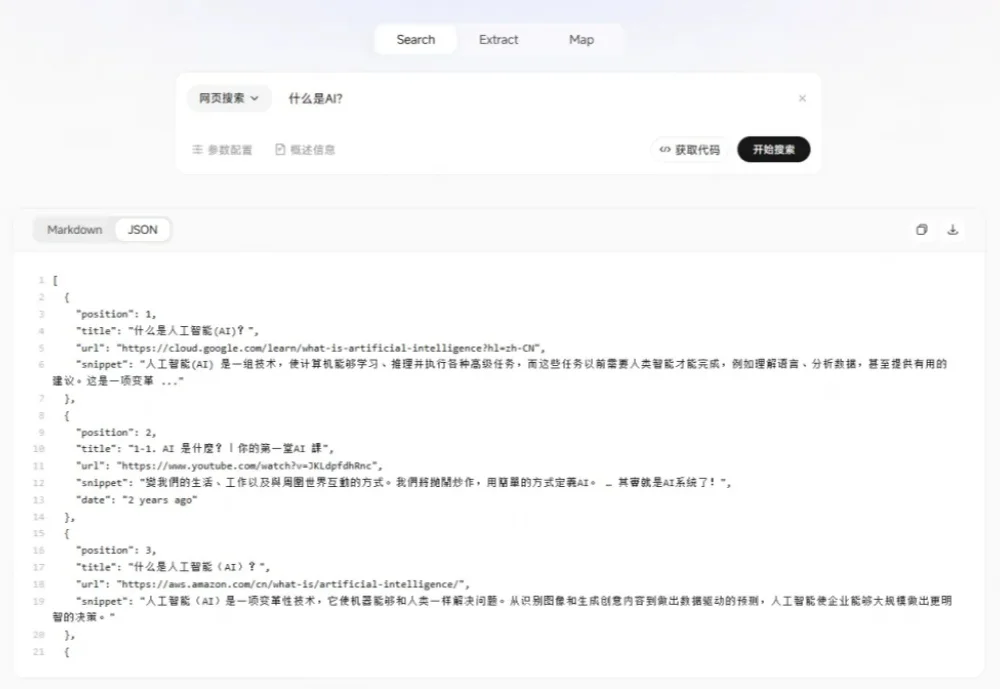
当 AI Agent 开始替人读网页、做研究、跑自动化流程时,行业真正的瓶颈已经从“模型能力本身”,变成了“它能不能在正确的时间拿到正确、干净、足量的信息”。
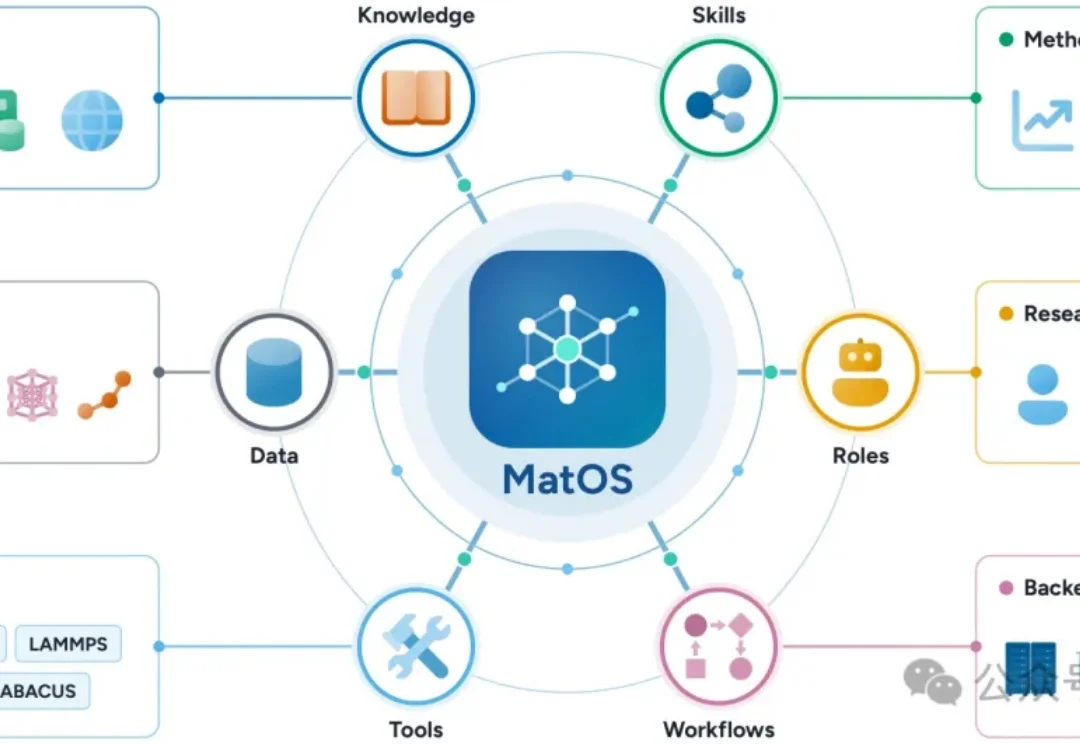
大模型智能体已经能够检索文献、调用模拟软件,甚至与自动化实验室协同工作。但要让它们独立完成一项完整的材料研究,仍然面临挑战:
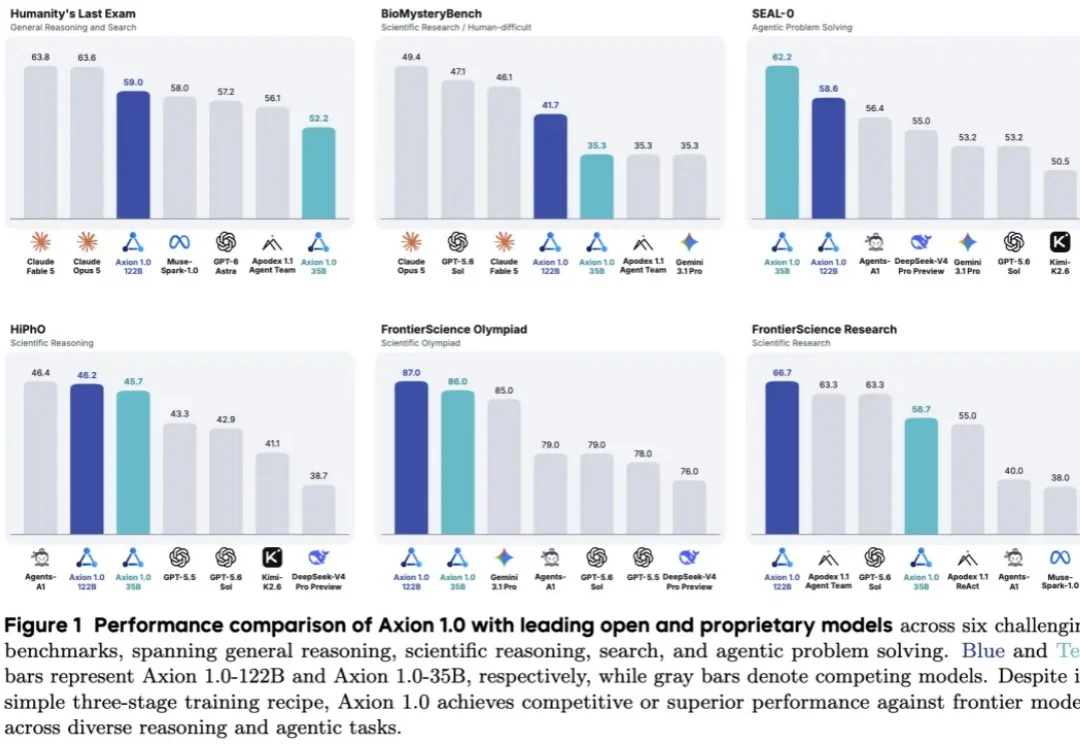
能搜索资料、运行代码,还能完成多步科学研究任务——训练这样的智能体,究竟需要多少道工序?