AI资讯新闻榜单内容搜索-LLM

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: LLM
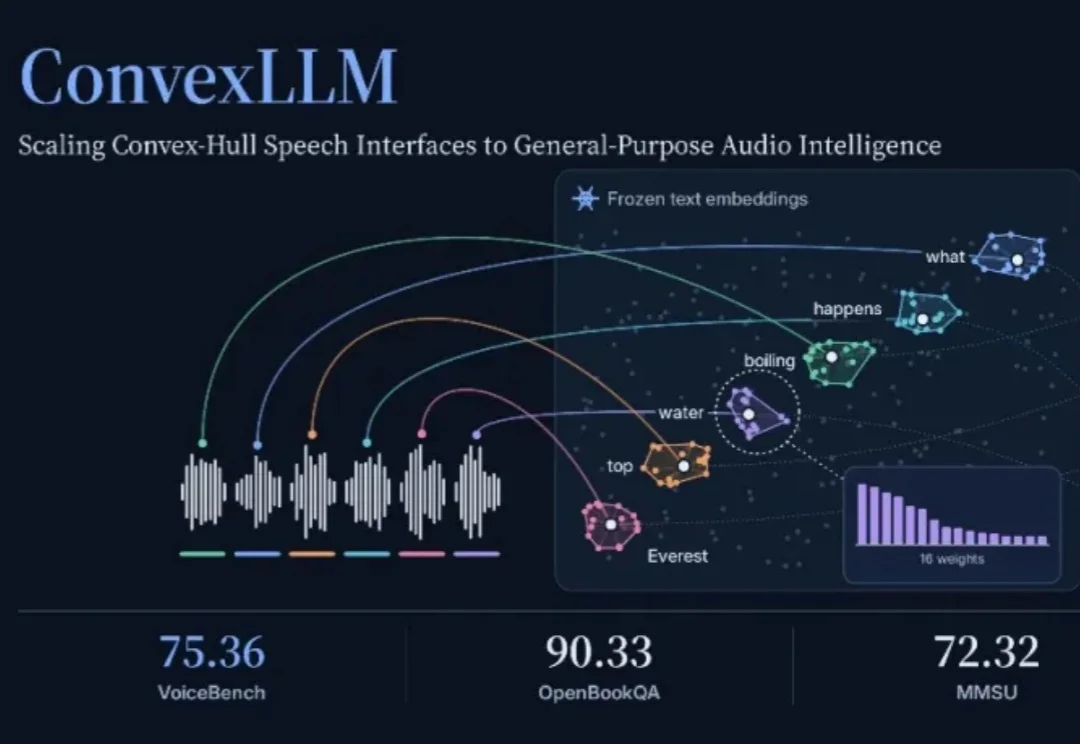
港中深联合微软研究院提出多模态统一建模新架构ConvexLLM,让声音接上大模型已经学会的知识与推理

港中深联合微软研究院提出多模态统一建模新架构ConvexLLM,让声音接上大模型已经学会的知识与推理

港中深联合微软研究院提出多模态统一建模新架构ConvexLLM,让声音接上大模型已经学会的知识与推理

此次提出的 ConvexLLM,通过创新的 C-Gate 架构,将语音信息映射至大语言模型原有文本词向量的凸包中,使模型能够充分发挥已有的知识储备与推理能力。在 VoiceBench 等多项基准测试中,ConvexLLM 取得了同量级开源模型中的领先表现,为语音与语言的统一建模提供了新的技术路径。

来自主题: AI技术研报
7506 点击    2026-11-19 08:36
NeurIPS 2026|不再依赖外挂:清华把「自我进化技能」训进Agent大脑

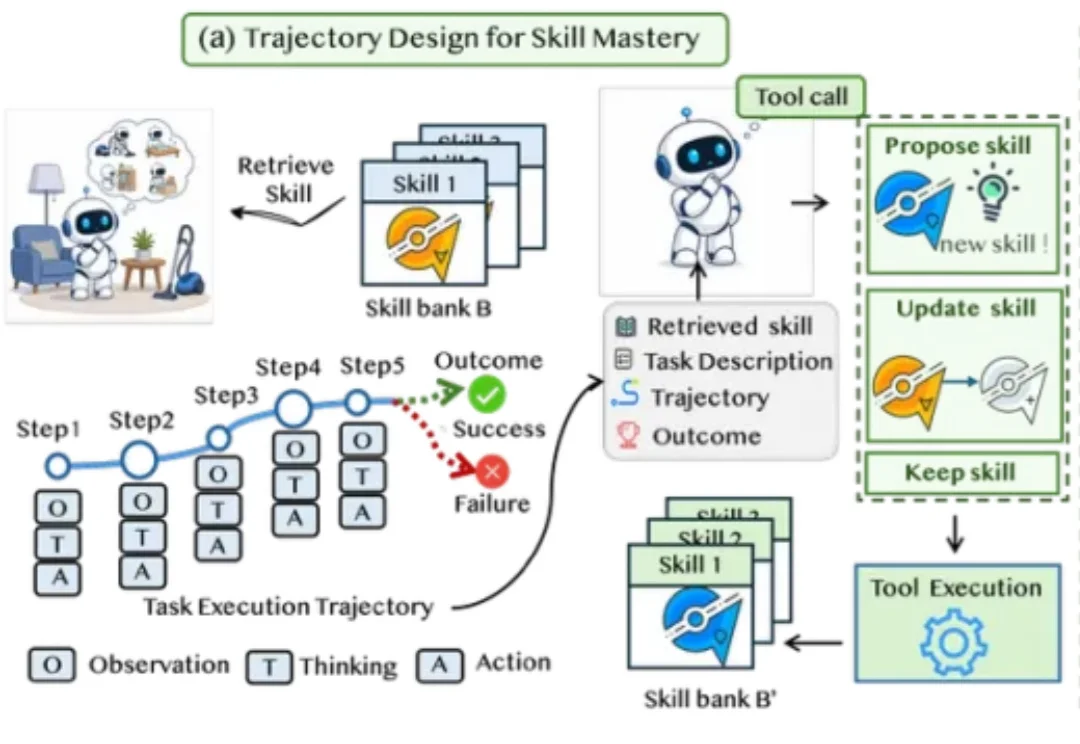
NeurIPS 2026|不再依赖外挂:清华把「自我进化技能」训进Agent大脑

NeurIPS 2026|不再依赖外挂:清华把「自我进化技能」训进Agent大脑

随着递归自我改进(Recursive Self-Improvement,RSI)研究的兴起,智能体的长期能力演进受到更多关注。技能(Skill)能够将交互经验提炼为可复用的操作流程与任务策略,使一次任务的收获服务于后续任务。让智能体学会自主创建和改进这些技能,为其持续进化提供了一条具体路径。

来自主题: AI技术研报
8894 点击    2026-11-16 15:13
Agent如何越用越强?中科院自动化所、美团等推出RSI综述

Agent如何越用越强?中科院自动化所、美团等推出RSI综述

Agent如何越用越强?中科院自动化所、美团等推出RSI综述

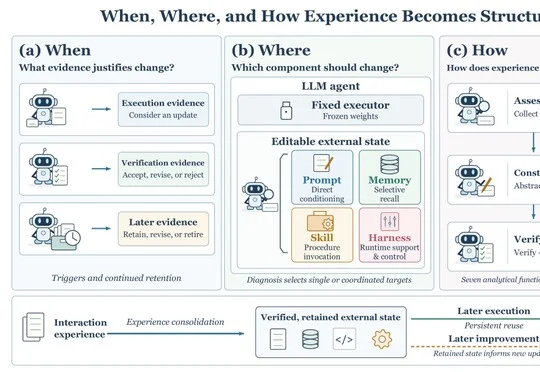
中国科学院自动化研究所、美团等机构推出LLM Agent递归自我改进综述,以Prompt、Memory、Skill和Harness四条主线及When、Where、How三问、七步生命周期,梳理Agent将交互经验转化为可验证、复用且持续维护的改进机制。

来自主题: AI技术研报
8902 点击    2026-11-15 11:28
为Agent全生命周期量身定制!海光掏出全家桶方案,打通Agent落地每一层

为Agent全生命周期量身定制!海光掏出全家桶方案,打通Agent落地每一层

为Agent全生命周期量身定制!海光掏出全家桶方案,打通Agent落地每一层

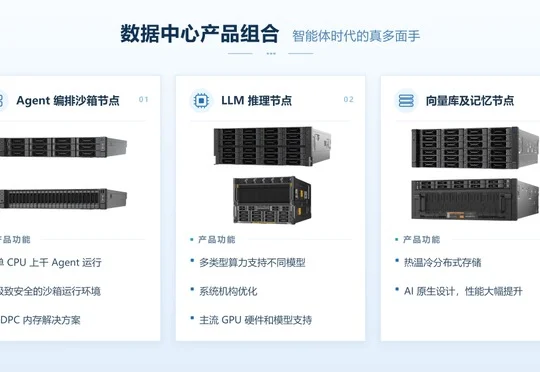
海光布局Agentic时代算力基础设施,以国产CPU和DCU为底座,提供模块化数据中心产品方案及AgentServer Flex智能体算力矩阵,通过编排沙箱、LLM推理、向量库及记忆节点适配智能体全生命周期需求。

来自主题: AI资讯
6016 点击    2026-11-14 12:45
从数学理论「解」出语言模型——AGI理论核心原语的首次工程验证:BriLLM-MetaPred

从数学理论「解」出语言模型——AGI理论核心原语的首次工程验证:BriLLM-MetaPred

从数学理论「解」出语言模型——AGI理论核心原语的首次工程验证:BriLLM-MetaPred

上海交通大学赵海教授团队在arXiv发布BriLLM-MetaPred,首次将AGI数学理论推导的MetaPred原语落地为可运行语言模型,其在约13.2M参数规模下的预测性能与同规模GPT基线相当。

来自主题: AI技术研报
8777 点击    2026-11-13 17:08
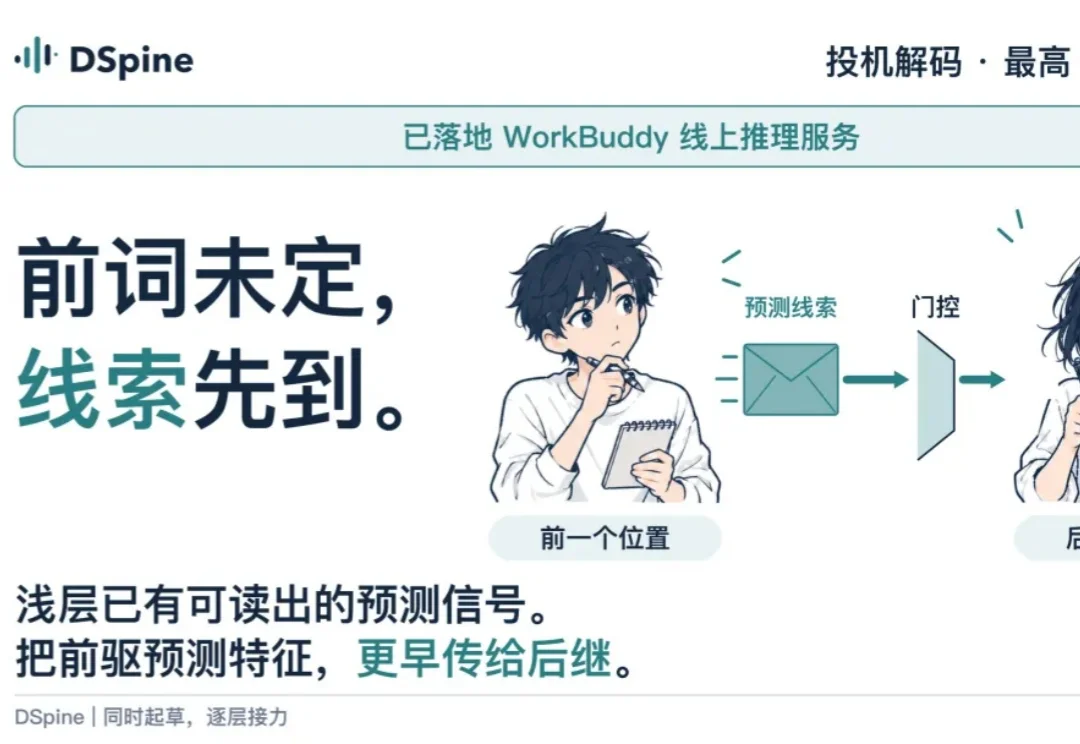
并行推测解码SOTA!因果依赖刻进草稿网络深度,SGLang吞吐最高达4倍,已开源

并行推测解码SOTA!因果依赖刻进草稿网络深度,SGLang吞吐最高达4倍,已开源

并行推测解码SOTA!因果依赖刻进草稿网络深度,SGLang吞吐最高达4倍,已开源

在大型语言模型(LLM)的无损推理加速中,推测解码(Speculative Decoding)已成为工业界标配。以 EAGLE-3 为代表的自回归草稿模型虽然预测准,但每多猜一个 token 就要多跑一步串行前向;而受扩散语言模型启发的 DFlash 将草稿生成彻底并行化 —— 一次骨干网络前向即可同时吐出整块候选 token,大幅压缩了起草耗时。

来自主题: AI技术研报
6905 点击    2026-11-10 09:23
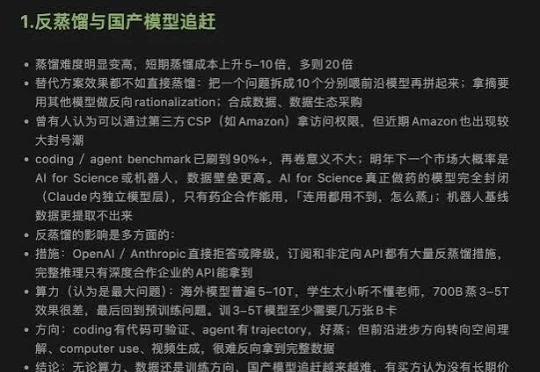
中国LLM讨论纪要

中国LLM讨论纪要

中国LLM讨论纪要

中国LLM讨论纪要认为,反蒸馏措施正令国产模型蒸馏成本上升5—10倍甚至20倍,算力与融资成为竞争核心,中美模型差距或由3—4个月拉长至约12个月。

来自主题: AI资讯
11612 点击    2026-11-06 15:53
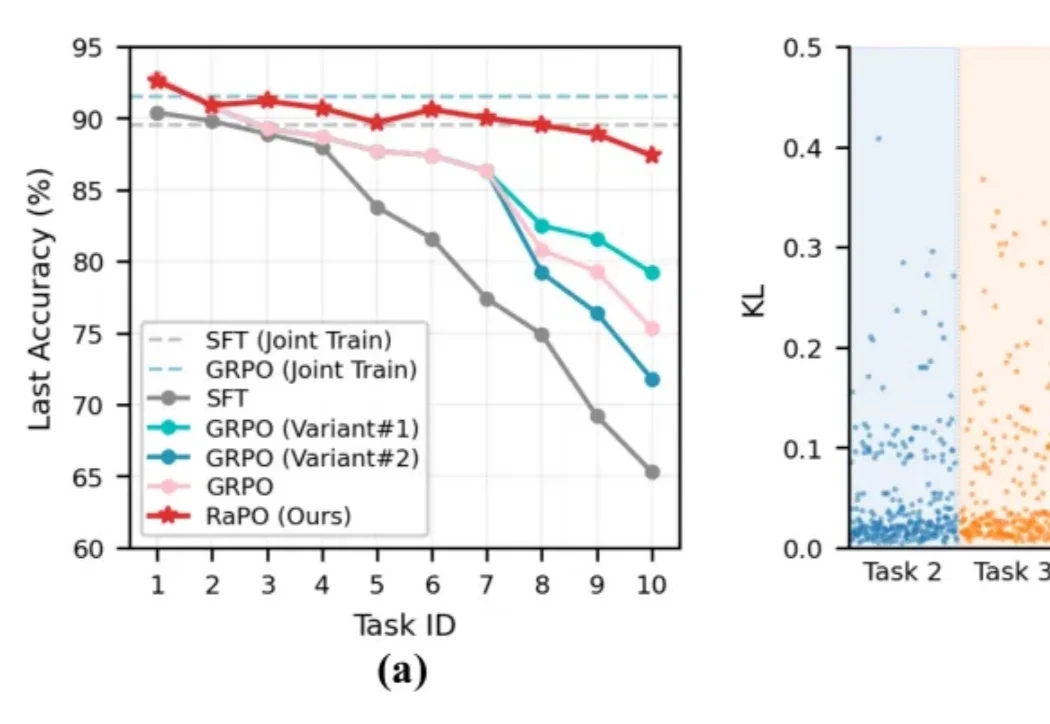
NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源

NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源

NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源

在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。

来自主题: AI技术研报
9065 点击    2026-11-05 17:01
独家|周畅从字节Seed离职,背后是多模态统一路线之争

独家|周畅从字节Seed离职,背后是多模态统一路线之争

独家|周畅从字节Seed离职,背后是多模态统一路线之争

据Z Finance报道,周畅已离开字节Seed、转向Physical AI创业并获头部美元基金投资,但接近字节的人士否认离职;Seed将VLM并入LLM体系,折射出多模态统一路线调整。

来自主题: AI资讯
8755 点击    2026-11-05 15:46