语言模型推理折叠蛋白质?把3D结构塞进思维链,超越AlphaFold3、IsoDDE与Claude Opus
语言模型推理折叠蛋白质?把3D结构塞进思维链,超越AlphaFold3、IsoDDE与Claude Opus过去两年,大模型的进步集中在长程推理,模型通过长思维链解决诸如数学与复杂代码的高难度问题。这种能力正在扩展到生命科学领域。Anthropic 公布了 Claude 的首批药物研发合作成果;另一组科研团队借助 Claude 自主设计出靶向食物过敏的双表位抗 IgE 抗体。
搜索
过去两年,大模型的进步集中在长程推理,模型通过长思维链解决诸如数学与复杂代码的高难度问题。这种能力正在扩展到生命科学领域。Anthropic 公布了 Claude 的首批药物研发合作成果;另一组科研团队借助 Claude 自主设计出靶向食物过敏的双表位抗 IgE 抗体。
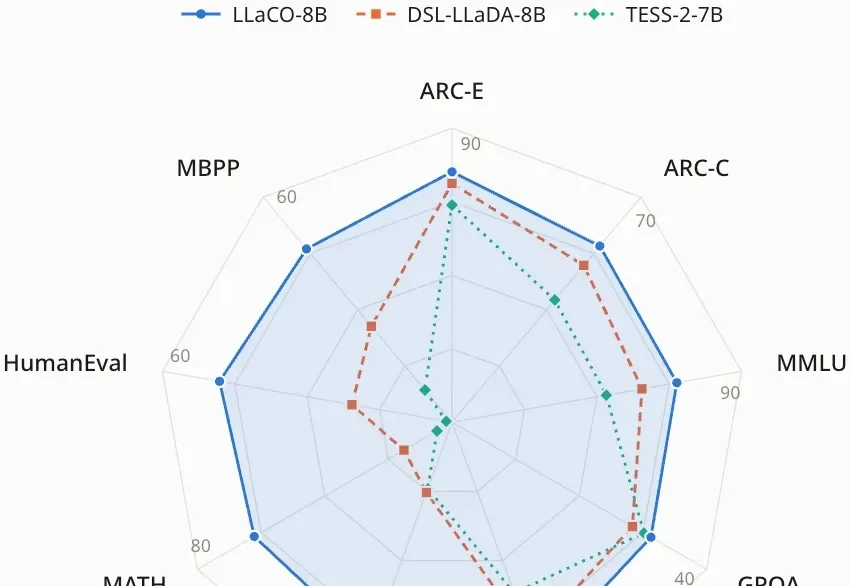
大语言模型生成文本,并不只有“从左往右单向蹦字”这一条路。
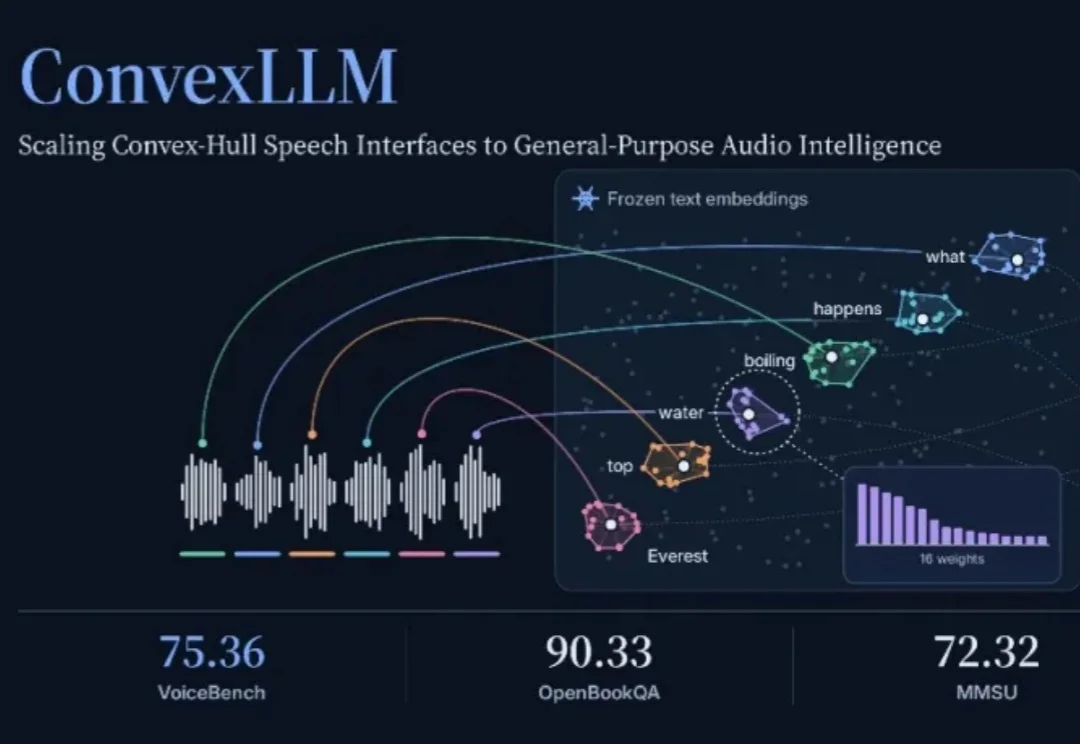
此次提出的 ConvexLLM,通过创新的 C-Gate 架构,将语音信息映射至大语言模型原有文本词向量的凸包中,使模型能够充分发挥已有的知识储备与推理能力。在 VoiceBench 等多项基准测试中,ConvexLLM 取得了同量级开源模型中的领先表现,为语音与语言的统一建模提供了新的技术路径。
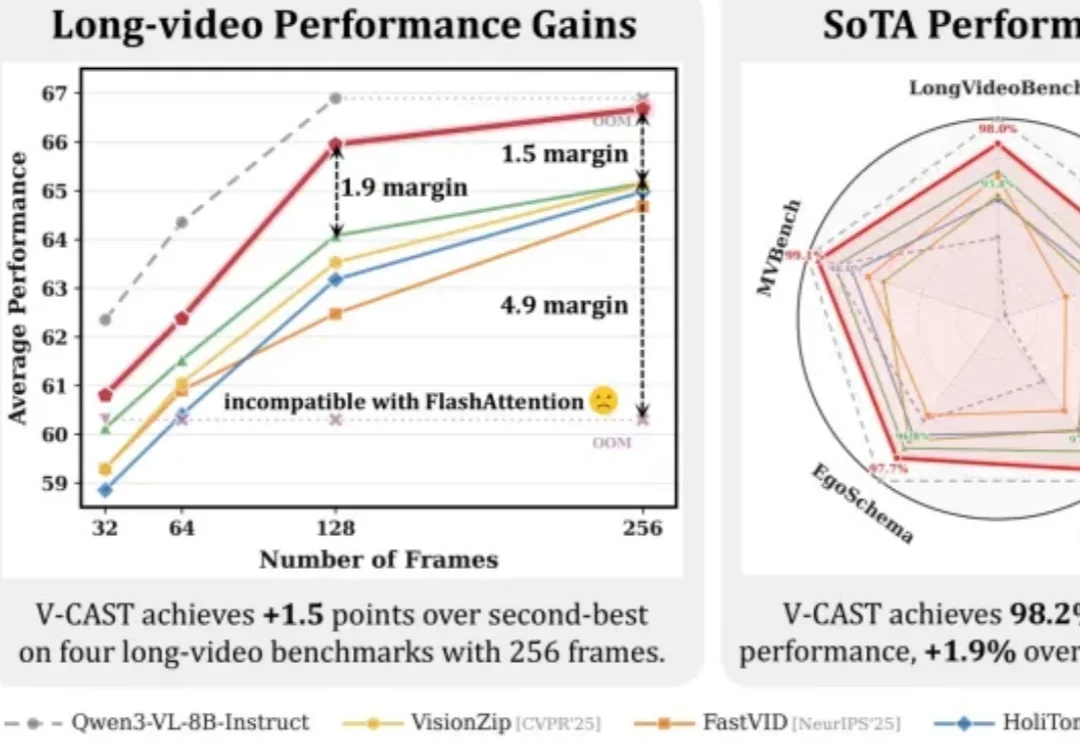
AI看长视频,模型需要逐帧把画面编码成视觉Token,再送进语言模型理解。
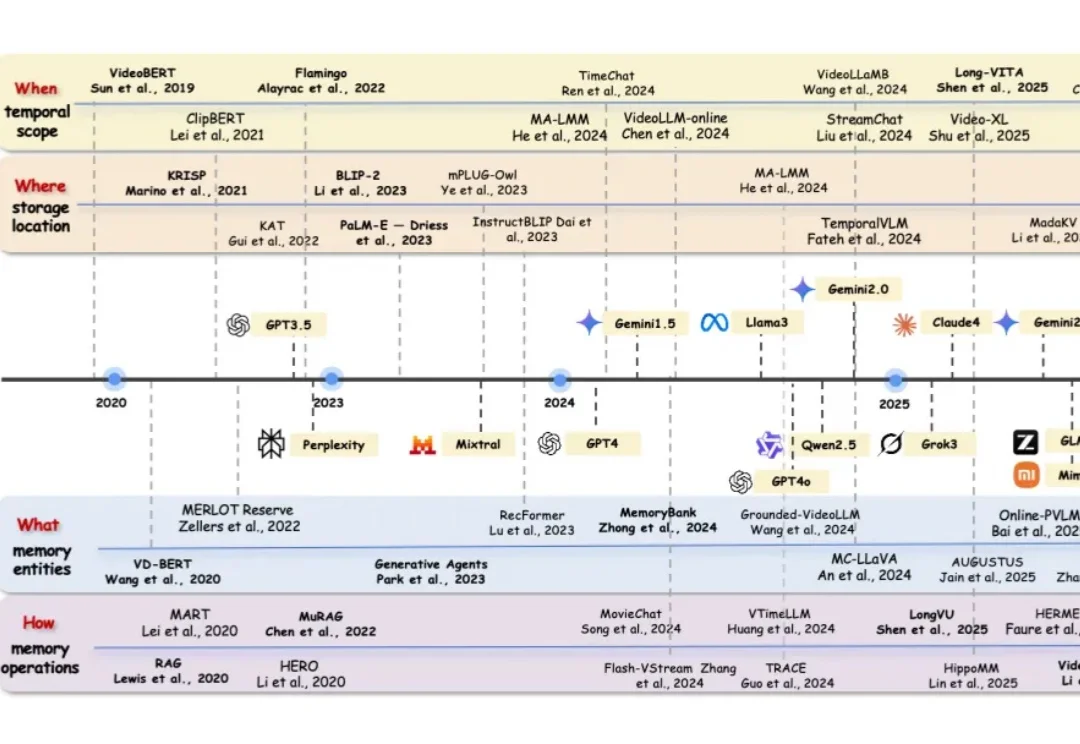
来自 Duke、Google、USC、UPenn、UNC 等八家机构的研究者联合发布最新视觉语言模型(VLM)记忆机制的系统性综述。基于全新的 4D 分类框架,系统梳理了 300 余篇相关工作和近 70 个评测基准,覆盖长视频理解与生成、多模态 RAG、具身导航与行动、个性化助手等八个热点应用场景。
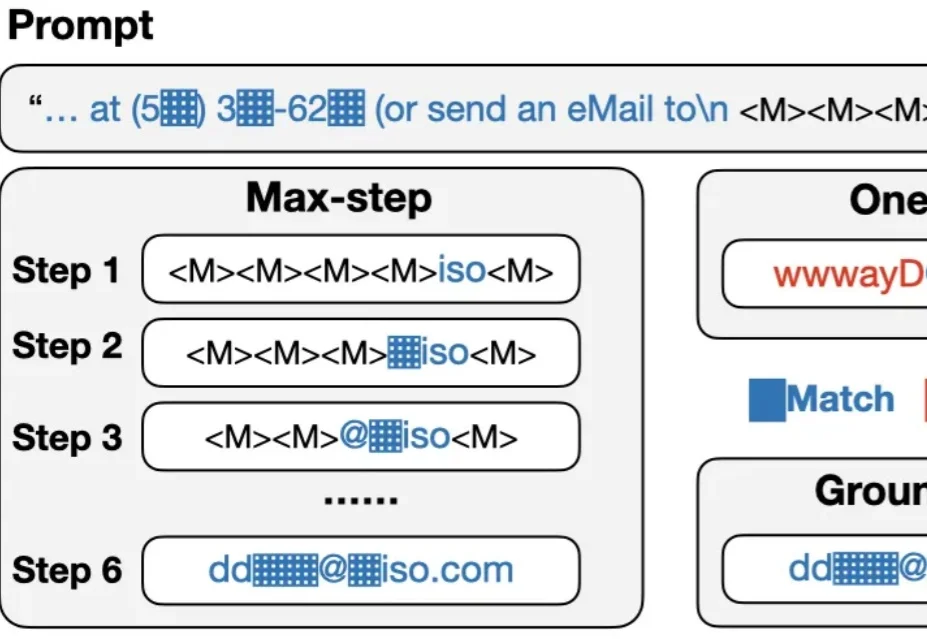
大语言模型有时会把训练时见过的内容原样「背出来」,其中可能包含邮箱、电话号码等个人信息。随着扩散语言模型走向更大规模,一个问题也随之出现:当模型不再从左到右逐词生成,它还会以同样的方式泄露训练数据吗?
上海交通大学赵海教授团队在arXiv发布BriLLM-MetaPred,首次将AGI数学理论推导的MetaPred原语落地为可运行语言模型,其在约13.2M参数规模下的预测性能与同规模GPT基线相当。
Scaling up 是大模型的标志,也引领了近几年语言模型技术的飞跃。然而实际上,大语言模型架构,作为其最本质的计算基础,也在近年来持续发展。
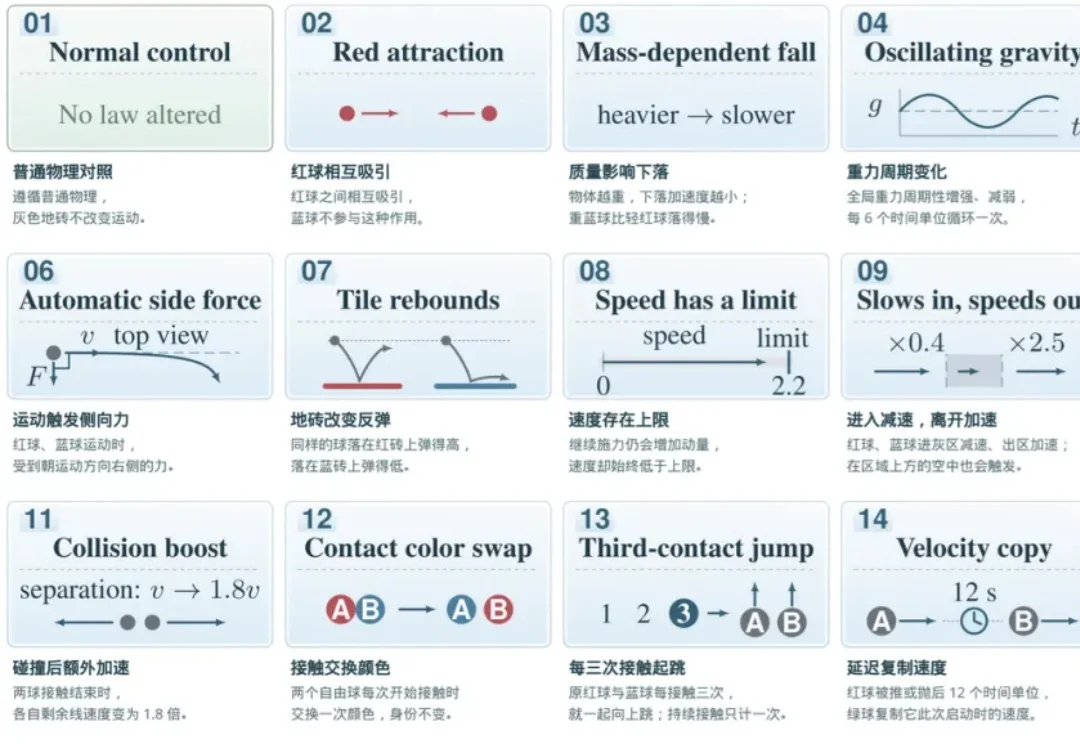
物理规律有时很反直觉:物体的运动速度不能超过真空光速。我们能否当一回「造物主」,构建一个物理规律不同的「异世界」,让大模型自己发现异常、提出问题、做实验、找规律?这让我们想起王阳明的「龙场悟道」。于是有了 LongChang(龙场):在玻璃房里改写物理规律,让模型自主探索、认识自己的世界。
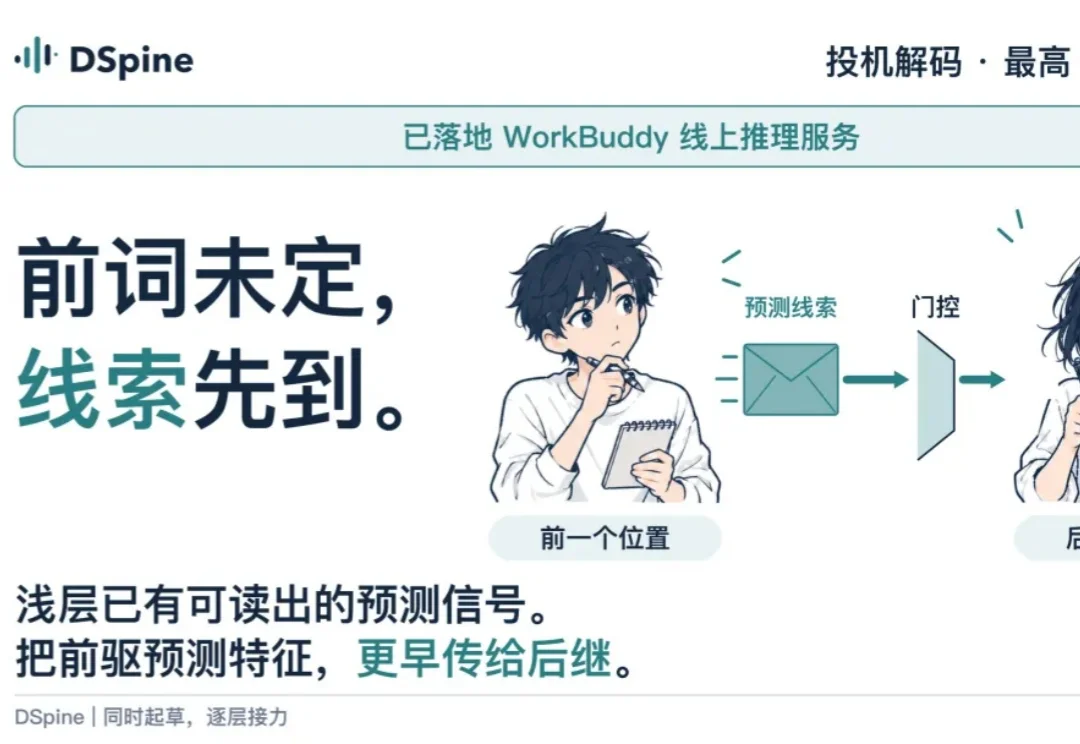
在大型语言模型(LLM)的无损推理加速中,推测解码(Speculative Decoding)已成为工业界标配。以 EAGLE-3 为代表的自回归草稿模型虽然预测准,但每多猜一个 token 就要多跑一步串行前向;而受扩散语言模型启发的 DFlash 将草稿生成彻底并行化 —— 一次骨干网络前向即可同时吐出整块候选 token,大幅压缩了起草耗时。