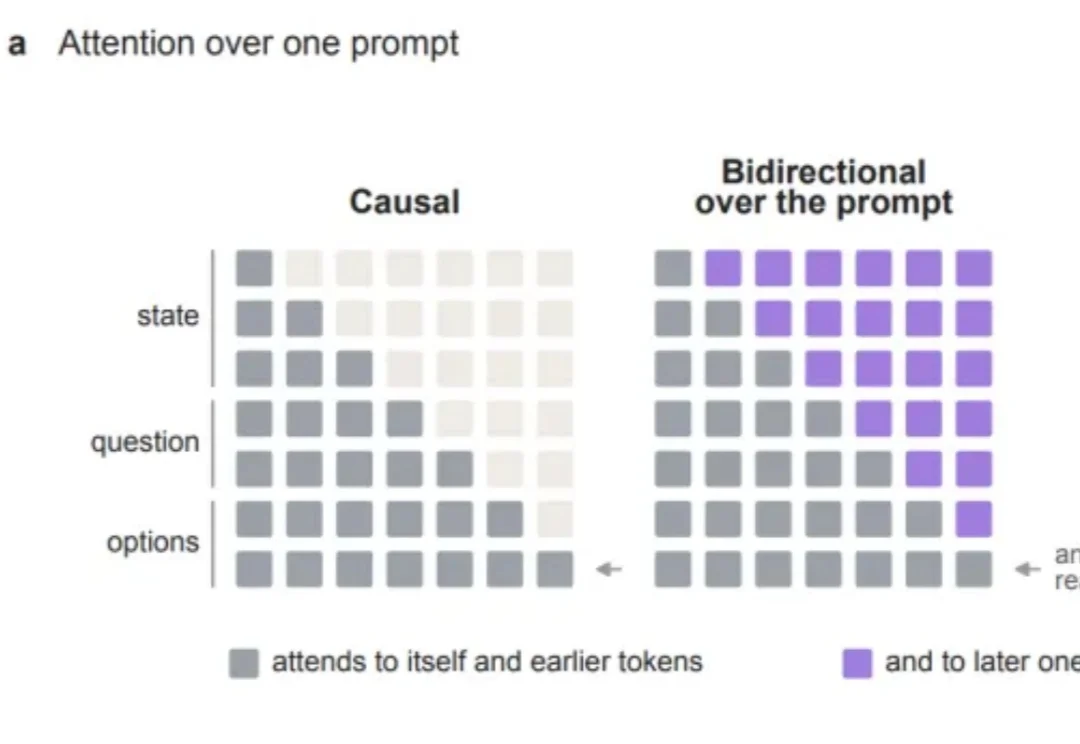
决策模型何时需要思考?StartLux-Decision的按需推理与概率校准
决策模型何时需要思考?StartLux-Decision的按需推理与概率校准经过决策训练的语言模型,重新打开生成开关后,未必还能稳定地推理。在研究者的实验中,4B 模型在约 40% 的问题上几乎不生成推理;9B 模型则走向另一端,在约 70% 的问题上持续生成,直到触及长度上限。
来自主题: AI技术研报
6660 点击 2026-11-05 10:19

 搜索
经过决策训练的语言模型,重新打开生成开关后,未必还能稳定地推理。在研究者的实验中,4B 模型在约 40% 的问题上几乎不生成推理;9B 模型则走向另一端,在约 70% 的问题上持续生成,直到触及长度上限。
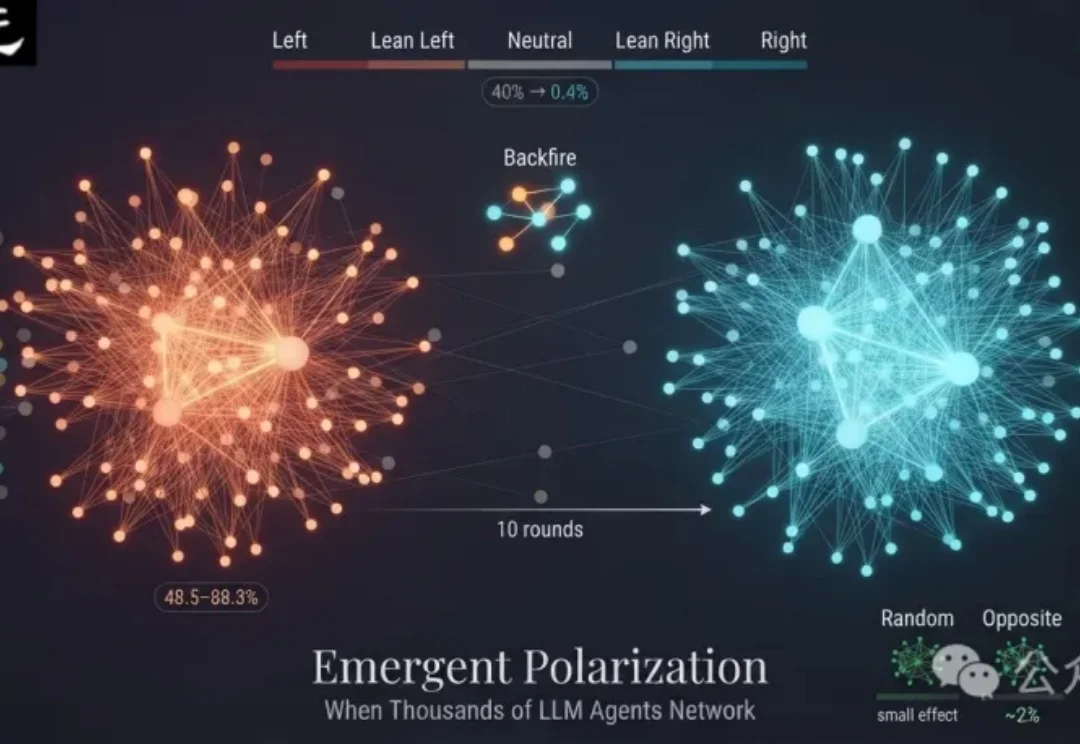
当数千个大语言模型智能体被连入同一个网络、彼此可以自由交流并不断更新观点时,会发生什么?
编辑|张倩 2008 年,英伟达曾用一场颇为疯狂的实验,向人们展示并行计算的威力。 在现场,一台绘画机器人按部就班、一个像素接一个像素地绘制出一幅「笑脸」简笔画。 但接下来,画风突变。工作人员启动了一
国内大语言模型炒作的重点已经聚焦于3D生成领域,凡更新必展示结合Three.js炮制的4A大作。
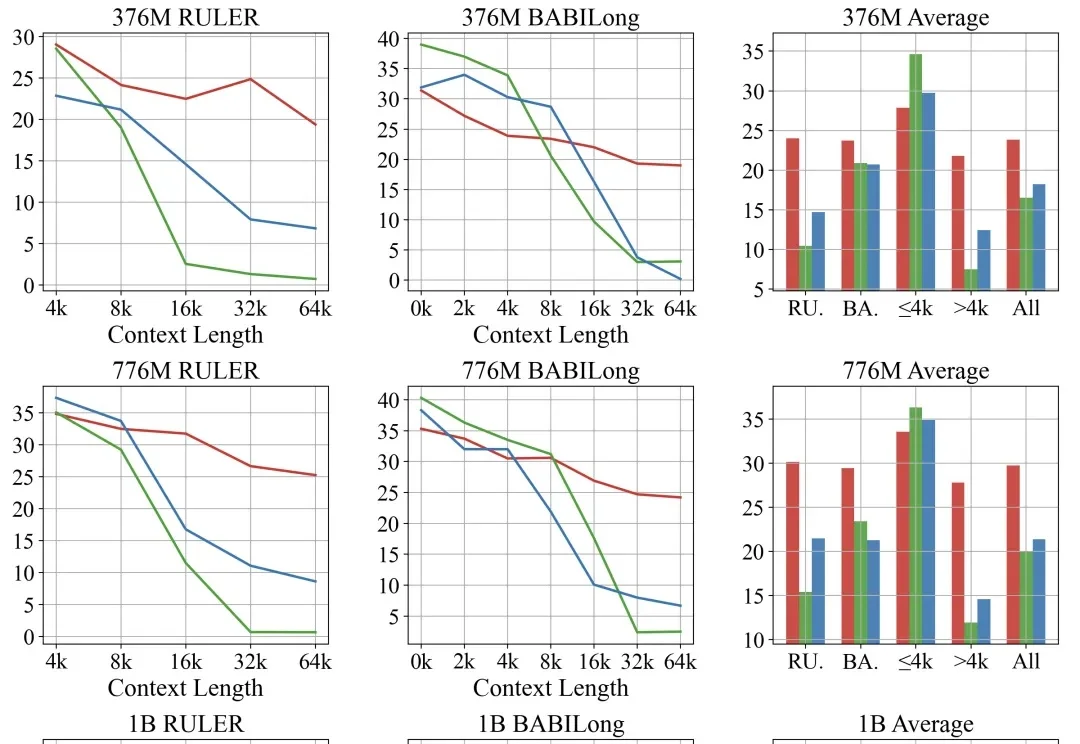
长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。
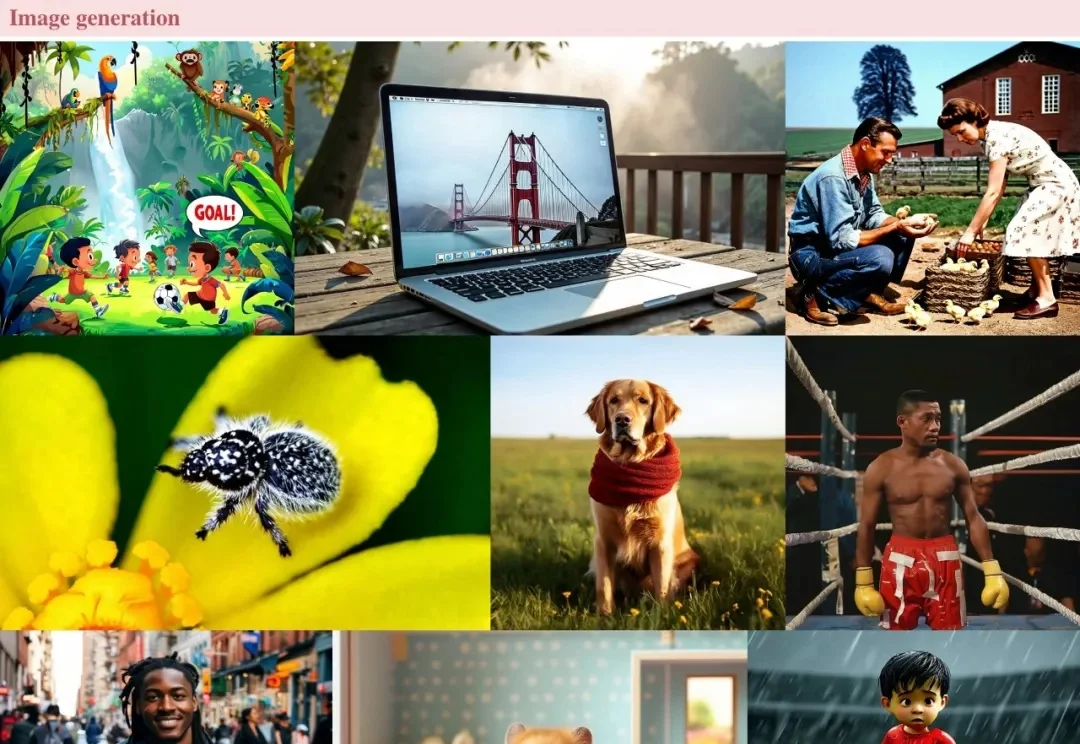
统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。
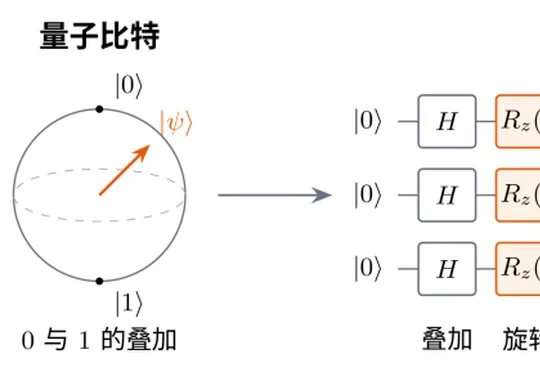
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
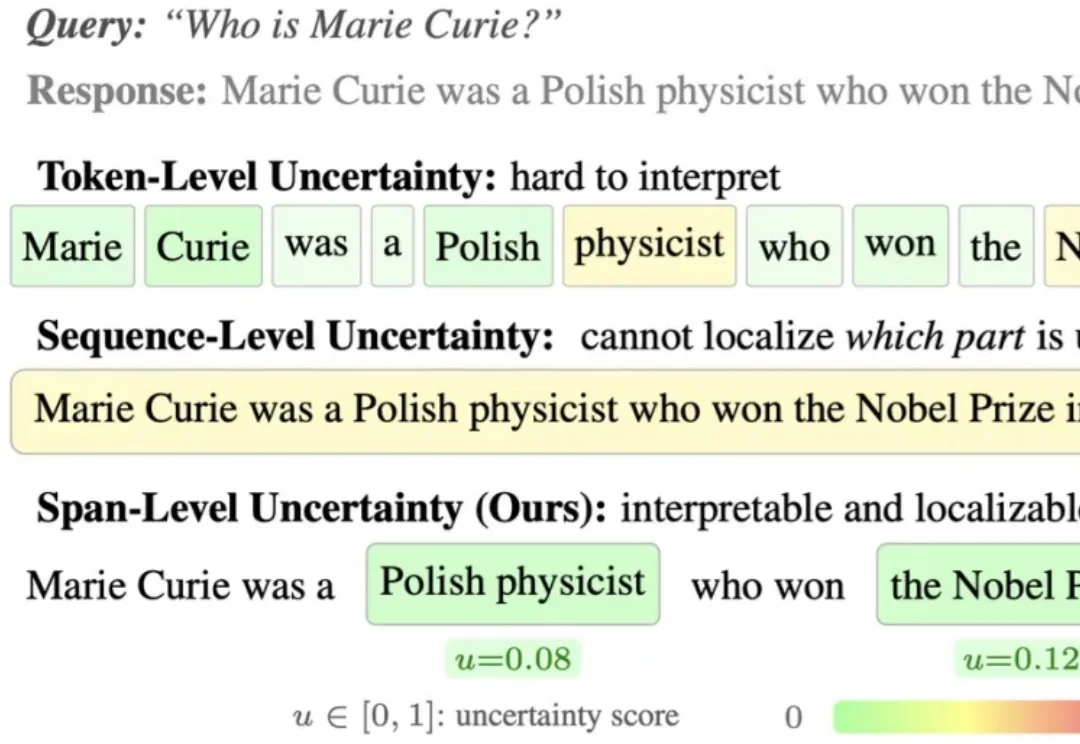
在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?
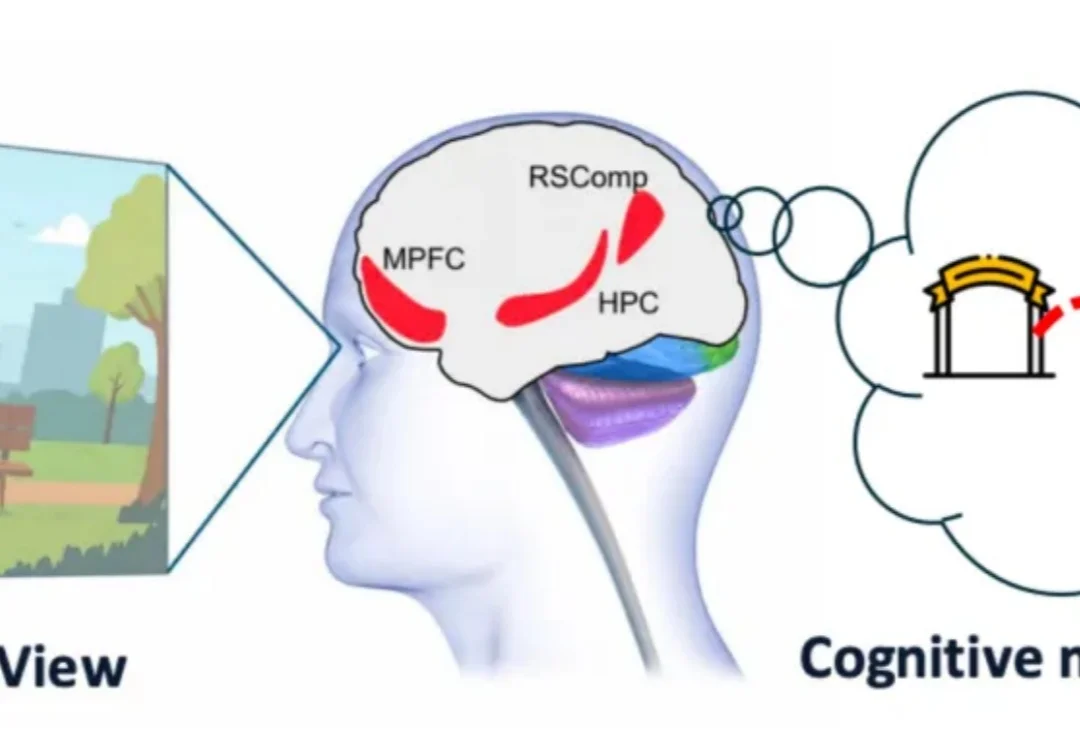
看一段房间视频,视觉语言模型(VLM)能够认出桌子、椅子和柜子。但在它的内部,这些物体是按颜色、形状组织在一起,还是形成了一张包含邻接关系的空间地图?
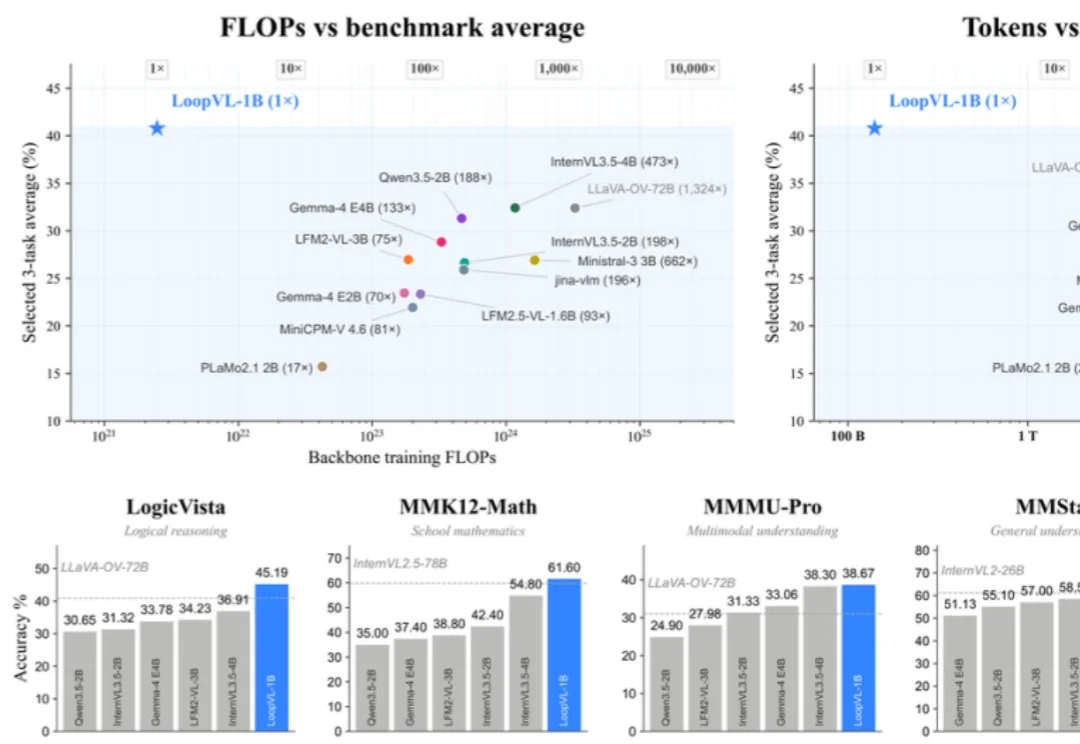
近年来,Loop Transformer 逐渐从简单的模块复用走向更复杂的分层循环计算,探索如何通过共享参数持续更新模型状态。一个自然的问题是:当模型开始看图,这套机制还成立吗?