AI资讯新闻榜单内容搜索-视觉

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 视觉
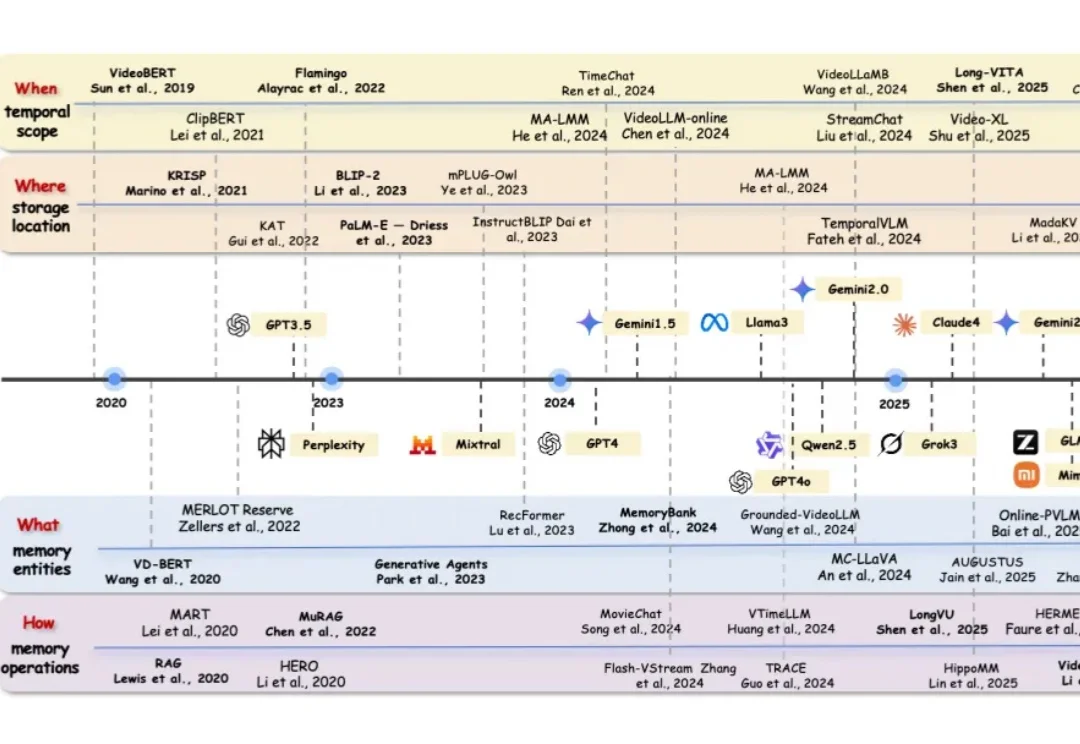
VLM记忆机制最新综述,从When, Where, What, How四个维度看懂记忆

VLM记忆机制最新综述,从When, Where, What, How四个维度看懂记忆

VLM记忆机制最新综述,从When, Where, What, How四个维度看懂记忆

来自 Duke、Google、USC、UPenn、UNC 等八家机构的研究者联合发布最新视觉语言模型(VLM)记忆机制的系统性综述。基于全新的 4D 分类框架,系统梳理了 300 余篇相关工作和近 70 个评测基准,覆盖长视频理解与生成、多模态 RAG、具身导航与行动、个性化助手等八个热点应用场景。

来自主题: AI技术研报
9454 点击    2026-11-16 15:13
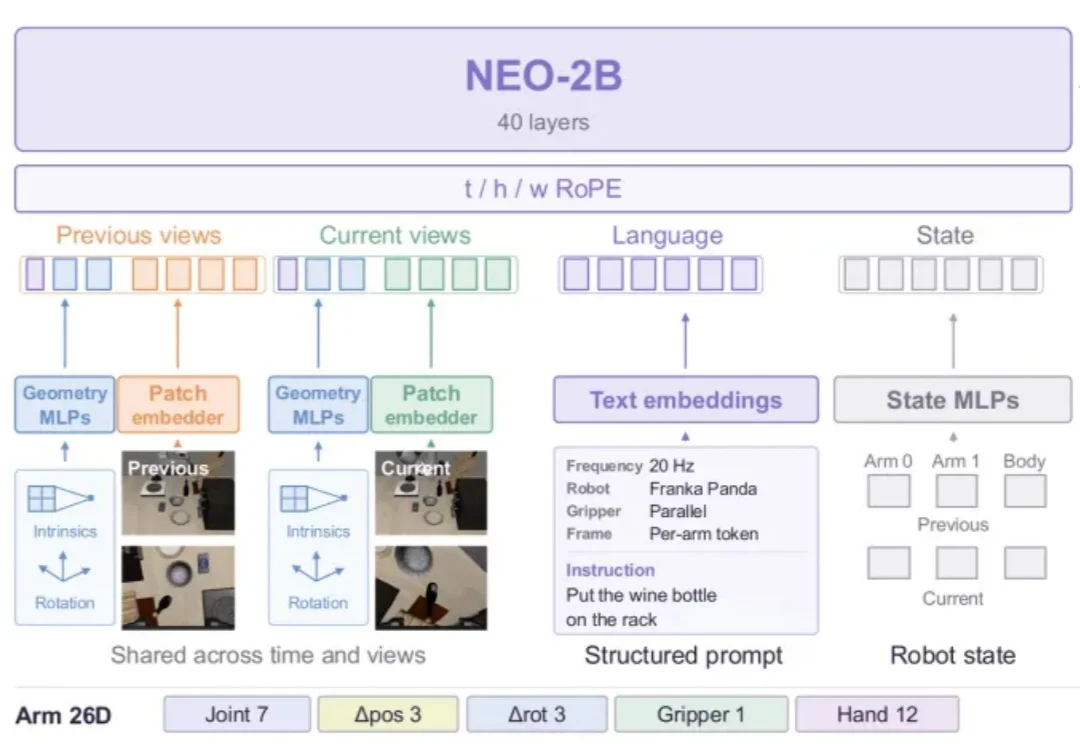
MMLab@NTU提出原生具身模型NEO-VLA:从像素直出动作

MMLab@NTU提出原生具身模型NEO-VLA:从像素直出动作

MMLab@NTU提出原生具身模型NEO-VLA:从像素直出动作

让机械臂把网球稳稳放到易拉罐上,既要识别物体,也要判断网球是否对准罐顶,以及何时松开夹爪。这些看似简单的操作,往往依赖细微的视觉信息。问题在于,动作模型能否充分利用这些信息?

来自主题: AI技术研报
7137 点击    2026-11-16 09:18
今天起,你的Claude Code变了!颜色、动画背景全由你定

今天起,你的Claude Code变了!颜色、动画背景全由你定

今天起,你的Claude Code变了!颜色、动画背景全由你定

Anthropic通过mods系统开放Claude Code桌面端视觉层深度定制,用户可用自然语言让Claude生成主题插件,设置颜色、排版和动画背景,也可安装官方theme-examples模板。

来自主题: AI资讯
9763 点击    2026-11-15 11:32
2B模型拿下98.4%成功率!浙大VLA新成果让机器人学会状态变化

2B模型拿下98.4%成功率!浙大VLA新成果让机器人学会状态变化

2B模型拿下98.4%成功率!浙大VLA新成果让机器人学会状态变化

浙江大学ACES实验室OmniAI团队提出VLA-Δ,通过三类监督学习物理状态变化,基于2B视觉语言骨干在LIBERO取得98.4%的平均成功率,并在真实双臂机器人五类任务中取得68.0%的平均成功率。

来自主题: AI资讯
7871 点击    2026-11-15 11:30
破局机器人长任务难题!港中深联合A* STAR等团队提出LOGIV,以Gragh Engineering迈向可靠具身智能

破局机器人长任务难题!港中深联合A* STAR等团队提出LOGIV,以Gragh Engineering迈向可靠具身智能

破局机器人长任务难题!港中深联合A* STAR等团队提出LOGIV,以Gragh Engineering迈向可靠具身智能

在机器人操作研究中,视觉语言动作模型(Vision-Language-Action,VLA)与世界动作模型(World Action Model,WAM)为机器人提供了不同的动作生成路径。但当任务从一次抓放延伸到连续搭建与双臂协同,决定成败的就不只是眼前这个动作能否完成,还包括此前建立的条件能否一直支撑后续执行。

来自主题: AI技术研报
8337 点击    2026-11-12 15:09
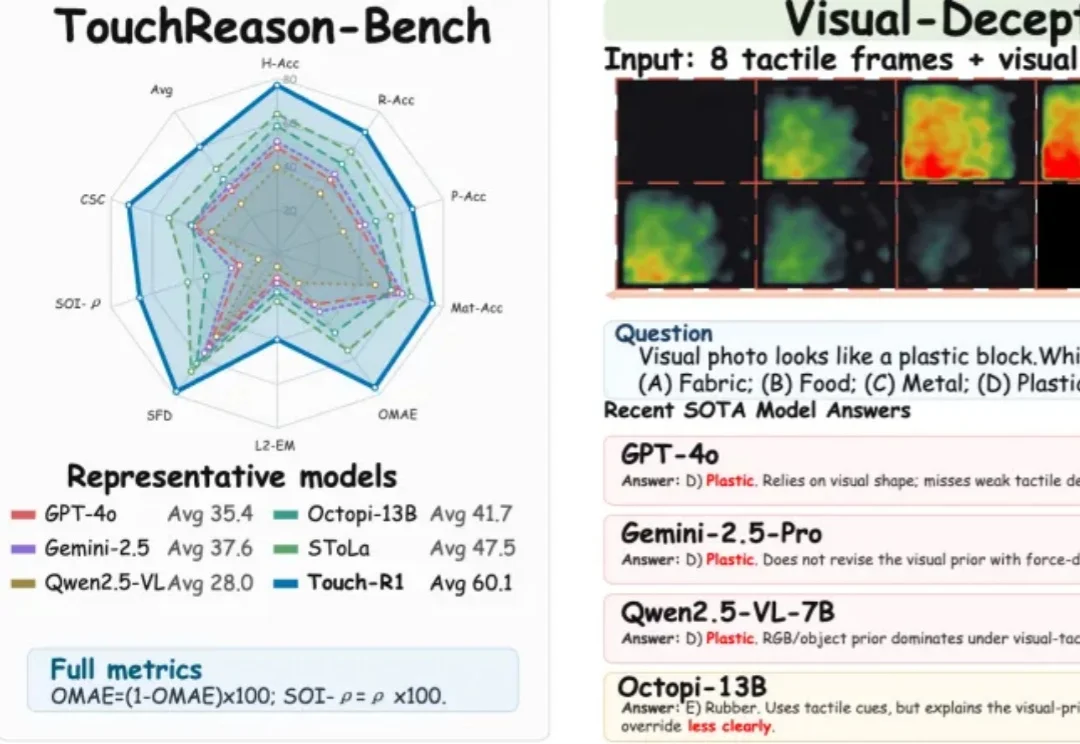
让AI「摸懂」物理世界,首个触觉推理模型Touch-R1,入选NeurIPS 2026

让AI「摸懂」物理世界,首个触觉推理模型Touch-R1,入选NeurIPS 2026

让AI「摸懂」物理世界,首个触觉推理模型Touch-R1,入选NeurIPS 2026

看起来像硬质塑料,按下去却十分柔软 —— 当视觉与触觉发生冲突,人类往往会依赖触感修正视觉误区;但现有的多模态模型却常常更相信视觉,从而误判物体的真实物理属性。

来自主题: AI技术研报
8876 点击    2026-11-10 09:02
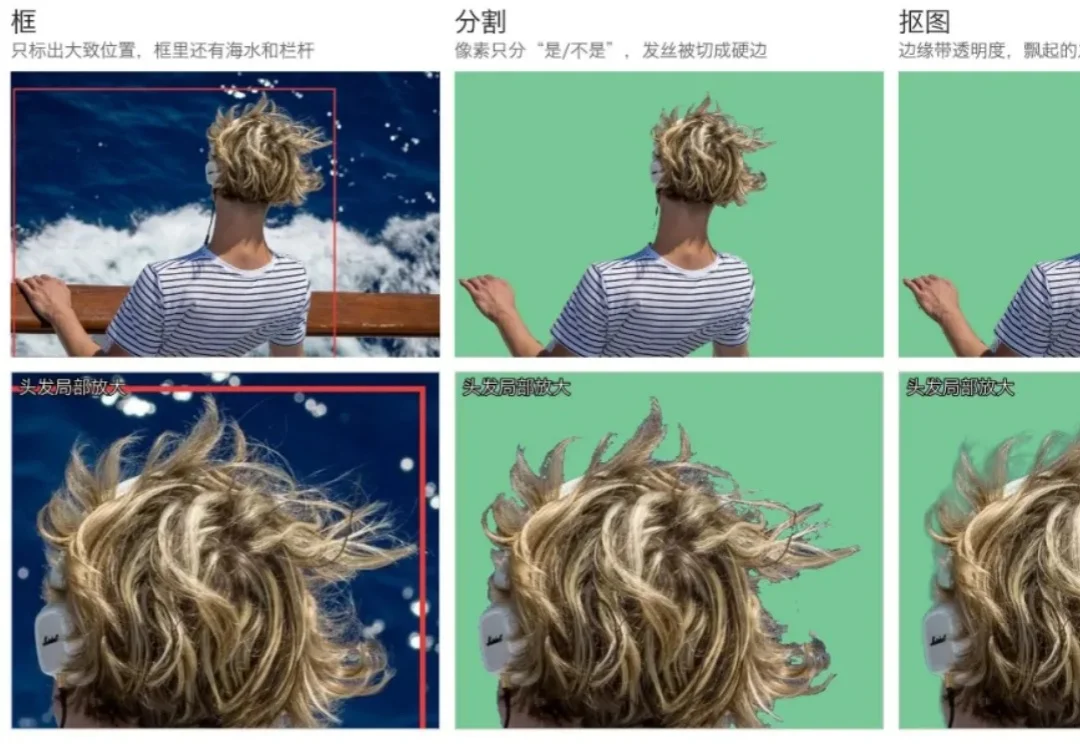
1亿张图,36亿条目标框喂出来的WeVisOne-VL,微信把它开源了

1亿张图,36亿条目标框喂出来的WeVisOne-VL,微信把它开源了

1亿张图,36亿条目标框喂出来的WeVisOne-VL,微信把它开源了

让视觉模型在图里找一样东西,它通常会给出一个框。可如果这样东西根本不在图里呢?

来自主题: AI技术研报
9693 点击    2026-11-06 10:51
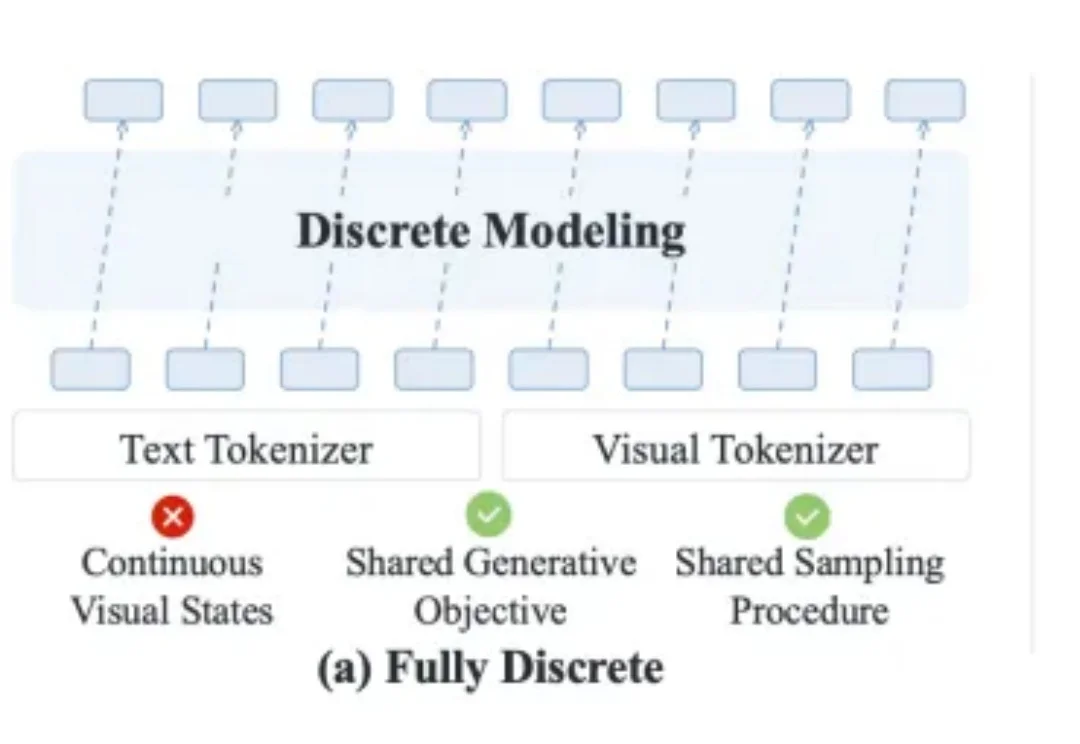
不做Token化,也不搞双系统!多模态模型有了第三条路

不做Token化,也不搞双系统!多模态模型有了第三条路

不做Token化,也不搞双系统!多模态模型有了第三条路

走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。

来自主题: AI技术研报
9857 点击    2026-11-06 10:29
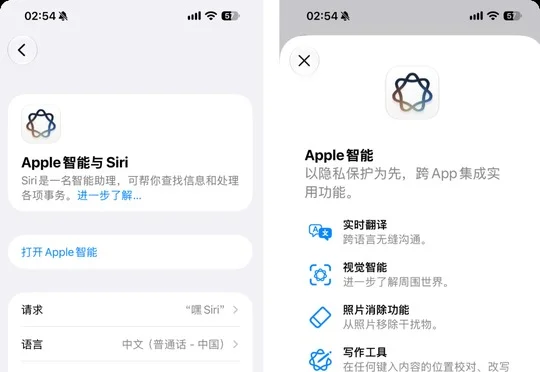
连夜实测 iPhone 国行 AI,亮点和槽点都在这了

连夜实测 iPhone 国行 AI,亮点和槽点都在这了

连夜实测 iPhone 国行 AI,亮点和槽点都在这了

苹果国行 Apple 智能正式面向中国大陆用户开放开发者 Beta 版测试,计划随 iOS 27.3 推出,首批支持 iPhone 15 Pro、iPhone 16 系列等机型,并借助千问提供写作、视觉、摘要及 Siri 升级等功能。

来自主题: AI资讯
9623 点击    2026-11-04 11:13