NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构
NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。
搜索
STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。
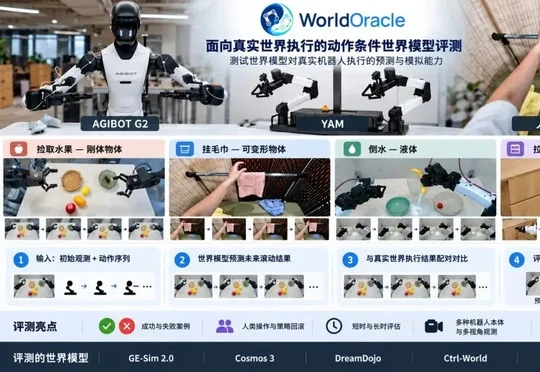
普林斯顿大学、得克萨斯大学奥斯汀分校、多伦多大学、NVIDIA和智元研究人员提出WorldOracle,并于10月16日开放评测平台;七种模型的真实执行对照显示,其机械臂轨迹较准但物体运动易偏离,长序列预测表现也会明显退化。
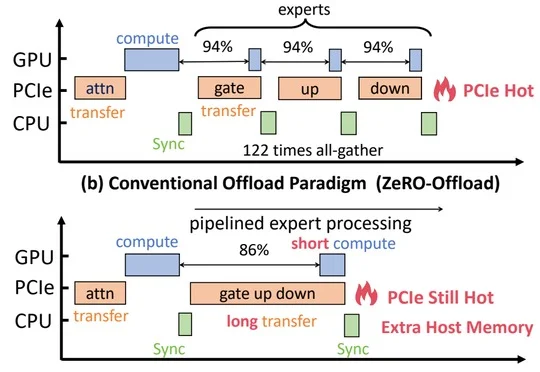
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
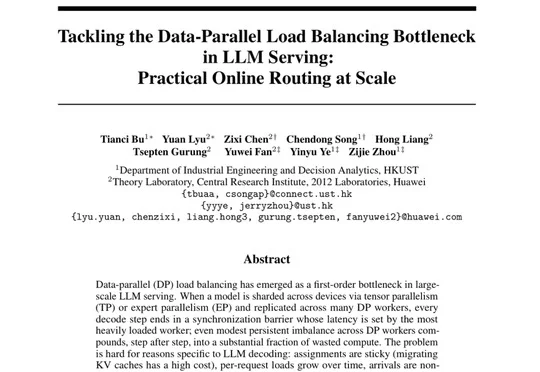
香港科技大学周子杰团队与华为 2012 实验室理论部提出 BalanceRoute,通过建模与短期负载预测减少 MoE 模型解码的跨组同步等待,其已部署于 MathBot-Pie,并在 96 张昇腾 910C NPU 实验中使解码吞吐提升约 15%。
两年前因在字节跳动实习期间恶意篡改代码、干扰模型训练任务而被辞退,随后遭字节起诉索赔800万元的田柯宇,已经带着一家世界模型实验室重回牌桌。团队只有约 10 个人,没有公开公司名字,没有推出产品 demo ,完整模型预计要到 2027 年才发布,但已经融到近 3000 万美元,投后估值 2 亿美元。
如今的大模型再聪明,输出内容也是一个字一个字往外蹦。有没有一种可能:真正的 AGI 不是这样?
这是 AI 领域最重要的成果之一。
训不起2.8T的K3,玩够了124M的nanoGPT,想试试十亿参数、万亿token的预训练,门槛有多高?
过去几年,“基础模型” 已经彻底改变了自然语言处理和计算机视觉。一个很自然的问题随之出现: 物理世界是否也能拥有类似的基础模型?
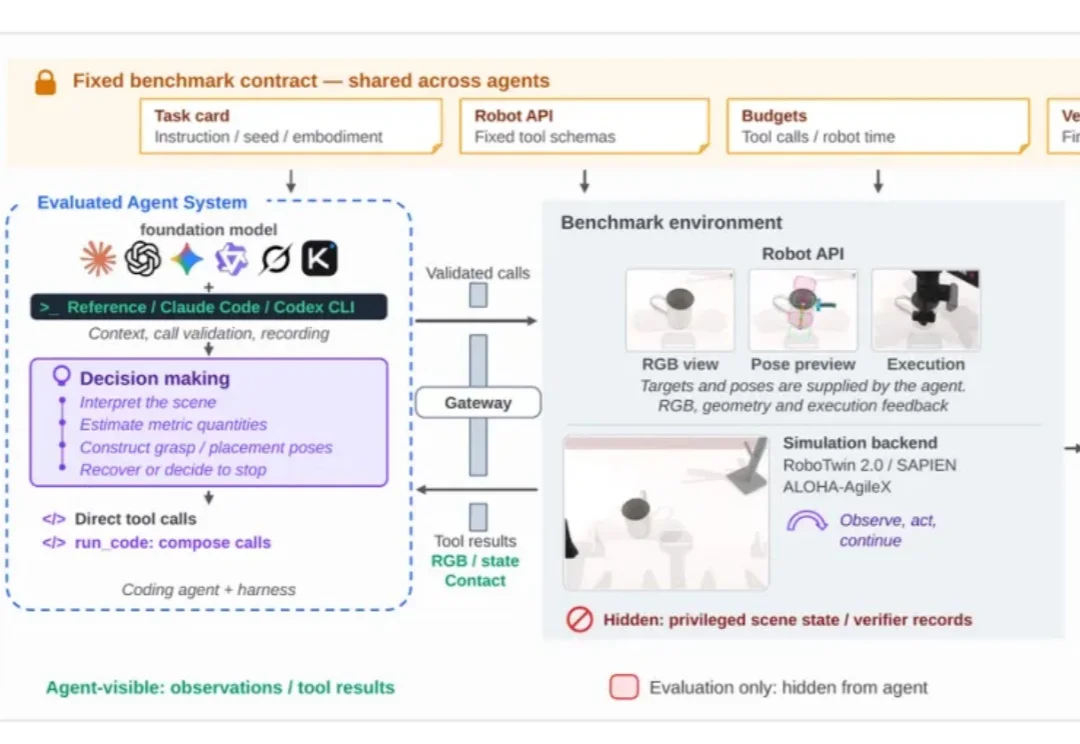
从视觉观察到策略生成,再到物理执行与完成判断,CodeActionBench 在统一条件下评测通用多模态 Agent 的机器人操作能力。在双臂仿真评测中,GPT-6 Astra (Codex CLI) 的尝试成功率达到 73.3%,Claude Opus 5 在 Reference harness 和 Claude Code 下分别取得 49.3% 和 45.3%。