肉眼看不出的幻觉?清华提出视觉源幻觉,仅用0.9%数据实现SOTA
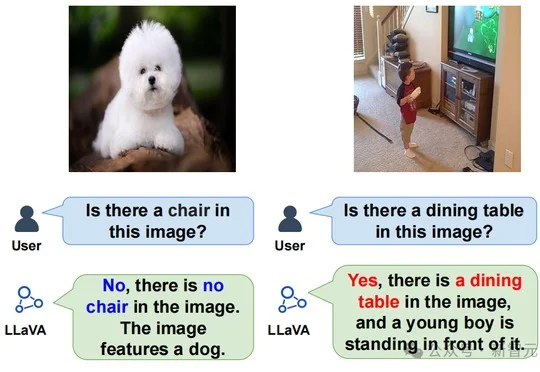
肉眼看不出的幻觉?清华提出视觉源幻觉,仅用0.9%数据实现SOTA新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
来自主题: AI技术研报
9562 点击 2026-09-20 15:07

 搜索
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
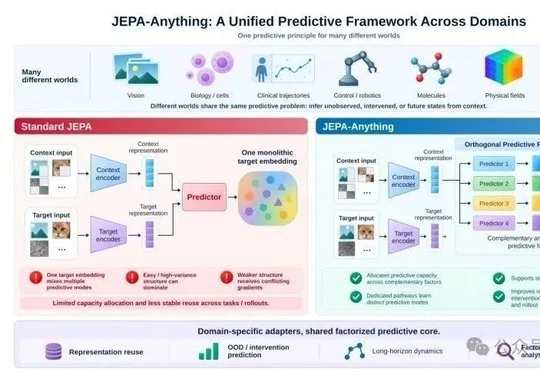
PhAI Labs联合牛津、斯坦福等高校推出跨领域预测框架JEPA-Anything,通过正交预测分解(OPF)机制将预测容量分配到多个互补子空间,并在视觉、生物、临床、控制、分子、物理场和天气七类系统中验证,同时在肝癌研究中从内部因子筛选出可实验验证的候选干预方案,在行星轨道模拟中提取出与开普勒第三定律高度吻合的尺度规律。
Memories.ai创始人沈俊潇在对话中阐述,记忆只是基础,公司真正聚焦于通过自建视频数据湖驱动物理AI实现"递归自我进化"(Physical RSI),其LVMM大型视觉记忆模型已与高通、英伟达达成合作,种子轮融资追加至1600万美元。
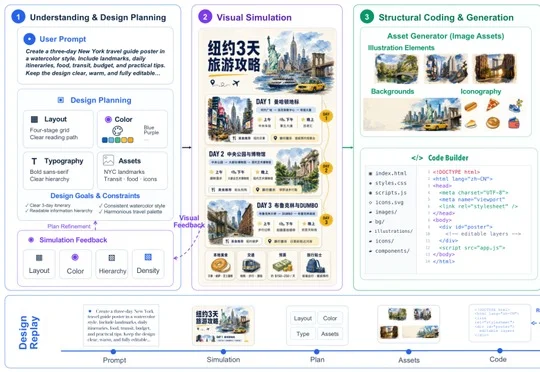
开源项目 Editable Design 结合视觉模型、HTML 代码与持续工作的 Agent,将 AI 生图重构为可编辑的设计文件,使文字可直接修改、图层可独立拖动,仓库展示了 14 组覆盖营销海报、信息设计等 6 类视觉任务的案例。
ArcLoop推出全栈AI故事引擎,围绕IP World统一管理角色、场景与视觉资产,解决AI漫剧长线连载中的角色一致性与世界观延续难题,创始人秦路此前在字节工作七年,公司已完成天使轮融资。
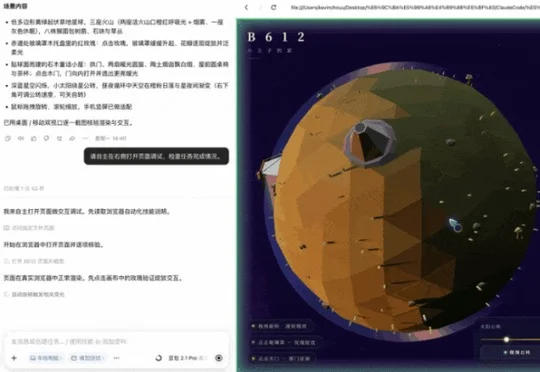
字节跳动发布新版豆包2.1 Pro(0915版本),重点升级多模态编程与视觉理解能力,可依据设计图、图纸和操作录屏生成代码,编辑团队通过山西3D旅行导览、小王子微缩星球等场景实测,验证其在Agent任务交付与Token效率方面的提升。
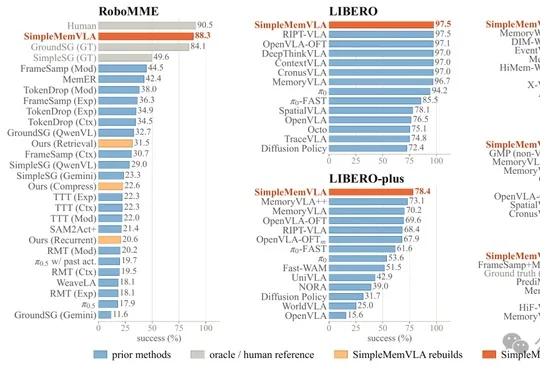
SimpleMemVLA由面壁智能联合华中科技大学等机构提出,将带时间戳的原生视觉历史直接作为机器人记忆上下文,在四项记忆基准取得SOTA并涌现视觉上下文学习能力,同时通过流式推理优化将60秒历史决策延迟从1.02秒降至0.68秒。
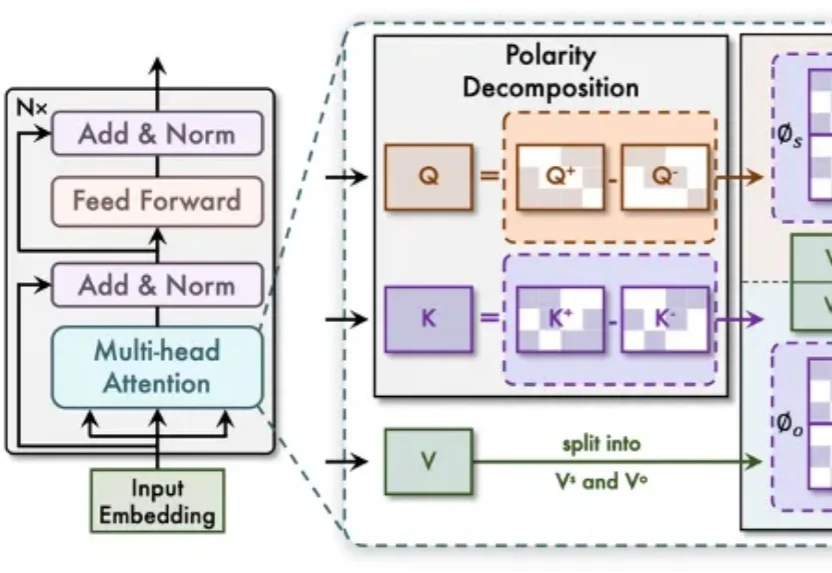
继 ICLR 2025 的 PolaFormer 之后,哈工大(深圳)与鹏城实验室合作的扩展版本 PolaFormer++ 近日被 IEEE TPAMI 正式接收。新版本在理论框架、特征映射设计和实验覆盖面上全面升级:首次给出判定特征映射是否具备「降熵尖锐性」的理论判据,并提出极性感知的通道级尖锐(PaCS)特征映射,在六大类视觉核心任务上全面验证了线性注意力的潜力。
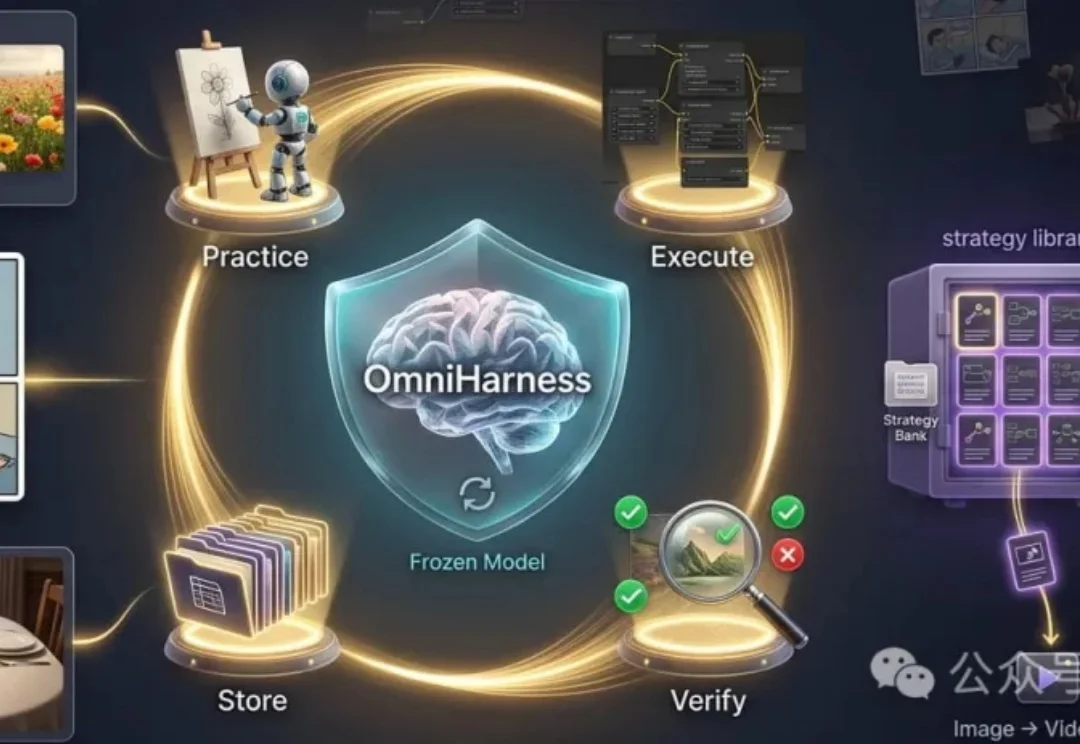
AI完成任务之后,还能留下什么?
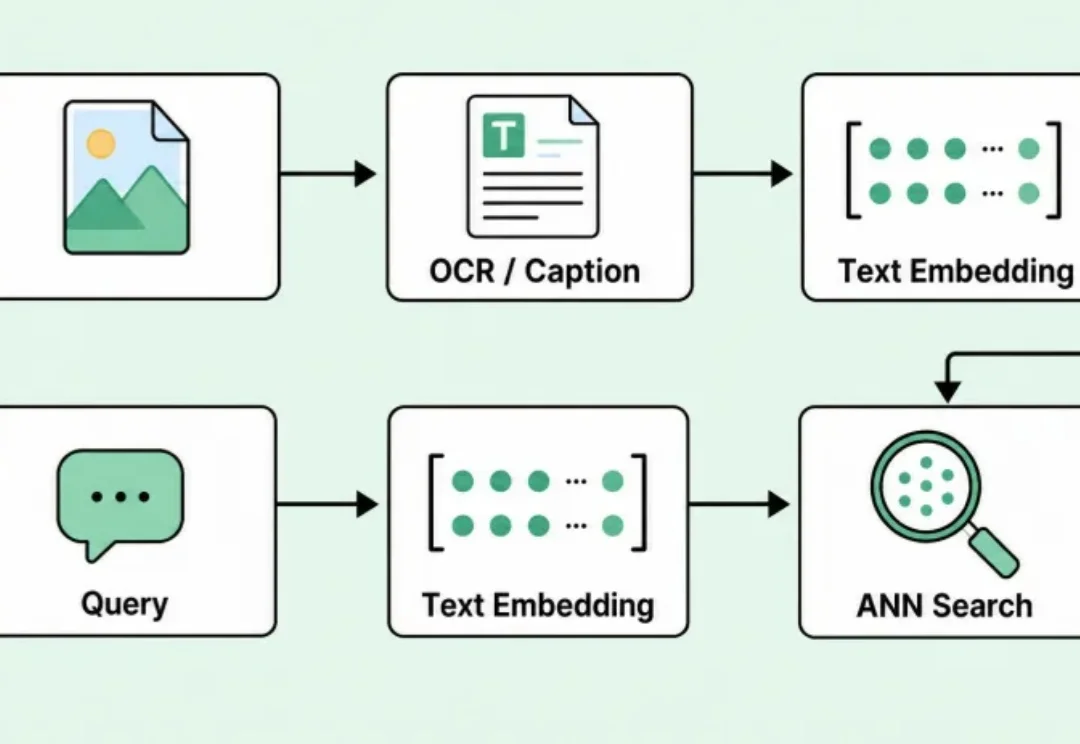
前不久,微信视觉团队开源了WeMM-Embedding。