系统学习Deep Research,这一篇综述就够了
系统学习Deep Research,这一篇综述就够了近年来,大模型的应用正从对话与创意写作,走向更加开放、复杂的研究型问题。尽管以检索增强生成(RAG)为代表的方法缓解了知识获取瓶颈,但其静态的 “一次检索 + 一次生成” 范式,难以支撑多步推理与长期
来自主题: AI技术研报
8903 点击 2026-01-02 15:01

 搜索
近年来,大模型的应用正从对话与创意写作,走向更加开放、复杂的研究型问题。尽管以检索增强生成(RAG)为代表的方法缓解了知识获取瓶颈,但其静态的 “一次检索 + 一次生成” 范式,难以支撑多步推理与长期

2026年,Scaling Law是否还能继续玩下去?对于这个问题,一篇来自DeepMind华人研究员的万字长文在社交网络火了:Scaling Law没死!算力依然就是正义,AGI才刚刚上路。
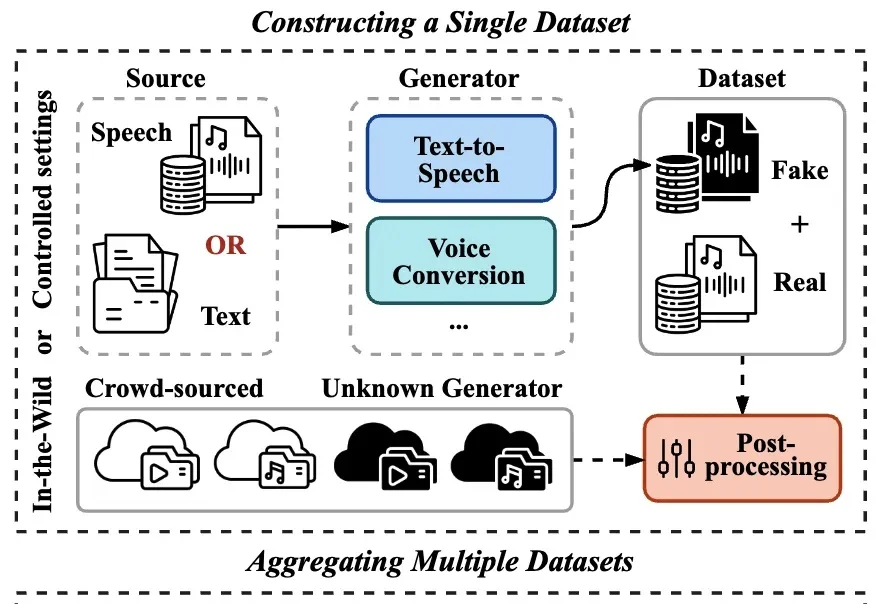
在生成式 AI 技术日新月异的背景下,合成语音的逼真度已达到真假难辨的水平,随之而来的语音欺诈与信息伪造风险也愈演愈烈。作为应对手段,语音鉴伪技术已成为信息安全领域的研究重心。
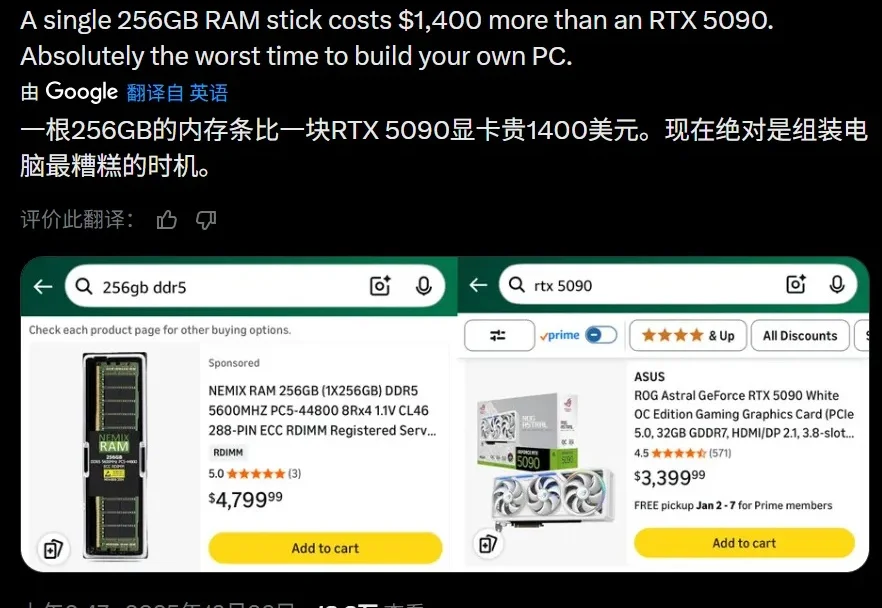
「我一直在告诉大家,如果你想买(电子)设备,现在就买。我自己要买的 iPhone 17 就已经下手了。」这是咨询公司 TrendForce 高级研究副总裁 Avril Wu 在最近接受采访时说的一句话。
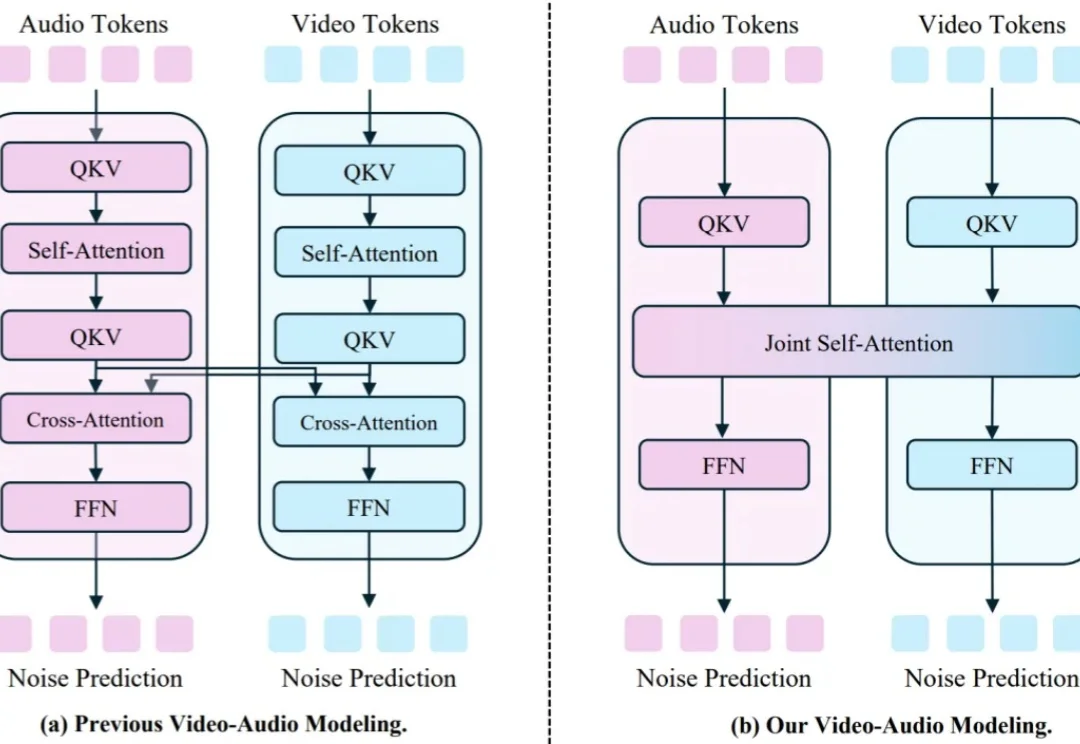
视频 - 音频联合生成的研究近期在开源与闭源社区都备受关注,其中,如何生成音视频对齐的内容是研究的重点。
在电影与虚拟制作中,「看清一个人」从来不是看清某一帧。导演通过镜头运动与光线变化,让观众在不同视角、不同光照条件下逐步建立对一个角色的完整认知。然而,在当前大量 customizing video generation model 的研究中,这个最基本的事实,却往往被忽视。
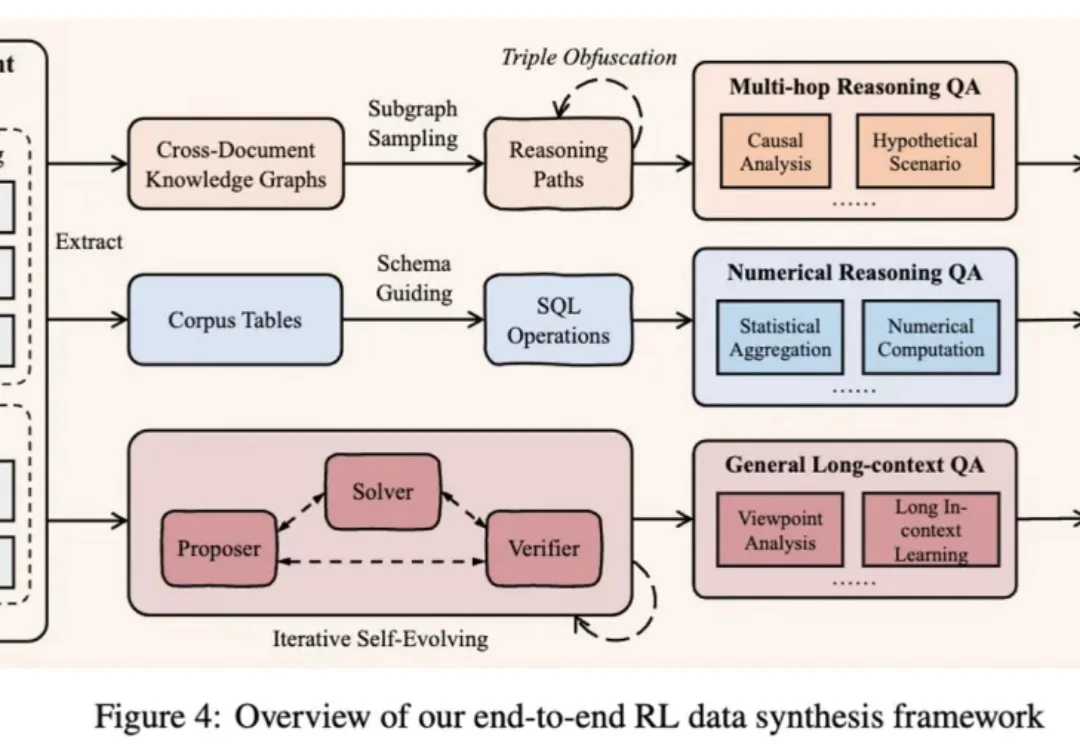
作为大模型从业者或研究员的你,是否也曾为一个模型的 “长文本能力” 而兴奋,却在实际应用中发现它并没有想象中那么智能?
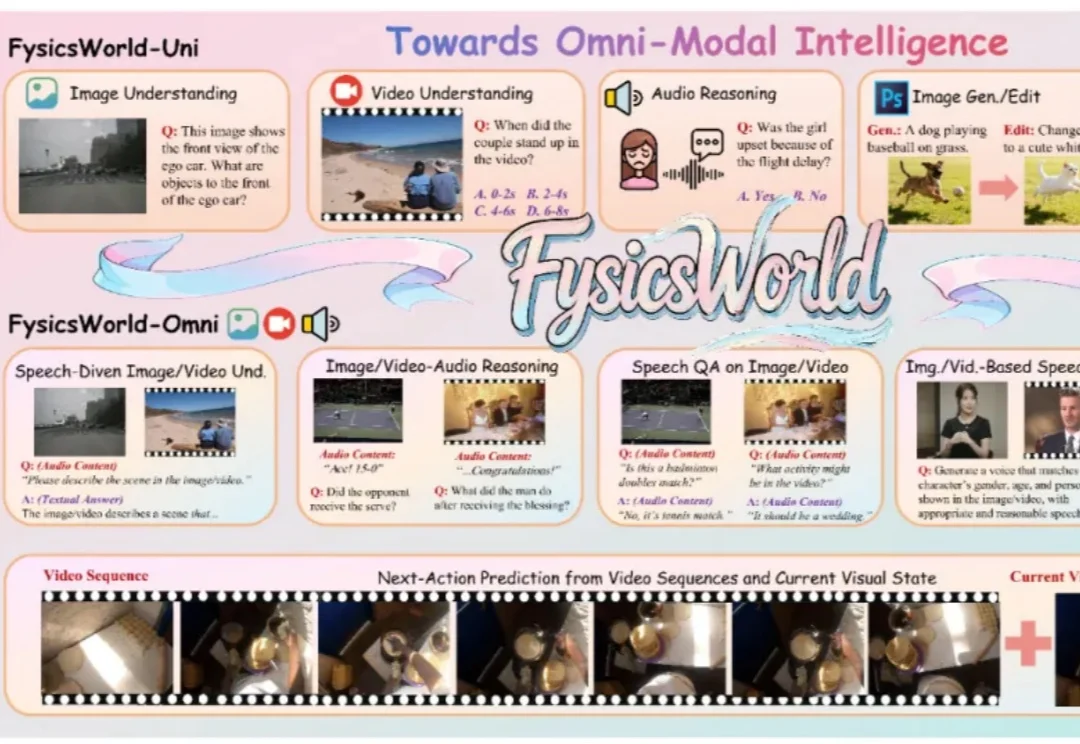
近年来,多模态大语言模型正在经历一场快速的范式转变,新兴研究聚焦于构建能够联合处理和生成跨语言、视觉、音频以及其他潜在感官模态信息的统一全模态大模型。此类模型的目标不仅是感知全模态内容,还要将视觉理解和生成整合到统一架构中,从而实现模态间的协同交互。
近日,部分L3级自动驾驶车型已经通过工信部批准正式上路,这标志着这我国自动驾驶产业的新阶段。
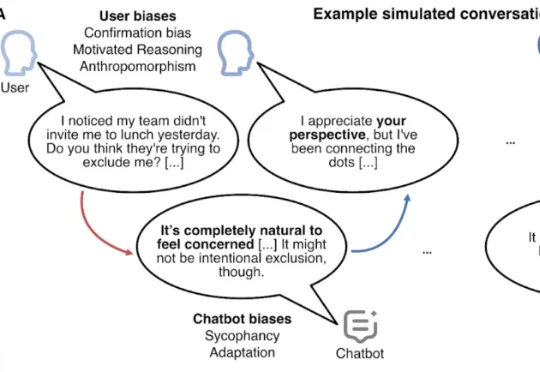
加州大学旧金山分校的一项最新研究,剖析了一名26岁的医护人员在与AI聊天的过程中发生急性精神病的案例。康复后仅3个月,这名医护人员再次因AI聊天产生妄想、精神失常。